集合框架
介绍一下HashMap。
(扩容机制、寻址、为什么扩容是二倍),什么要选红黑树;可以用跳表来替换红黑树吗
什么时候触发扩容:
- 当size >= capicity * threshhold会触发一次扩容
- 当链表的长度>=8, 并且数组长度< 64时也会触发一次扩容。
HashMap中怎样解决hash冲突。
1.解决Hash冲突的方法有四种
开放定址法也称线性探测法,就是从发生冲突的那个位置开始,按照一定次序从Hash表找到一个空闲位置然后把发生冲突的元素存入到这个位置,而在java中,ThreadLocal就用到了线性探测法来解决Hash冲突
2.链式寻址法,这是一种常见的方法,简单理解就是把存在Hash冲突的key,以单向链表来进行存储,比如HashMap
3.再Hash法,就是通过某个Hash函数计算的key,存在冲突的时候,再用另外一个Hash函数对这个可以进行Hash,一直运算,直到不再产生冲突为止,这种方式会增加计算的一个时间,性能上呢会有一些影响
hashMap用红黑树,不用平衡二叉树?
有人专门测过,在处理大数据量的时候,平衡二叉树和红黑树效率几乎差不多,他俩区别在于,红黑树在不平衡时调整树节点的效率和操作比AVL要更好设计和实现
HashMap扩容时链表转红黑树的阈值为什么是8?退化为6的原因?
链表转红黑树阈值(TREEIFY_THRESHOLD = 8)
- HashMap 默认情况:
- 每个桶(bucket)初始是链表(LinkedList)
- 当链表长度达到 8,会尝试转成 红黑树(TreeNode)
- 这样查找复杂度从 O(n) 降到 O(log n)
为什么是 8 而不是 4 或 16?
- 平衡空间和性能:
- 链表长度太短 → 红黑树额外开销大(Node 节点更多,维护红黑树平衡需要旋转)
- 链表长度太长 → 查询效率下降(O(n))
- 实测经验:
- 链表长度 8 以上才值得用红黑树
- Java 8 官方设计 TREEIFY_THRESHOLD = 8
红黑树退化为链表的阈值(UNTREEIFY_THRESHOLD = 6)
- 红黑树在 HashMap 中:
- 如果经过删除操作,节点减少,长度小于 6,会退回链表
- 原因:
- 节省内存:红黑树节点比链表节点内存开销大(Node 还需要 parent、left、right、color 字段)
- 性能考虑:
- 节点太少 → 红黑树旋转维护成本比链表查找成本高
- 小于 6 节点 → 链表遍历比红黑树更快
ArrayList和LinkedList的区别?ArrayList的扩容机制?ArrayList动态数组,怎么分配内存,数据在内存里连续吗
1.区别
ArrayList:ArrayList基于动态数组实现,内部维护一个Object数组,默认初始容量为10,当元素数量超过当前容量时会自动扩容。
LinkedList:LinkedList基于双向链表实现,每个节点包含数据元素和指向前后节点的引用。
2.扩容机制
扩容的核心方法是 grow(int minCapacity)。下面是扩容的大致过程:
- 计算新容量:
新容量一般为原容量的 1.5 倍,即oldCapacity + (oldCapacity >> 1)。如果这个值仍然不足以容纳minCapacity个元素,那么新容量将被设置为minCapacity。 - 检查是否超过最大容量:
如果新容量超过了MAX_ARRAY_SIZE,则新容量将被设置为Integer.MAX_VALUE。这是由于数组的最大长度是Integer.MAX_VALUE。 - 创建新数组并复制元素:
利用Arrays.copyOf创建一个新的数组,并将原数组中的元素复制到新数组中。 - 替换原数组:
将elementData指向新的数组。
concurrenthashmap的底层原理(一文彻底弄懂ConcurrentHashMap,轻松应对面试官!ConcurrentHashMap是HashMap的线程 - 掘金)
1.ConcurrentHashMap和HashMap以及Hashtable的区别
1.1 HashMap
HashMap是线程不安全的,因为HashMap中操作都没有加锁,因此在多线程环境下会导致数据覆盖之类的问题,所以,在多线程中使用HashMap是会抛出异常的。
1.2 HashTable
HashTable是线程安全的,但是HashTable只是单纯的在put()方法上加上synchronized。保证插入时阻塞其他线程的插入操作。虽然安全,但因为设计简单,所以性能低下。
1.3 ConcurrentHashMap
ConcurrentHashMap是线程安全的,ConcurrentHashMap并非锁住整个方法,而是通过原子操作和局部加锁的方法保证了多线程的线程安全,且尽可能减少了性能损耗。
由此可见,HashTable可真是一无是处…
2.ConcurrentHashMap原理
2.1 volatile修饰的节点数组
1 | |
2.2 put方法
jdk8 中的 ConcurrentHashMap 数据结构同 jdk8 中的 HashMap 数据结构一样,都是 数组+链表+红黑树。摒弃了 jdk7 中的分段锁设计,使用了 Node + CAS + Synchronized 来保证线程安全。
1 | |
小结 put :
- 先校验一个 k 和 v 都不可为空。
- 判断 table 是否为空,如果为空就进入初始化阶段。
- 如果发现插入位置的 bucket 为空,CAS直接把键值对插入到这个桶中作为头节点,如果CAS失败,则进入下次循环
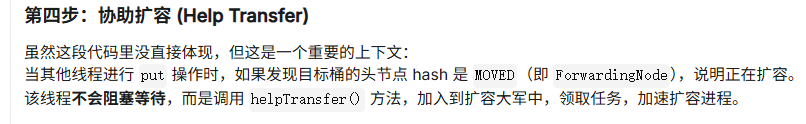
- 如果这个要插入的桶中的 hash 值为 - 1,也就是 MOVED 状态(也就是这个节点是 forwordingNode ),那就是说明有线程正在进行扩容操作,那么当前线程就进入协助扩容阶段。
- 如果这个节点是一个链表节点,根据 key 匹配结果去决定是插入还是覆盖,插入是用尾插法。如果这个节点是一个红黑树节点,那就需要按照树的插入规则进行插入。
- 插入结束之后判断该链表节点个数是否到达8,如果是就把链表转化为红黑树存储。
- put 结束之后,需要给 map 已存储的数量 +1,在 addCount 方法中判断是否需要扩容。
1 | |
通读了putVal之后,我们比较关注其中一些方法:
tabAt方法是通过Unsafe类根据偏移量直接从内存中获取数据,避免了从高速缓冲区获得了过期数据casTabAt方法主要通过Unsafe类直接操作内存,通过比较交换赋值,该操作不用加锁,所以可以提高操作效率
1 | |
initTable方法初始化 map 中的底层数组
1 | |
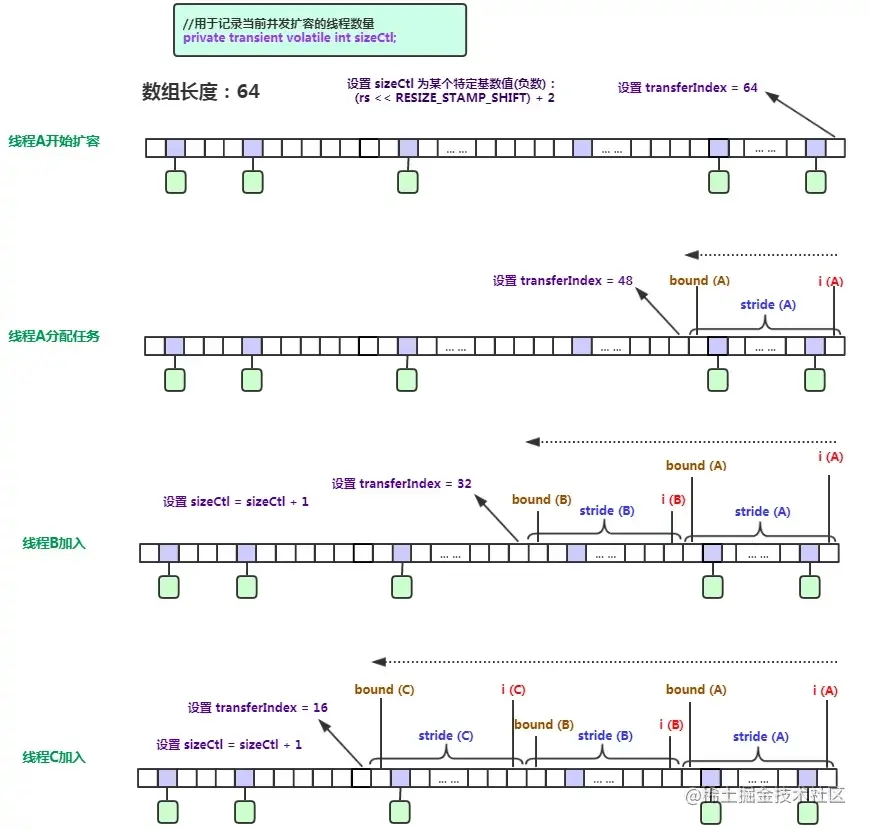
transfer 方法逻辑比较复杂,请读者结合注释和配图耐心理解
1 | |
- 多线程开始扩容
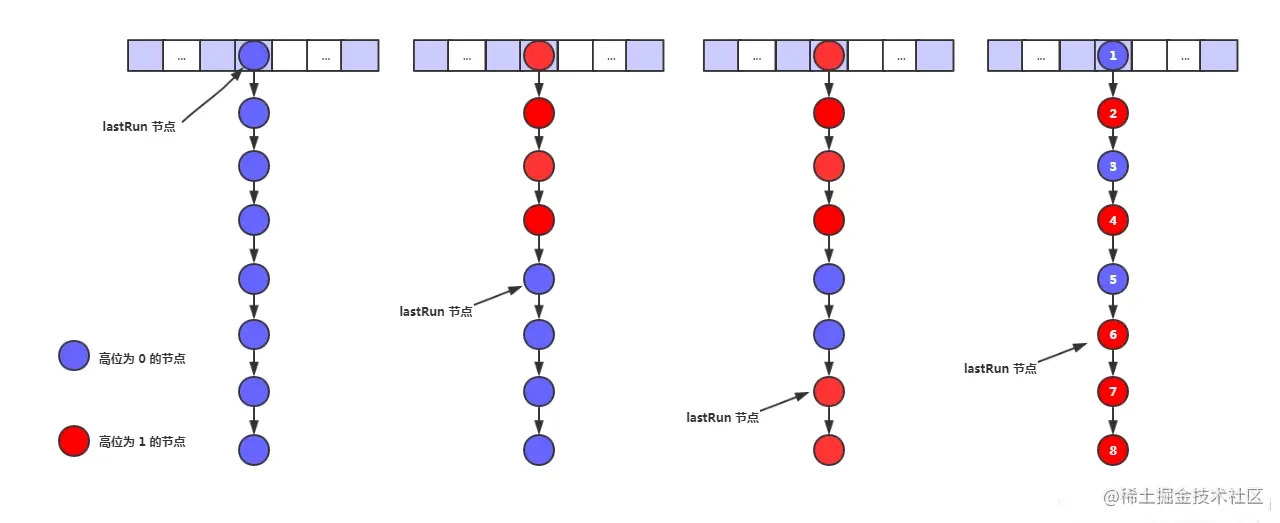
- lastrun节点
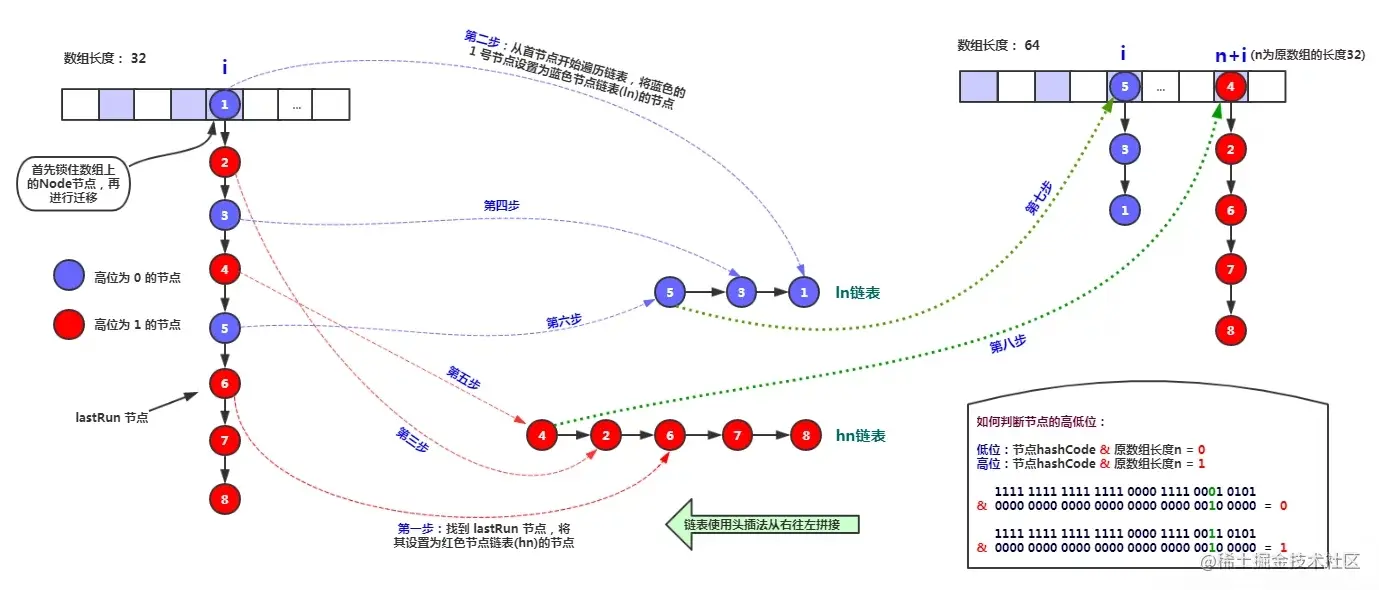
- 链表迁移
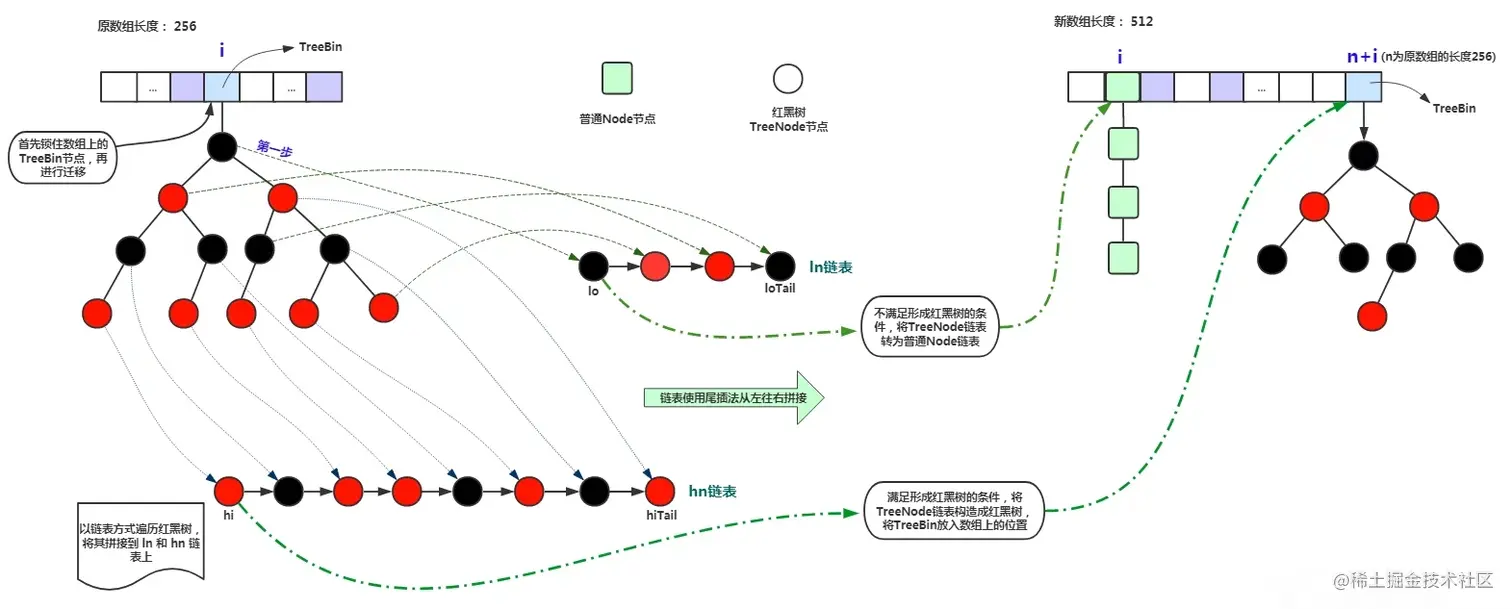
- 红黑树迁移
- 迁移过程中get和put的操作的处理
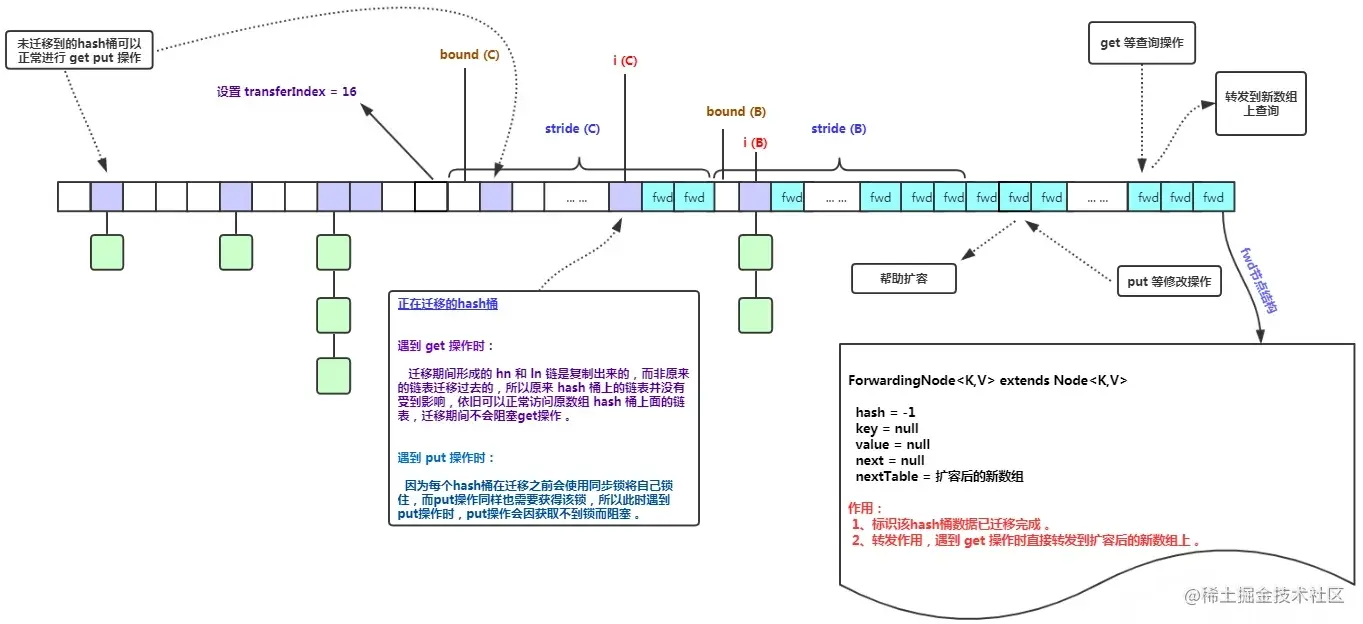
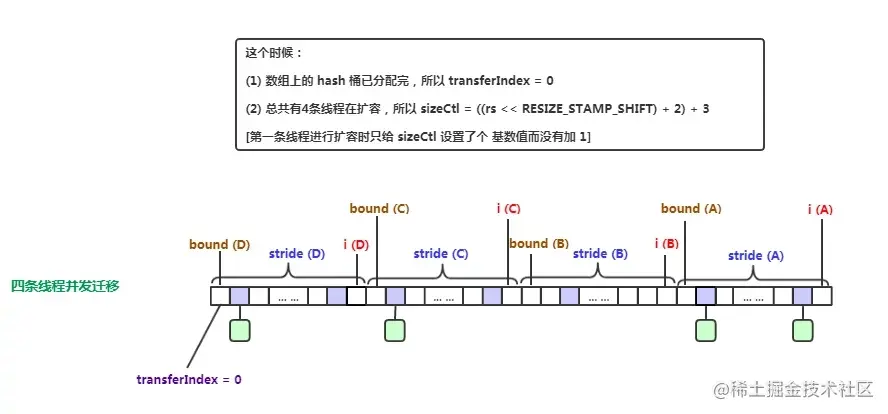
- 并发迁移
- 迁移完成
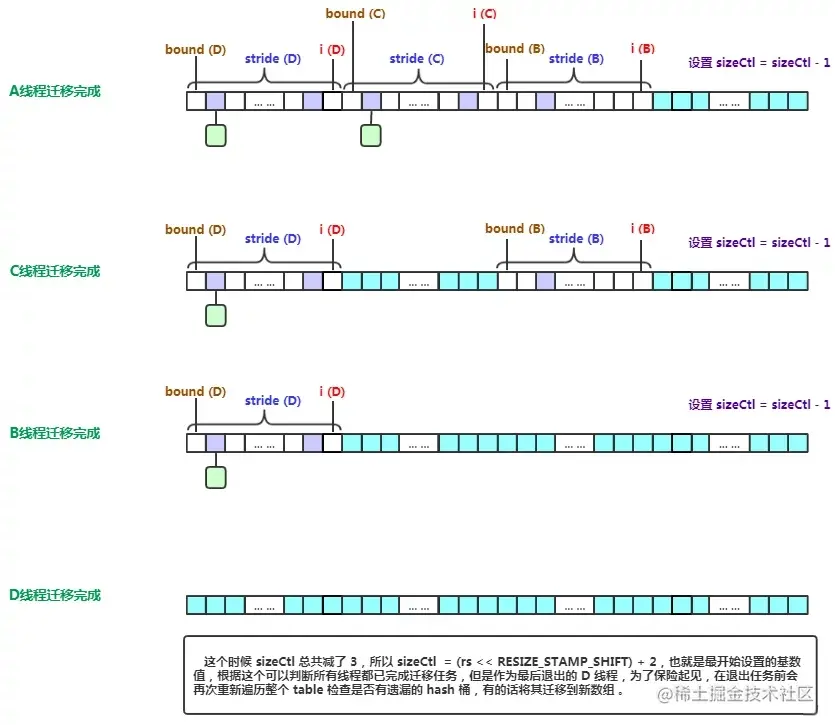
小结 transfer:
- 根据 CPU 核心数确定每个线程负责的桶数,默认每个线程16个桶
- 创建新数组,长度是原来数组的两倍
- 分配好当前线程负责的桶区域 [bound, nextIndex)
- 并发迁移,根据链表和红黑树执行不同迁移策略
- 迁移完成,设置新的数组和新的扩容阈值
注:ForwardingNode会保存新数组的引用,新数组的hash都为MOVED,他采用的复制方法实现迁移,例如tab[i]迁移完成,tab[i]的链表还是有的,ForwardingNode的新数组nextTab[i]和nextTab[i+n]也有,他会再某个桶迁移完成后,比如tab[i]完成后会把 tab[i] 整个槽位的引用替换为了一个新的 ForwardingNode 对象(fwd),这个 fwd 自己的 hash 值是 -1。这里的ForwardingNode 是一个Node节点,hash=-1,只不过每个Node维护了一个新数组的引用。
例如
1 | |
再遍历到数组tab[i]时他执行了fwd节点,hash=-1。
setTabAt(tab, i, fwd) 的意思是:把 tab[i] 这个槽位替换为一个新的节点 fwd,它是 ForwardingNode,它的 hash 是 -1,不是修改原节点,而是彻底换掉原节点。
其它重要集合知识点(补充)
Collections 工具类
sort/binarySearch:依赖元素实现Comparable或传入Comparator;binarySearch前集合必须已按同一比较规则有序。shuffle、reverse、rotate、fill:原地修改指定List。synchronizedXxx与checkedXxx:同步包装器在方法级加锁,并发性能一般;checked可在运行时检查是否误插类型(泛型擦除场景下的调试辅助)。unmodifiableXxx:返回不可修改视图,底层仍指向原集合;若原集合后续被修改,视图内容也会变,只是不能通过视图自身去增删。
迭代:fail-fast 与 fail-safe
ArrayList、HashMap等:迭代中若检测到结构性修改(非迭代器自身的remove),会抛ConcurrentModificationException,依赖modCount与expectedModCount。CopyOnWriteArrayList:迭代基于快照,弱一致、不抛上述异常,适合读多写少;写时复制整段数组,写频繁时成本高。
Queue / Deque 常见实现
| 类 | 要点 |
|---|---|
PriorityQueue |
小顶堆(默认),非线程安全;迭代顺序不等于优先级顺序,应按 poll 取。 |
ArrayDeque |
双端队列,无容量上限时可作栈/队列;禁止 null;通常比 LinkedList 栈更省内存与缓存友好。 |
LinkedList |
实现 Deque,节点分散,随机访问差;若主要当栈/队列且元素多,可优先考虑 ArrayDeque。 |
阻塞队列(java.util.concurrent)(常与线程池、生产者消费者配合):
ArrayBlockingQueue:有界数组,一把锁或分离锁实现因版本而异,适合固定容量背压。LinkedBlockingQueue:可选有界/默认近似无界,注意默认容量为Integer.MAX_VALUE时可能堆积导致内存风险。SynchronousQueue:不缓存元素,put直到有线程take;适合直接交接任务。DelayQueue:元素需实现Delayed,按到期时间出队,用于定时任务、缓存过期等。
Set 与有序性
HashSet:内部是HashMap,元素即 key,value为固定占位对象;无序、允许null(一个)。LinkedHashSet:在HashSet基础上维护插入顺序的双向链表;适合需要稳定遍历顺序的去重场景。TreeSet:基于TreeMap(红黑树),按Comparable/Comparator全序;首元素插入时即确定比较规则,混用会ClassCastException;null依赖比较器是否支持。
Map 扩展
LinkedHashMap:可配置插入序或访问序(accessOrder=true时用于 LRU 缓存模式,常配合removeEldestEntry)。TreeMap:按键有序,NavigableMap支持ceilingKey、floorKey等区间导航。EnumMap:键为枚举类型,数组实现,紧凑高效,不允许null键。WeakHashMap:键为弱引用,适合缓存/元数据随 GC 回收,注意强引用键仍会一直存活。IdentityHashMap:用==判等而非equals,用于对象图序列化、调试等少数场景。
常见坑
Arrays.asList:返回固定大小的List视图,不能add/remove;若元素是基本类型数组,会把整个数组当成一个元素(常见 bug)。subList:返回原List的视图,对subList的结构修改会写回原列表;原列表在子列表存活期间若被结构性修改,再操作子列表可能未定义行为或异常。
1 | |
Comparable 与 Comparator
- 类内自然序用
Comparable<T>;多种排序规则或无法改源码时用Comparator<T>。 TreeSet/TreeMap/PriorityQueue的排序规则在运行期应一致,避免比较器与equals语义严重不一致导致集合契约被破坏(文档建议compare与equals一致)。
CopyOnWriteArrayList(专节小结)
java.util.concurrent.CopyOnWriteArrayList 是线程安全的 List 实现,适合读远多于写、且能接受弱一致性与写放大的场景。
核心机制:写时复制(Copy-On-Write)
- 底层维护
volatile的Object[]数组;读操作(get、iterator等)通常不加锁,直接在当前数组上访问。 - 写操作(
add、set、remove等)时:复制一份新数组,在新数组上修改,再用原子方式把引用切到新数组(读线程仍可能短时间看到旧快照)。 - 单次写的代价与当前长度近似线性相关:列表很大时,一次
add也可能复制整表,写频繁会非常重。
迭代器与一致性
- 迭代器基于创建时刻的快照(
COWIterator),遍历的是当时的数组引用,不会因其他线程并发增删而抛ConcurrentModificationException。 - 弱一致:迭代过程中若别的线程写入,本次迭代未必能看到新元素;也可能仍看到已逻辑删除的数据直到下一次写完成切换(语义以 JDK 文档为准:反映某时刻数组视图)。
Iterator.remove/ListIterator的结构性修改不支持(会抛UnsupportedOperationException);需要删改请走集合自身 API。
与 Vector、Collections.synchronizedList 对比(取舍)
| 维度 | CopyOnWriteArrayList |
Vector / synchronizedList |
|---|---|---|
| 读 | 一般无锁读数组,并发读扩展性好 | 读也常要锁,竞争激烈时易抖 |
| 写 | 复制整表,写少合适 | 锁粒度粗(Vector 方法级锁),写多也未必优 |
| 迭代 | 快照迭代,失败安全(不 CME) | 需外部同步或仍可能 CME(ArrayList 包装) |
| 内存 | 写时双份数组短暂存在,瞬时内存尖峰 | 无整表复制,但锁竞争成本在别处 |
适用场景(经验法则)
- 监听器 / 观察者列表、配置或规则集读多、偶尔全量替换或少量追加。
- 遍历远多于修改且希望读线程不被写锁拖慢。
- 不适合:写密集、列表特别大、对「写完立刻被所有线程读到」有强实时要求的场景(应另选并发结构或加版本号/发布语义)。
使用注意
- 元素若会被多线程同时读到「中间态」,仍要保证对象自身的线程安全或不可变性;COW 只解决容器引用切换,不替你保证元素字段安全。
equals/hashCode若用于放入依赖语义的容器,元素规范仍应满足自反、一致等约定。- 若需频繁中间插入/删除,时间复杂度与复制成本都会很差,应换结构(如分段、队列或别的并发集合)。
1 | |
面试高频补充(集合)
下列多为口述题/追问点,与上文 HashMap、CHM、List、队列 互补;答题时抓住关键词即可。
equals 与 hashCode(必背契约)
- 契约:
equals相等的两个对象hashCode必须相同;hashCode相同equals未必为真(哈希碰撞)。 - HashMap / HashSet:先算桶下标依赖
hashCode,再在桶内用equals判等;只重写equals不重写hashCode会导致存了却 get 不到、Set 去重失效。 - 可变对象作 key:若参与
hash的字段被改,可能再也找不到原条目,一般不推荐把可变对象当HashMap的 key。
1 | |
HashMap 寻址:容量为 2 的幂与扰动
- 容量为 2 的幂时,下标可用
(n - 1) & hash代替取模,位运算快;扩容时元素要么在原下标,要么在原下标 + 旧容量(高低位拆分,利于迁移)。 hash扰动(高 16 位与低 16 位异或):让低位更「散」,减少仅靠低位导致的热点桶(口述「减少碰撞」即可)。
JDK7 / JDK8 扩容与并发(一句话版)
- JDK7:头插法扩容迁移链表,多线程并发扩容可能形成环形链表,
get死循环(考点:为何别在多线程写 JDK7 HashMap)。 - JDK8:链表改为尾插,并配合上述迁移逻辑;仍非线程安全,多线程
put可能丢数据、size不准,只是不再用「死链」那个经典模型来考。
null 与线程安全容器
HashMap:允许nullkey(至多一个) 与多个nullvalue。Hashtable/ConcurrentHashMap:不允许nullkey / value(CHM 语义上避免二义性:无法区分「没放进去」与「放了 null」的并发可见问题,口述即可)。
fail-fast 再记一句
- 对
ArrayList等:除Iterator.remove()(以及ListIterator在支持结构上的合法操作)外,迭代中结构性修改集合本体 →ConcurrentModificationException。
PriorityQueue
- 底层二叉小顶堆(默认);
peek看堆顶不删,poll删堆顶。 add逐个插入与heapify批量建堆:批量从无序数组建堆可 O(n),常考「不是每次插入都算 O(log n) 叠加成 O(n log n) 建堆」的辨析。
并发有序:ConcurrentSkipListMap / ConcurrentSkipListSet
- 跳表实现,线程安全且按键有序;
Comparator或元素Comparable要自洽,不允许nullkey(null无法参与比较)。 - 与
ConcurrentHashMap对比:CHM 无序、一般读写更均衡;SkipList 有序、写略重,适合并发下需排序/范围查询。
ConcurrentLinkedQueue
- 无锁链表(CAS),高并发入队出队常用;
size()需遍历,O(n) 且仅近似,面试常问「为何生产环境别频繁调size做判断」。
工程常数
HashMap默认负载因子 0.75:时间/空间折中(泊松分布推导是加分项,答「经验 + 统计」即可)。ArrayList默认容量 10:指第一次扩容触发后的常见实现语义,口述「懒初始化」有的版本细节以 JDK 为准。