Skills
本篇由「面试遇到的问题」拆解合并而来,保留原文与图片。原与 Agent、RAG、Skills 等同篇,现拆为独立文章。下文各 ## 为原面试小节标题。
Skills
如何解决tools过多的问题(路由Agent+专家Agent+检索Tool+Skills)
方案一:硬编码路由(Router)—— 简单粗暴,适用于领域明确的场景
这是最基础的分治思想。不要让一个 Agent 掌握所有工具。
- 做法:在最顶层设置一个“路由 Agent”或一个简单的意图分类模型。这个路由器的任务只有一个:判断用户的意图属于哪个领域。
- 例子:如果识别出用户意图是“查天气”,就只把天气查询工具的定义传给下游的执行 Agent。如果是“订机票”,就只传机票查询和支付工具。
- 优点:实现简单,能快速解决问题。
- 缺点:非常僵化。如果用户提了一个跨领域的问题(“帮我查下北京的天气,然后订一张去那的机票”),路由器就懵了。
方案二:层级 Agent 架构(Hierarchical Agents)—— 模拟人类组织架构
这是多 Agent 框架(如 AutoGen、CrewAI)的核心思想。让不同的 Agent 成为特定领域的“专家”。
- 做法:
- 创建一个**“经理(Manager)Agent”**,它手里不掌握任何具体干活的工具。
- 创建多个**“专家(Expert)Agent”**,比如财务Agent、HR Agent、IT运维Agent。
- 每个专家 Agent 只掌握自己领域内的一小撮(3-5个)高度相关的工具。
- 经理 Agent 的“工具”就是它的下属。当它接到任务后,会分析该把任务**委派(Delegate)**给哪个专家。
- 优点:架构清晰,扩展性强,完美符合“高内聚、低耦合”的软件设计原则。
- 缺点:增加了 Agent 之间通信的复杂度和潜在的延迟。
方案三:动态工具检索(Tool Retrieval via RAG)—— 目前工业界的“版本答案”
这是解决大规模工具集问题的最主流、最优雅的方案。它把“选工具”这件事,本身也变成了一个检索任务。
- 核心思想:不要把所有工具都给 LLM。先用一个轻量级的方法,从海量工具库里**“捞”**出几个最可能用到的,再把这几个喂给 LLM。
- 具体做法:
- 建立“工具库”索引:把所有(100个)工具的名称和**功能描述(Description)**进行向量化,存入一个专门的向量数据库(Vector DB)。
- 第一轮检索(预筛选):当用户提问时(比如:“帮我查一下张三上周五的打卡记录”),系统首先把用户的这个问题向量化。
- 召回最相关工具:用这个查询向量,去工具向量库里进行一次语义相似度搜索,找出 Top-K(比如 Top-3)最相关的工具,可能召回的是 query_attendance(查询考勤)、get_employee_info(获取员工信息)。
- 第二轮执行(精准调用):系统只把这 3 个被精准召回的工具的完整定义,连同用户的原始问题,一起拼接成 Prompt 发给大语言模型。
- 优点:极其灵活和可扩展。无论你有 100 个还是 10000 个工具,LLM 每次看到的都只是最相关的几个,既省钱又精准。
方案四:API 聚合与标准化(后端工程优化)
这是从根源上减少工具数量的软件工程最佳实践。
- 做法:推动后端团队优化 API 设计。不要提供一堆原子化的、细碎的接口。
- 例子:不要提供获取用户名、获取用户邮箱、获取用户部门三个独立的工具。而是提供一个统一的查询用户信息(user_id, fields=[“name”, “email”])工具。
- 优点:从根本上降低了工具管理的复杂度,是前面三种方案的基石
写过 SKILL 吗?有什么注意事项?如何确保 SKILL 的稳定、安全和可靠?
“我不仅写过 Skills,而且在将 Skills 推向生产环境时,我深刻体会到:把 Skill 写出来让它能跑通很简单,但要让它在不可控的大模型面前稳定、安全地运行,才是真正的挑战。
因为我们必须假设:大模型是极其聪明但完全不可信的。它随时可能产生幻觉,瞎造参数,甚至被恶意用户诱导发起攻击。
因此,我在设计和编写 Skill 时,会严格遵循以下几个维度的注意事项和保障机制:
1. 描述与意图层:极其精确的 Prompt Engineering(防止模型调用错)
- 痛点: 如果你把一个查天气的工具命名为 get_info,大模型遇到任何问题都可能去调它,导致无限的无效调用。
- 对策:
- 见名知意: Skill 的名称必须像 RESTful API 一样精准,如 get_weather_by_city。
- 详尽的 Description: 在提供给 LLM 的工具描述中,不仅要写它‘能做什么’,还要明确写出它‘不能做什么’,以及‘什么时候应该调用它’。
- 提供 Few-Shot 示例: 最好在描述里给出 1-2 个正确调用的例子,大模型对这种模式匹配非常敏感。
2. 参数输入层:强类型的 JSON Schema 约束与拦截(防止模型瞎传参)
- 痛点: 模型经常会漏掉必填参数,或者把整数 10 传成字符串 “ten”,导致后端代码直接抛出空指针或类型转换异常。
- 对策(防御性编程的第一道防线):
- 严格的 Schema 定义: 必须使用 OpenAPI 规范的 JSON Schema 严格定义每个参数。能用 enum(枚举)的绝不用 string;明确标记哪些是 required。
- 本地强校验拦截: 在收到大模型的调用指令后,绝对不能直接扔给底层业务代码执行。我会在本地中间层(如 Python 的 Pydantic 或 Java 的 Hibernate Validator)进行强类型校验。
- 错误反馈闭环: 如果校验失败,系统不会直接崩溃。我会捕获具体的错误信息(如“age 参数必须是数字”),把它作为系统消息喂回给大模型,让模型根据报错信息自我反思并重新生成正确的参数。
3. 执行容错层:幂等性与沙箱隔离(防止系统崩溃)
- 痛点: 因为网络抖动或模型抽风,同一个写操作(如扣款)的 Skill 可能会被大模型连续调用多次。
- 对策:
- 强幂等性设计: 所有涉及到数据修改的 Skill(如 create_order),其底层业务代码必须是幂等的。通常要求模型在调用时传入一个基于用户意图生成的唯一 Request ID(或者后端根据上下文生成防重 Token)。
- 异常捕获与友好返回: 即使底层 API 挂了或超时,Skill 代码也必须捕获所有异常,并向大模型返回一段友好的自然语言错误信息(如“抱歉,订单系统暂时无响应”),而不是把几百行的 Java 堆栈报错扔给模型,那会让模型彻底懵掉甚至陷入死循环。
4. 安全红线层:最小权限与“断点确认”(防止越权与资产损失)
这是企业级 Agent 落地的底线。
- 对策:
- 最小特权原则 (Least Privilege): 执行 Skill 的后端服务,其连接数据库的账号或持有的 Token,必须限制为满足该任务的最小权限(如只读权限,或只能访问当前租户的数据),从物理上隔绝 SQL 注入等毁灭性风险。
- 敏感操作的人机协同 (Human-in-the-Loop): 这是防范越权的最有效手段。对于修改密码、大额转账、删除核心数据等敏感 Skill,Agent 绝对不能拥有最终的自动化执行权。当 Agent 决定调用该 Skill 并准备好参数后,系统必须强制挂起(Suspend)。在前端弹出一个确认卡片,只有当真实的物理用户点击“确认授权”后,后端才会真正放行这段代码的执行。
skills了解吗
“嗯,我非常了解。在构建企业级 Agent 平台时,引入 Skill(技能) 这个概念是非常关键的架构演进。
简单来说,Tool 是提供给大模型的‘基础动作’,而 Skill 是封装好的‘业务能力’。
首先,在定义上:
Tool(工具)通常就是一个单一的 API,比如‘查询某个订单号的状态’或者‘获取某天的天气’。
但如果我们要让 Agent 完成一个复杂的任务,比如‘分析上个月的销售异常’,你不能直接把 10 个底层的数据库查询 Tool 扔给大模型让它自己去排列组合。因为当 Tool 的数量超过一定阈值(比如 5-7 个)时,大模型在做 Function Calling 时极易产生**参数编造(幻觉)*和*逻辑断链。
这时候就需要用到 Skill:
Skill = 专属的 Prompt + 一组关联的 Tools + 固定的执行逻辑(SOP)。
我们可以把刚才那个复杂任务,封装成一个黑盒式的 [月度销售异常诊断 Skill]。在这个 Skill 的内部,可能已经硬编码了先调 Tool A,再调 Tool B 的防错逻辑,并配合了专门做数据分析的小模型。
为什么要引入 Skills?(解决什么痛点)
在工业级开发中,引入 Skill 机制主要是为了解决以下三个痛点:
A. 防止大模型的“认知过载”与幻觉
- 如果你的系统里有 50 个底层的 API(查库、发邮件、读文件),你把这 50 个 API 全塞给主 Agent 的 Prompt 里,大模型的 Function Calling 准确率会断崖式下跌。它会记错参数,或者选错工具。
- 把它们按业务域封装成 5 个 Skill(比如“订单查询技能”、“报表生成技能”),主 Agent 的选择题就从 50 选 1 变成了 5 选 1,准确率极高。
B. 固化核心业务逻辑(SOP 化)
- LLM 的推理是充满不确定性的。但某些核心业务(如财务打款)必须是 100% 确定的。
- Skill 允许我们在黑盒内部使用**传统的、确定性的代码(如 if-else)**或者预设的 Workflow 来处理这些关键步骤,从而把“不确定的 AI 推理”转化为“确定的业务结果”。
C. 能力的解耦与复用
- 一个写好的 Skill 可以像插件一样被插到任何地方。
- 比如你写了一个 [PDF财报分析 Skill]。不仅你现在的“客服 Agent”可以用,明天你想做个“投资顾问 Agent”,直接把这个 Skill 挂载上去就行了,不用重写底层的 RAG 逻辑。
在 AI Agent 的架构设计中,Skills(技能)的渐进式披露(Progressive Disclosure) 是从人机交互(HCI)领域引入到 AI 工程化中的一个高阶概念。
简单来说,它的核心逻辑是:不要一次性把所有的“手脚”和“知识”都展示给大模型,而是在大模型需要的时候,才按需暴露相关的能力细节。
以下是详细的原理、流程以及“为什么”要这么做的深度解析。
一、 什么是“渐进式披露”?(原理)
在传统的 Agent 设计中,我们常犯的错误是**“全量注入”**:在 System Prompt 里写死 50 个工具的说明。这会导致大模型“大脑超载”。
渐进式披露的做法:
它将 Agent 的能力分为两个层级:
- 顶层目录(Metadata):主 Agent 只看到技能的“名字”和“简要功能描述”。
- 底层细节(Implementation):只有当主 Agent 明确说“我要用这个技能”时,系统才会把该技能内部复杂的 Prompt、参数 Schema 和具体 Tools 动态加载到当前上下文中。
二、 运行流程:它是如何“渐进”的?
假设你有一个拥有 100 种技能的“超级助理”,处理流程如下:
- 初始状态(极简):
- 主 Agent 的 Prompt 里只包含:任务目标 + 100 个技能的简介(每条一句话)。
- 此时,上下文非常干净,推理速度快,成本低。
- 意图识别与技能触发(Trigger):
- 用户:“帮我分析下这份财务报表。”
- 主 Agent 识别出这属于 Financial_Analysis_Skill 技能。
- 主 Agent 输出:[CALL: Financial_Analysis_Skill]。
- 动态扩容(Disclosure / 披露):
- 关键一步:后端程序(Java/Python)拦截到这个指令,并不立即执行代码,而是将 Financial_Analysis_Skill 内部挂载的详细专家 Prompt、相关子工具(如读表、算比率)“披露”出来,替换或追加到当前的上下文窗口。
- 局部深度推理(Execution):
- Agent 现在处于“财务专家”状态,手里拿到了专业的“手术刀”(子工具),开始处理任务。
- 收缩与总结(Finalization):
- 任务完成,输出结果。系统卸载掉这些细节信息,回复到初始的轻量化状态。
三、 为什么要这么做?(核心价值)
面试中,如果你能说出以下四点,面试官会觉得你对“AI 工程化落地”有极深的思考。
1. 解决“搜索空间爆炸”与工具幻觉
- 痛点:大模型在做 Function Calling 时,如果要在 50 个工具里选 1 个,准确率可能只有 60%;但在 5 个技能里选 1 个,准确率接近 100%。
- 价值:通过渐进式披露,极大地缩小了每一轮决策的搜索空间,从根源上杜绝了选错工具或参数编造(幻觉)。
2. 突破“上下文窗口限制”与“中间迷失”
- 痛点:所有的工具描述和 Prompt 累加起来可能有几万个 Token。模型在处理长文本时,容易忽略中间部分的信息(Lost in the Middle)。
- 价值:只披露当前有用的信息,保证了模型注意力的高度集中,提升了输出质量。
3. 极致的 Token 成本优化
- 痛点:大模型按 Token 计费。每一轮对话都带着 100 个用不到的工具描述,是在“烧钱”。
- 价值:初次交互只用几百个 Token 做路由,只有进入特定技能后才增加消耗。在大规模并发场景下,能节省 70% 以上的 API 费用。
4. 实现“不同角色的安全隔离”
- 价值:某些敏感技能(如“敏感数据删除”)的实现逻辑和具体 API,不应该在一开始就暴露。只有当用户权限校验通过且意图明确时,才披露相关细节。
2. 运行流程是怎样的?(调用阶段)
假设用户说:“帮我看看这份合同有没有风险。”
第一步:老板决策(主 Agent 思考)
- 主 Agent 思考:“用户要看合同风险。查一下通讯录,哦,我有 ReviewContract 这个技能。那我就派活给它吧。”
- 动作:主 Agent 发出一个指令(Function Call):Call ReviewContract(contract_text=”…”)。
第二步:外包接单(Skill 启动)—— 关键点
系统拦截到这个指令,暂停主 Agent 的思考,转而去运行 ReviewContract 这个 Skill 的代码。
进入 Skill 的黑盒内部:
- 加载 Skill 的专属 Prompt:系统临时拉起一个新的 LLM 会话(或者用同一个 LLM 但换了上下文),加载那个“资深法务专家”的 Prompt。
- 执行 Skill 的逻辑:
- Skill 内部思考:“我是法务,我要先查一下法律条文。”
- Skill 内部调用 Tool:调用 SearchLawDB 工具。
- Skill 内部生成:结合条文和合同,生成一份风险报告。
- 产出结果:Skill 最终输出一段话:“合同第 3 条有重大风险。”
第三步:老板汇报(回到主 Agent)
- Skill 运行结束,把“合同第 3 条有重大风险”这句话,作为返回值,塞回给主 Agent。
- 主 Agent 恢复思考:“哦,外包团队告诉我第 3 条有风险。那我这就告诉用户。”
- 最终回复用户:“亲,法务部看过了,第 3 条有个坑,您注意一下。”
“在该架构中,Skill 的执行严格遵循三阶段渐进式披露的流程,巧妙地融合了 Reference 和 Script:
- 路由阶段:主 Agent 根据用户意图,仅凭 Skill 的元数据(名称/描述)进行初步路由,此时不加载任何细节,保持轻量。
- 增强阶段 (Reference):一旦命中某个 Skill,系统会动态加载该 Skill 绑定的 Reference(领域知识/文档)。这让 Agent 瞬间具备了该领域的专家知识,从而能更精准地规划下一步动作。
- 执行阶段 (Script):Agent 根据 Reference 规划出参数,触发底层的 Script(代码脚本)。Script 负责执行具体的硬逻辑(如 API 调用、数据计算),并将最终结果反馈给 Agent。
让你开发一个skills你怎么写,如果要你运用skills运用到你的项目当中,你需要怎么设计,请给我设计一下?你说抽象通用技能和特定技能赋予,能详细展开说说么?
如果让我来开发一个 Skill,我不会上来就写代码,而是会严格遵循 “测试驱动开发 (TDD)” 的流程。这能保证写出来的 Skill 既稳定又好用。
以下是我的标准开发流程(也是 skill-creator 推荐的最佳实践):
第一步:明确“它是什么” (Capture Intent)
我首先会问你三个问题,把需求定下来:
- 名字 :它叫什么?(比如 git-commit-helper )
- 触发条件 :用户说什么话的时候,我应该跳出来?(比如“帮我写个提交信息”或者“提交代码”)
- 预期效果 :你希望它输出什么格式?(比如“必须符合 Angular Commit 规范”)
第二步:起草初稿 (Drafting)
我会创建一个文件夹(比如 skills/git-commit-helper/ ),然后在里面写一个 SKILL.md 。
这就相当于写一个**“超级提示词 (System Prompt)”**,告诉 AI:
- 你的角色是什么。
- 你必须遵守的规则(比如“永远不要用过去式”)。
- 给几个优秀的例子(Few-Shot Learning)。
第三步:编写测试用例 (Test Cases) —— 最关键的一步
我不会凭感觉猜它好不好用,而是会写 3-5 个 真实的 Prompt 作为考题。
- 测试 1 :“修改了 login.py 的登录逻辑,修复了空密码的 bug。”
- 测试 2 :“把 Readme 里的错别字改了。”
- 测试 3 :“重构了整个数据库模块,加了 redis 缓存。”
第四步:跑分与迭代 (Run & Evaluate)
- 运行测试 :我会让 AI 用这个 Skill 去回答上面那几个问题。
- 生成报告 :我会生成一个 HTML 网页,展示“用户的问题” vs “Skill 的回答”。
- 人工评审 :我们一起看结果。你可能会说:“测试 3 的回答太啰嗦了”。
- 修改 :我就去改 SKILL.md ,加上一条“对于重构类修改,描述要精简”。
- 重测 :再跑一遍,直到所有回答都完美。
1. 抽象通用技能 (Abstract General Skills / Base Skills)
- 定义:这是所有高级智能体都应该具备的**“生存本能”和“基础设施”**。它们不依赖于具体的业务场景,具有极高的复用性。
- 例子:
- WebSearchSkill:在互联网上搜索最新信息并提取网页正文。
- MemoryReadWriteSkill:向长期记忆库(Vector DB)中读取或写入事实。
- CodeExecutionSkill (如 Python REPL):运行一段生成的代码并返回结果(很多时候用来做复杂的数学计算或数据转换)。
- TimeAwarenessSkill:获取当前系统的时间、日期和时区。
- 作用:这些技能是构建更复杂行为的基石。它们就像人的“视觉”、“听觉”、“算术能力”,任何一个 Agent,无论是做客服还是做数据分析,通常默认都会挂载这些基础技能。
2. 特定技能赋予 (Domain-Specific Skill Injection)
定义:这是与你的核心业务强绑定的、解决特定领域问题的技能。它们往往封装了复杂的内部系统 API 调用、鉴权逻辑或业务规则。
例子(假设你的项目是一个电商 AI 导购):
- QueryInventorySkill:调用内部 ERP 接口,查询某个 SKU 在特定仓库的实时库存。
- CheckUserCouponSkill:调用促销系统 API,查询当前用户名下可用的优惠券。
- PlaceOrderSkill:组装商品信息和用户信息,调用交易中台创建订单(通常需要人工确认)。
作用:赋予 Agent 真正的“业务价值”。由于这些技能可能极其庞杂(比如一个大型电商可能有几百个内部 API),如果全部塞给 Agent,它根本处理不过来。因此,特定技能必须是“按需赋予(Dynamically Injected)”的。
[用户请求: “帮我查一下我的订单状态,如果发货了就帮我催一下物流”]
[用户请求: "帮我查一下我的订单状态,如果发货了就帮我催一下物流"]

       | 1. 请求进入
       v
+---------------------------------------------------+
|               【 意图路由层 (Intent Router) 】               |
|  - 使用一个轻量级 LLM (或分类模型) 分析请求的意图和所需能力 |
+---------------------------------------------------+
       | 2. 识别出意图: "查询订单", "查询物流"
       v
+---------------------------------------------------+
|               【 技能注册中心 (Skill Registry) 】            |  <-- 核心组件
|  +---------------------------------------------+  |
|  | 通用技能池 (Base Skills)                    |  |
|  |   - 搜索、计算、时间、记忆读取...               |  |
|  +---------------------------------------------+  |
|  +---------------------------------------------+  |
|  | 特定业务技能池 (Domain Skills)              |  |
|  |   - 订单查询(OrderQuerySkill)               |  |
|  |   - 物流追踪(LogisticsTrackSkill)           |  |
|  |   - 退款申请(RefundSkill)                   |  |
|  +---------------------------------------------+  |
+---------------------------------------------------+
       | 3. 动态加载 (Dynamic Injection)
       v
+---------------------------------------------------+
|               【 智能体引擎 (Agent Engine) 】               |
|  - System Prompt: "你是一个电商客服..."             |
|  - 默认挂载: [时间技能], [记忆读取技能]             |
|  - 动态注入: [OrderQuerySkill], [LogisticsTrackSkill]|  <-- 只有被选中的技能才会暴露给大模型
|  - 上下文 (Context & Memory)                      |
+---------------------------------------------------+
       | 4. 执行推理 (ReAct / Function Calling)
       v
[大模型生成函数调用: call_order_query_skill(order_id)]
       |
       v
+---------------------------------------------------+
|               【 技能执行引擎 (Skill Executor) 】            |
|  - 负责真正的代码执行 (调用内部 API)                |
|  - 处理鉴权、超时、异常重试                         |
|  - 将执行结果格式化后返回给智能体引擎                 |
+---------------------------------------------------+
       | 5. 结果回传
       v
[大模型根据结果生成最终的人类语言回复]
例如PDF那个SKlls
1. 实用主义的“工具箱”视角 (The Pragmatic Toolkit)
这份文档本质上是一本 Cookbook(食谱/代码库) 。
- 代码优先 :它没有长篇大论的原理讲解,几乎每个小节都是一段 即拿即用 的代码(Python)或命令(Bash)。
- 工具导向 :它按照工具库( pypdf , pdfplumber , reportlab )和 命令行工具( qpdf , pdftk )来组织内容。这意味着作者假设你已经知道自己要用什么工具,或者愿意尝试不同的工具来解决问题。
2. 数据挖掘视角 (Data Extraction)
PDF 在这里被视为一种 非结构化的数据源 ,而不是一种视觉展示格式。文档花了大量篇幅介绍如何把 PDF 变成计算机能理解的数据:
- 文本提取 :不仅是提取文字,还强调了保留布局 ( Extract Text with Layout )。
- 表格提取 :专门介绍了 pdfplumber 和 pandas 的结合,把 PDF 里的表格硬生生转成 Excel。
- 元数据提取 :读取作者、标题等隐藏信息。
- OCR :甚至包含了如何处理扫描版 PDF(图片转文字),这是典型的数据处理需求。
3. 文件工程视角 (File Engineering)
作者把 PDF 看作一种可以被任意 物理操作 的对象:
- 物理切割与重组 :合并 ( Merge )、拆分 ( Split )、旋转 ( Rotate )。
- 安全操作 :加密、解密、加水印。
- 底层操作 :虽然不深入,但通过 qpdf 等工具展示了对 PDF 结构的直接操控能力。
4. 分层指引策略 (Hierarchical Guidance)
为了保持主文档的简洁,作者采用了 分流 策略:
- 普通任务 :直接在当前文档解决(如合并、提取文本)。
- 复杂任务 :果断指向外部文档。
- 表单填写 :这是一个极其复杂的领域(涉及坐标、交互域),所以单独拆分出了 FORMS.md 。
- 高级开发 :更底层的库(如 pypdfium2 )和 JS 库被移到了 REFERENCE.md 。
SKILL.md 是 给 AI 用的“默认操作手册” 。只要你不提特殊要求,我就按这个来,稳妥、简单。
REFERENCE.md 是 给 AI 用的“备用知识库” 。当你提出“高性能”、“前端生成”、“修复损坏文件”这种刁钻需求时,我会翻开这本书,寻找更高级的解决方案。
31. 在业务 Skill 中,什么情况下适合通过脚本实现,什么情况下不适合使用脚本?
先立一条判据,下面所有情况都是它的推论:
这个步骤的输入输出,是否可枚举、可断言?
是 → 交给脚本(确定性代码);否 → 交给模型(概率性判断)。
Skill 里的 scripts/ 不是「给模型减负」的装饰,而是能力下沉——把能确定的部分下沉成代码,把模型留给真正需要判断的部分。这和 Harness 里「确定性系统 vs 概率性判断」是同一条分界线。
适合用脚本的
| 情况 | 例子 |
|---|---|
| 确定性、可重复的计算 | 日期推算、格式转换(Markdown ↔ HTML)、单位换算 |
| 需要精确结果 | 正则抽取、校验和、Excel / PDF 解析、加解密、金额计算 |
| 多步骤但中间结果没人要看 | 下载 → 解压 → 转码 → 上传,中间产物不必进模型上下文 |
| 已有成熟工具 | ffmpeg / pandas / jq / imagemagick,重写不如调用 |
| 大批量数据 | 几万行日志做统计——模型逐条处理又贵又容易错 |
| 需要原子性 / 事务 | 数据库迁移、批量改名,失败要能回滚 |
| 输入可控、参数收敛 | 参数只有几种合法取值,容易做校验 |
不适合用脚本的
| 情况 | 为什么 |
|---|---|
| 需要语义理解 / 判断 | 分类、摘要、意图识别、模糊匹配——规则枚举不完,硬写成 if-else 会迅速腐化 |
| 一次性的探索 | 临时排查问题,写脚本的时间比直接干还长 |
| 脚本引入的风险 > 收益 | 见下 |
| 环境不确定 | 依赖缺失、跨平台差异(Windows 没有 grep -P、路径分隔符不同)——脚本会变成不可靠的依赖 |
「风险大于收益」具体指什么——这是最容易被忽略的一类:
- 参数由模型自由生成 → 注入风险。 模型把用户输入拼进命令里,就有命令注入 / 路径穿越的可能。脚本必须自己校验参数,不能信任调用方。
- 脚本要的权限太高。 需要网络、文件系统写、凭据的脚本,等于给模型开了个后门。
- 不可观测。 脚本内部出错,模型只看到一句报错,排查成本高。
- 有更轻的替代。 模型用现成的
read_file/grep/shell两步就能干完的事,封装成脚本反而增加维护面。
落成 Skill 时的三个要求
决定用脚本后,脚本本身要达到:
- 幂等 —— 重跑一次不会产生副作用叠加
- 参数校验前置 —— 非法输入直接拒绝,不要「尽力而为」
- 失败给可读错误 —— 返回结构化错误(错在哪、期望什么),而不是抛栈
并且在 SKILL.md 里写清什么时候该调用它(这是 agent 决定用不用的唯一依据),而不是只罗列参数。
32. 设计 Skill 时,会考虑 Agent 执行时的上下文吗?如何控制上下文规模?
会,而且这是 Skill 设计的核心约束之一。 因为 Skill 最终要注入进模型上下文,而上下文是有限预算——SKILL.md 写厚一点很爽,代价是挤掉别人,还会让关键约束被重复信息淹没。
设计时要考虑的三件事
description是路由依据,不是功能简介。 agent 决定「要不要加载这个 skill」全靠这一句。所以要写何时使用(触发场景),而不是罗列它能干什么。写歪了,agent 要么该用不用,要么乱用。SKILL.md是索引,不是手册。 只放「什么时候用 + 主流程步骤」,长内容外置。- 大段参考资料放
references/,让 agent 按需读。 常驻的每多一行,都在所有轮次里重复付 token。
这三条其实就是渐进式披露(progressive disclosure):让信息在「需要的那一刻」才进入上下文。
控制上下文规模的手段
| 手段 | 做法 |
|---|---|
| 三层渐进披露 | ① 元数据(name + description)常驻;② SKILL.md 命中才加载;③ references/、scripts/ 进一步按需 |
| 引用而不是内联 | 需要细节时让 agent read_file 去读,而不是把细节抄进 SKILL.md |
| 脚本外置重活 | 让 scripts/ 干脏活,只把「调用方式 + 结果」带进上下文,中间过程不进 |
| 结构化、紧凑的返回 | 脚本别 dump 原始大输出,返回提炼后的结果 |
| 按需加载机制 | 框架层支持按需读取 skill 内容(如 AgentScope 的 skill 查看器),用到才拉 |
| 工具分组 | 工具 / skill 一多上下文就发散,用 tool group 按场景切换 |
| 压缩与卸载 | 上下文太长时摘要压缩;单条工具结果过大时落盘 + 留 read_file 指针 |
| 子 agent 隔离 | 上下文重的任务丢给 subagent,只回传结论,避免主上下文膨胀 |
| 与 Knowledge 分工 | Skill 放「怎么做」,企业事实放 Knowledge,避免同一内容在两处重复注入 |
一个容易被忽略的视角:可审计
上下文不是「注入了就行」。设计得好的系统会记录这一轮到底注入了哪些 skill、哪个版本、占了多少 token、为什么选中它(Context Manifest 的思路)。这样才能回答三个问题:
- 开发时 —— 模型为什么没用上那个 skill?是没被选中,还是选中了没遵守?
- 评估时 —— 改了
description之后,skill 的命中率变了吗? - 审计时 —— 这条指令是从哪个 skill 的哪个版本进来的?
只保存最终拼接文本是回答不了这些的——同一个 skill 的不同版本,内容可能完全不同。
以下为外部资料补充:来自 Datawhale《hello-agents》附加章节
《Agent Skills 与 MCP:智能体能力扩展的两种范式》
原文内容未删减,仅将标题层级下调一级以并入本文。
Agent Skills 与 MCP:智能体能力扩展的两种范式
引言:MCP 之后,我们还需要什么?
在第十章中,我们深入探讨了 MCP(Model Context Protocol)如何通过标准化协议解决智能体与外部工具的连接问题。你已经学会了如何让智能体通过 MCP 访问数据库、文件系统、API 服务等各种资源。让我们回顾一个典型的 MCP 使用场景:
1 | |
这段代码工作得很好,智能体成功连接到了数据库。但当你尝试处理更复杂的任务时,会发现一些微妙的问题:
1 | |
这个任务需要执行多次数据库查询,每次查询的结果会影响下一次查询的策略。更关键的是,它需要智能体具备领域知识:知道如何衡量”话语权”,知道应该从哪些维度分析数据,知道如何组合多个查询结果得出结论。
此时,你会遇到两个根本性的问题:
第一个问题是上下文爆炸。为了让智能体能够灵活查询数据库,MCP 服务器通常会暴露数十甚至上百个工具(不同的表、不同的查询方法)。这些工具的完整 JSON Schema 在连接建立时就会被加载到系统提示词中,可能占用数万个 token。据社区开发者反馈,仅加载一个 Playwright MCP 服务器就会占用 200k 上下文窗口的 8%,这在多轮对话中会迅速累积,导致成本飙升和推理能力下降。
第二个问题是能力鸿沟。MCP 解决了”能够连接”的问题,但没有解决”知道如何使用”的问题。拥有数据库连接能力,不等于智能体知道如何编写高效且安全的 SQL;能够访问文件系统,不意味着它理解特定项目的代码结构和开发规范。这就像给一个新手程序员开通了所有系统的访问权限,但没有提供操作手册和最佳实践。
这正是 Agent Skills 要解决的核心问题。2025年初,Anthropic 在推出 MCP 之后,进一步提出了 Agent Skills 的概念,引发了业界的广泛关注。有开发者评论说:”Skills 和 MCP 是两种东西,Skills 是领域知识,告诉模型该如何做,本质上是高级 Prompt;而 MCP 对接外部工具和数据。” 也有人认为:”从 Function Call 到 Tool Call 到 MCP 到 Skills,核心大差不差,就是工程实践和表现形式的优化演进。”
那么,Agent Skills 到底是什么?它与 MCP 有何本质区别?两者是竞争关系还是互补关系?本章将深入探讨这些问题。
什么是 Agent Skills?
核心设计理念
Agent Skills 是一种标准化的程序性知识封装格式。如果说 MCP 为智能体提供了”手”来操作工具,那么 Skills 就提供了”操作手册”或”SOP(标准作业程序)”,教导智能体如何正确使用这些工具。
这种设计理念源于一个简单但深刻的洞察:连接性(Connectivity)与能力(Capability)应该分离。MCP 专注于前者,Skills 专注于后者。这种职责分离带来了清晰的架构优势:
- MCP 的职责:提供标准化的访问接口,让智能体能够”够得着”外部世界的数据和工具
- Skills 的职责:提供领域专业知识,告诉智能体在特定场景下”如何组合使用这些工具”
用一个类比来理解:MCP 像是 USB 接口或驱动程序,它定义了设备如何连接;而 Skills 像是软件应用程序,它定义了如何使用这些连接的设备来完成具体任务。你可以拥有一个功能完善的打印机驱动(MCP),但如果没有告诉你如何在 Word 里设置页边距和双面打印(Skill),你仍然无法高效地完成打印任务。
渐进式披露:破解上下文困境
Agent Skills 最核心的创新是渐进式披露(Progressive Disclosure)机制。这种机制将技能信息分为三个层次,智能体按需逐步加载,既确保必要时不遗漏细节,又避免一次性将过多内容塞入上下文窗口。
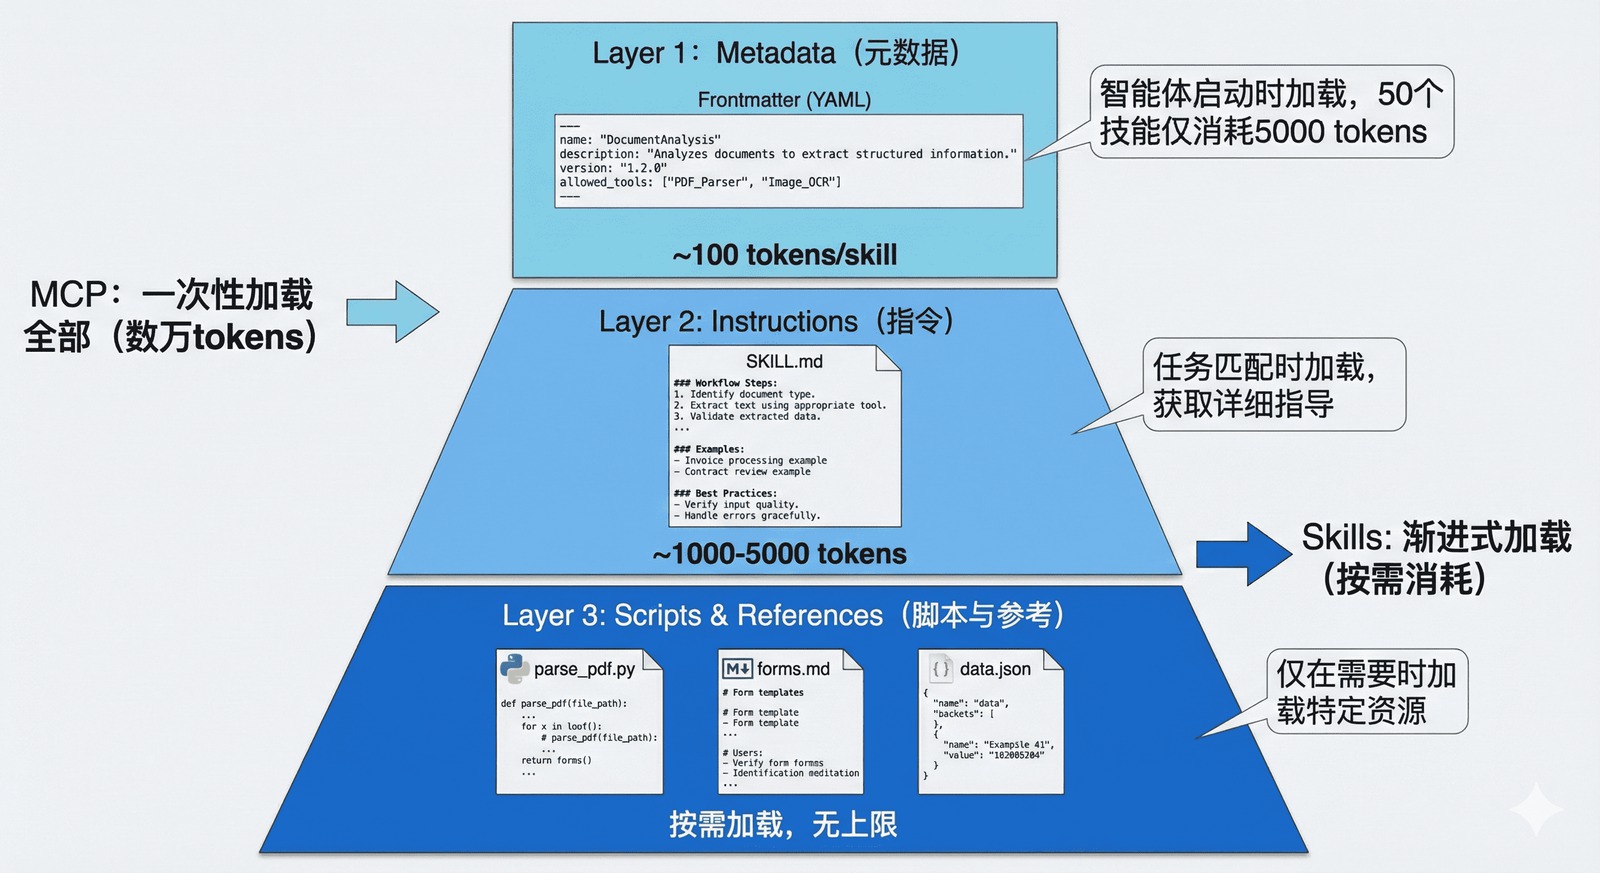
图 1 Agent Skills 渐进式披露三层架构
第一层:元数据(Metadata)
在 Skills 的设计中,每个技能都存放在一个独立的文件夹中,核心是一个名为 SKILL.md 的 Markdown 文件。这个文件必须以 YAML 格式的 Frontmatter 开头,定义技能的基本信息。
当智能体启动时,它会扫描所有已安装的技能文件夹,仅读取每个 SKILL.md 的 Frontmatter 部分,将这些元数据加载到系统提示词中。根据实测数据,每个技能的元数据仅消耗约 100 个 token。即使你安装了 50 个技能,初始的上下文消耗也只有约 5,000 个 token。
这与 MCP 的工作方式形成了鲜明对比。在典型的 MCP 实现中,当客户端连接到一个服务器时,通常会通过 tools/list 请求获取所有可用工具的完整 JSON Schema,可能立即消耗数万个 token。
第二层:技能主体(Instructions)
当智能体通过分析用户请求,判断某个技能与当前任务高度相关时,它会进入第二层加载。此时,智能体会读取该技能的完整 SKILL.md 文件内容,将详细的指令、注意事项、示例等加载到上下文中。
此时,智能体获得了完成任务所需的全部上下文:数据库结构、查询模式、注意事项等。这部分内容的 token 消耗取决于指令的复杂度,通常在 1,000 到 5,000 个 token 之间。
第三层:附加资源(Scripts & References)
对于更复杂的技能,SKILL.md 可以引用同一文件夹下的其他文件:脚本、配置文件、参考文档等。智能体仅在需要时才加载这些资源。
例如,一个 PDF 处理技能的文件结构可能是:
1 | |
在 SKILL.md 中,可以这样引用附加资源:
- 当需要执行 PDF 解析时,智能体会运行
parse_pdf.py脚本 - 当遇到表单填写任务时,才会加载
forms.md了解详细步骤 - 模板文件只在需要生成特定格式文档时访问
这种设计有两个关键优势:
无限的知识容量:通过脚本和外部文件,技能可以”携带”远超上下文限制的知识。例如,一个数据分析技能可以附带一个 1GB 的数据文件和一个查询脚本,智能体通过执行脚本来访问数据,而无需将整个数据集加载到上下文中。
确定性执行:复杂的计算、数据转换、格式解析等任务交给代码执行,避免了 LLM 生成过程中的不确定性和幻觉问题。
渐进式披露的效果:从 16k 到 500 Token
社区开发者分享的实践案例充分证明了渐进式披露的威力。在一个真实场景中:
- 传统 MCP 方式:直接连接一个包含大量工具定义的 MCP 服务器,初始加载消耗 16,000 个 token
- Skills 包装后:创建一个简单的 Skill 作为”网关”,仅在 Frontmatter 中描述功能,初始消耗仅 500 个 token
当智能体确定需要使用该技能时,才会加载详细指令并按需调用底层的 MCP 工具。这种架构不仅大幅降低了初始成本,还使得对话过程中的上下文管理更加精准和高效。
Agent Skills vs MCP:本质区别与协作关系
现在,我们可以系统地比较这两种技术的本质区别了。
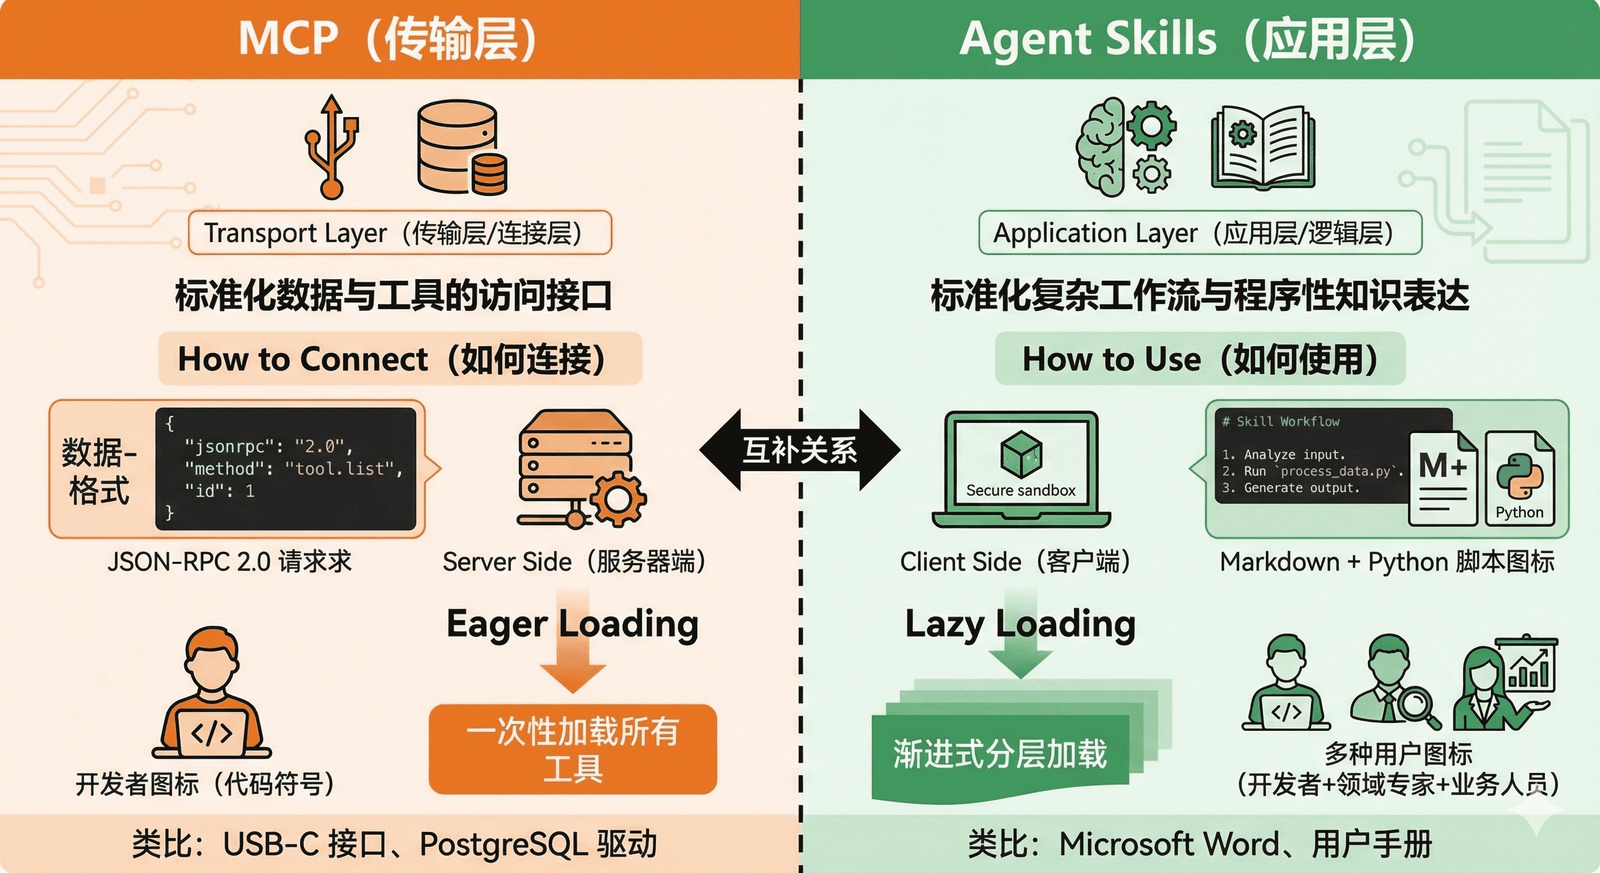
图 2 MCP 与 Agent Skills 设计哲学对比
从工程视角理解差异
让我们通过一个具体的例子来理解这种差异。假设你要构建一个智能体来帮助团队进行代码审查:
MCP 的职责:
1 | |
MCP 让智能体”能够”访问 GitHub,能够调用这些 API。但它不知道”应该”做什么。
Skills 的职责:
1 | |
Skills 告诉智能体”应该”做什么、如何组织审查流程、需要关注哪些公司特定的规范。它是领域知识和最佳实践的容器。
上下文管理策略的本质差异
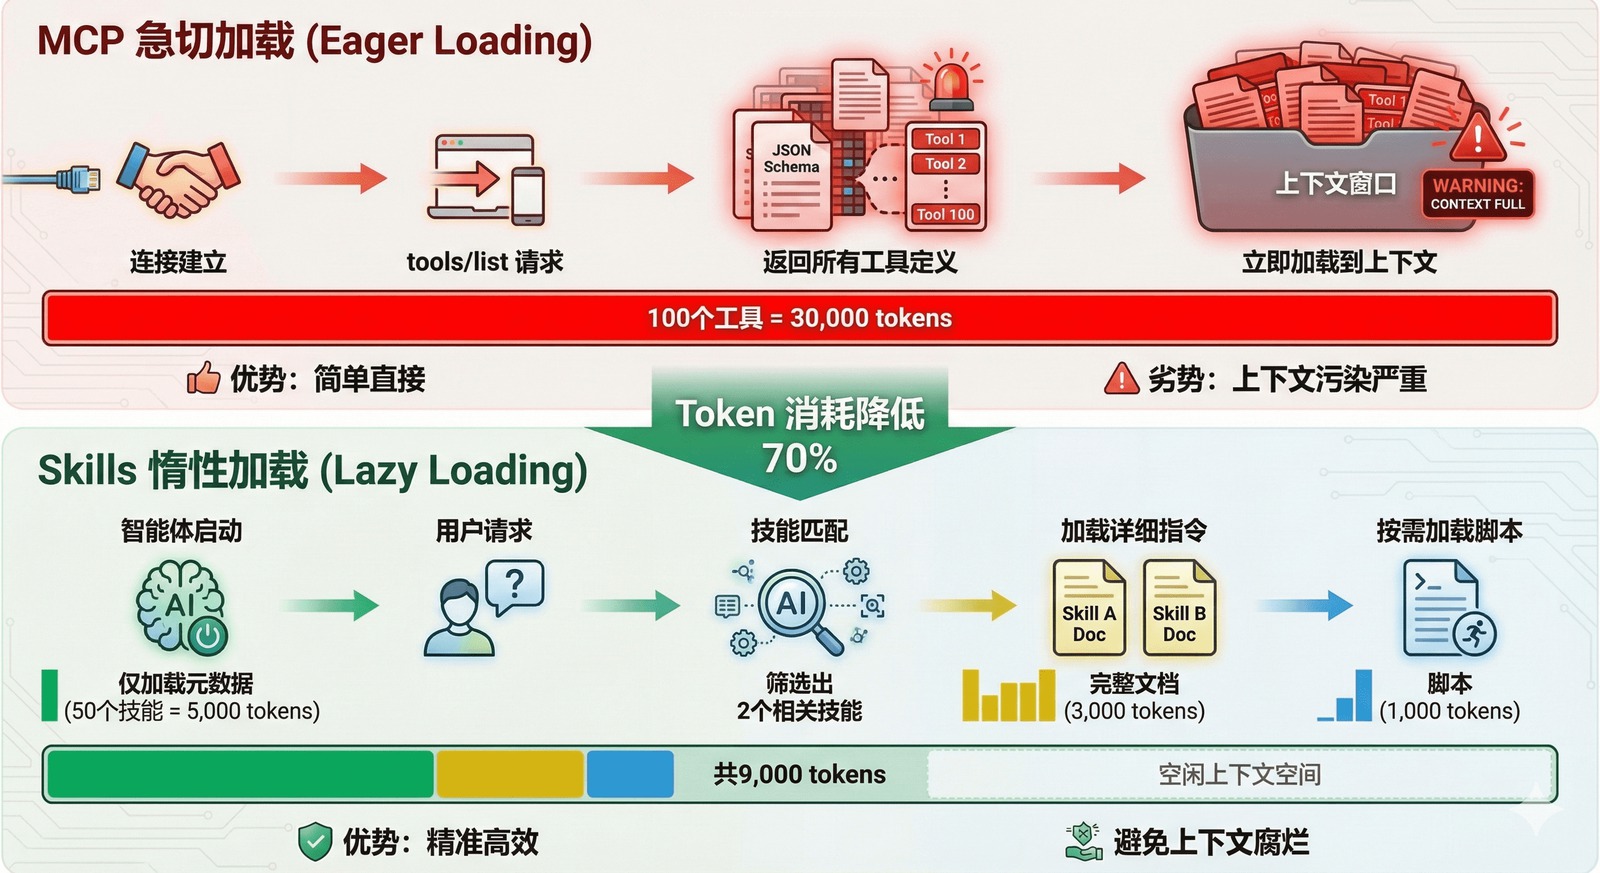
图 3 MCP 急切加载 vs Skills 惰性加载对比
互补而非竞争:Skills + MCP 的混合架构
理解了两者的差异后,我们会发现:Skills 和 MCP 不是竞争关系,而是互补关系。最佳实践是将两者结合,形成分层架构:
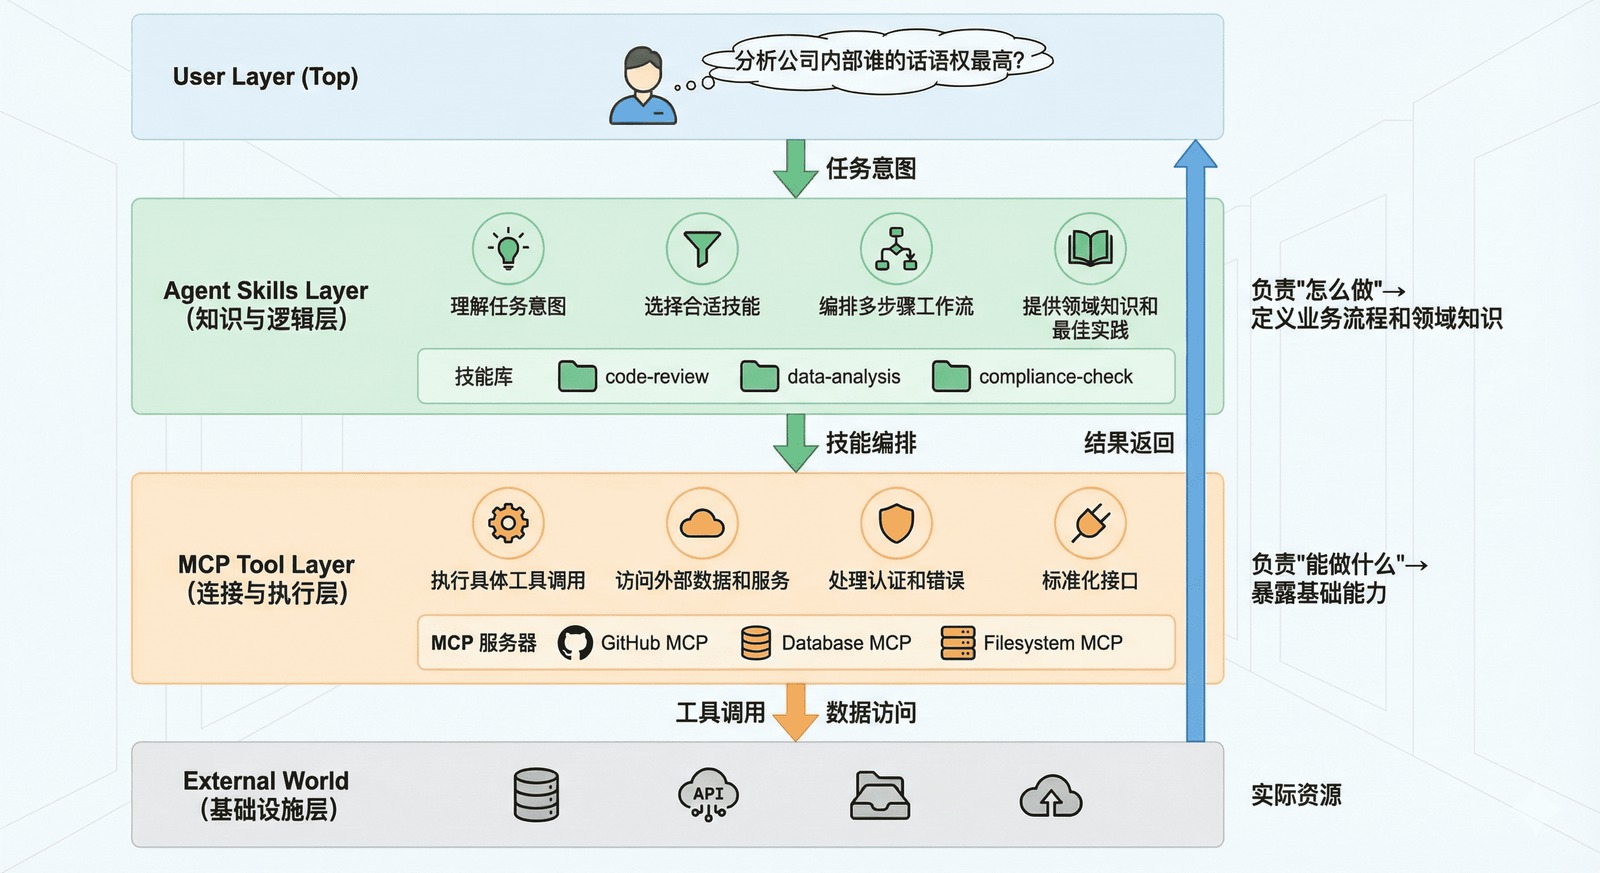
图 4 Skills + MCP 混合架构设计
- 用户问:”分析公司内部谁的话语权最高”
- Skills 层识别这是一个数据分析任务,加载
mysql-employees-analysis技能 - Skills 层根据技能指令,将任务分解为子步骤:查询管理关系、薪资对比、任职时长等
- MCP 层执行具体的 SQL 查询,返回结果
- Skills 层根据技能中的领域知识,解读数据并生成综合分析
- 返回结构化的答案给用户
这种架构的优势是:
- 关注点分离:MCP 专注于”能力”,Skills 专注于”智慧”
- 成本优化:渐进式加载大幅降低 token 消耗
- 可维护性:业务逻辑(Skills)与基础设施(MCP)解耦
- 复用性:同一个 MCP 服务器可以被多个 Skills 使用
技术实现:如何创建和使用 Skills
SKILL.md 规范详解
让我们深入了解 SKILL.md 文件的标准结构:
1 | |
编写高质量 Skills 的原则
根据 Anthropic 官方文档和社区最佳实践,编写有效的 Skills 需要遵循以下原则:
1. 精准的 Description
description 是智能体决策的关键。它应该:
- 精确定义适用范围:避免模糊的描述如”帮助处理数据”
- 包含触发关键词:让智能体能够匹配用户意图
- 说明独特价值:与其他技能区分开来
❌ 不好的 description:
1 | |
✅ 好的 description:
1 | |
2. 模块化与单一职责
一个 Skill 应该专注于一个明确的领域或任务类型。如果一个 Skill 试图做太多事情,会导致:
- Description 过于宽泛,匹配精度下降
- 指令内容过长,浪费上下文
- 难以维护和更新
建议:与其创建一个”通用数据分析”技能,不如创建多个专门的技能:
mysql-employees-analysis:专门分析 employees 数据库sales-data-analysis:专门分析销售数据user-behavior-analysis:专门分析用户行为数据
3. 确定性优先原则
对于复杂的、需要精确执行的任务,优先使用脚本而不是依赖 LLM 生成。例如,在数据导出场景中,与其让 LLM 生成 Excel 二进制内容(容易出错),不如编写一个专门的脚本来处理这个任务,SKILL.md 中只需要指导智能体何时调用这个脚本即可。
4. 渐进式披露策略
合理利用三层结构,将信息按重要性和使用频率分层:
- SKILL.md 主体:放置核心工作流、常用模式
- 附加文档(如
advanced.md):放置高级用法、边缘情况 - 数据文件:放置大型参考数据,通过脚本按需查询
实践案例:MySQL 员工分析 Skill 详解
让我们通过 Anthropic 社区的一个真实案例,了解 Agent Skills 的具体应用。这个技能用于分析 MySQL 官方的 employees 示例数据库。
技能文件结构
1 | |
SKILL.md 核心内容示例
这个技能的 Frontmatter(元数据层):
1 | |
这个 SKILL.md 文件展示了一个完整技能的结构:
- 清晰的元数据(智能体用于发现和匹配)
- 完整的数据库结构说明
- 详细的工作流程指导
- 丰富的查询模式示例(可直接复用的 SQL 模板)
- 实用的注意事项和故障排查
技能的使用效果
当用户向支持 Agent Skills 的智能体(如 Claude Desktop、Claude Code)提问时:
用户问题:
“分析公司内部谁的话语权最高?需要综合考虑管理层级、薪资水平和任职时长。”
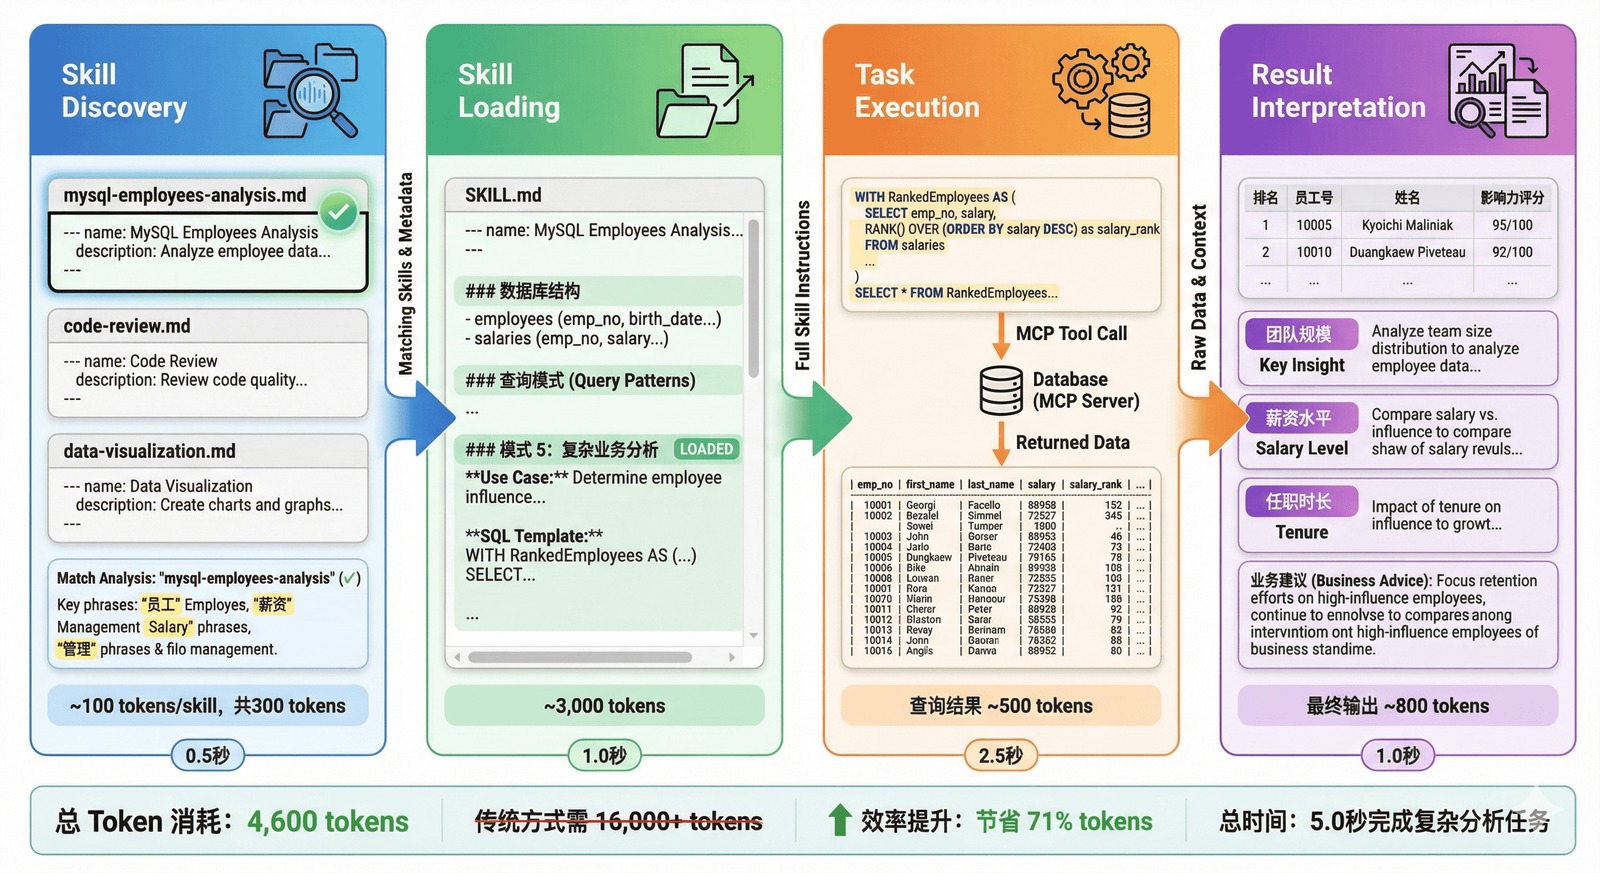
图 5 Agent Skills 完整工作流程示意
输出示例:
| 排名 | 员工号 | 姓名 | 团队规模 | 薪资 | 任职年限 | 影响力评分 |
|---|---|---|---|---|---|---|
| 1 | 110022 | Margareta Markovitch | 45 | 152,710 | 18 | 692.71 |
| 2 | 110039 | Vishwani Minakawa | 38 | 138,273 | 16 | 598.27 |
| 3 | 110085 | Ebru Alpin | 32 | 124,054 | 15 | 519.05 |
关键洞察:
- 话语权最高的员工通常管理大团队(30+人)、薪资前1%(>12万)、任职超15年
- 部门经理的影响力远超普通员工,管理规模是关键因素
- 长期任职的高薪员工即使不担任管理职务,也具有较强的话语权
整个过程中,技能提供了:
- 领域知识:如何衡量”话语权”(管理规模+薪资+任职时长)
- 技术指导:如何编写高效的 SQL(使用 CTE、窗口函数、多表 JOIN)
- 业务理解:如何解读数据并生成洞察
Skills 的分享与复用
Agent Skills 的另一个重要特性是社区化。Anthropic 建立了官方的 Skills 仓库:
官方技能库:https://github.com/anthropics/skills
截至 2025 年,已有数百个社区贡献的技能,覆盖:
- 开发工具:前端设计、API 测试、代码审查、Git 工作流
- 数据分析:SQL 查询、数据可视化、统计分析
- 文档处理:PDF 解析、Markdown 生成、技术文档撰写
- 业务流程:项目管理、客户支持、合规审查
使用社区技能非常简单:
1 | |
你也可以分享自己的技能:
1 | |
行业动态与生态演进
标准化进程与厂商支持
Agent Skills 虽然由 Anthropic 提出,但其设计理念正在影响整个行业。
Anthropic Claude:
- Claude Desktop 和 Claude Code 原生支持 Skills
- 提供官方 SDK 和开发工具
- 维护官方技能库
OpenAI 的响应:
虽然 OpenAI 尚未官方采用 “Skills” 这个术语,但在 2025 年 3 月的更新中,ChatGPT 引入了类似的概念:
- Custom Instructions 增强:支持更复杂的多步骤指令
- Memory 与 Context Profiles:允许用户保存和复用特定领域的知识
- GPTs 的”知识库”功能:可以附加文档和脚本,按需加载
这些功能本质上是 Skills 理念的不同实现形式。
Google Vertex AI:
Google 在 Gemini 模型中引入了 “Grounding with Functions”,允许开发者定义”函数包”(Function Packages),每个包包含:
- 函数定义(类似 MCP 的 tools)
- 使用指南(类似 Skills 的 instructions)
- 示例(examples)
这种设计与 Skills + MCP 的混合架构高度相似。
分层架构的必然性
综合各方观点,我们认为:Skills 和 MCP 代表了智能体架构中两个必然分离的层级。随着智能体系统的复杂度增加,这种分层是不可避免的:
1 | |
这与传统软件架构的演进路径完全一致(从单体到分层到微服务),只是在 AI 领域重新演绎了一遍。
标准化的趋势
随着行业对智能体技术的重视,我们预见以下趋势:
1. 协议融合
未来可能出现统一的智能体能力描述协议,融合 MCP 的连接性和 Skills 的知识表达:
1 | |
2. 市场化与生态系统
类似于 NPM、PyPI,未来可能出现智能体能力的包管理系统:
1 | |
开发者可以发布、分享、售卖自己的 Skills 和 MCP 服务器,形成繁荣的生态系统。
3. 自动化能力发现
智能体可能发展出自动发现和学习新能力的机制:
1 | |
挑战与风险
与此同时,我们也需要警惕潜在的风险:
安全性挑战:
- Skills 包含可执行脚本,存在代码注入风险
- MCP 服务器可能暴露敏感数据接口
- 第三方技能的可信度难以验证
上下文污染:
- 随着 Skills 数量增加,即使是元数据也可能占用大量上下文
- 需要更智能的技能索引和检索机制
碎片化风险:
- 虽然 MCP 正在标准化,但 Skills 格式尚未统一
- 不同厂商可能推出不兼容的 Skills 规范
总结
Agent Skills 和 MCP 代表了智能体技术栈中两个关键的抽象层:
- MCP(Model Context Protocol):解决”连接性”问题,是智能体与外部世界交互的标准化接口,相当于”神经系统”或”双手”
- Agent Skills:解决”能力”问题,是领域知识和工作流的封装,相当于”大脑皮层”或”操作手册”
两者不是竞争关系,而是互补关系:
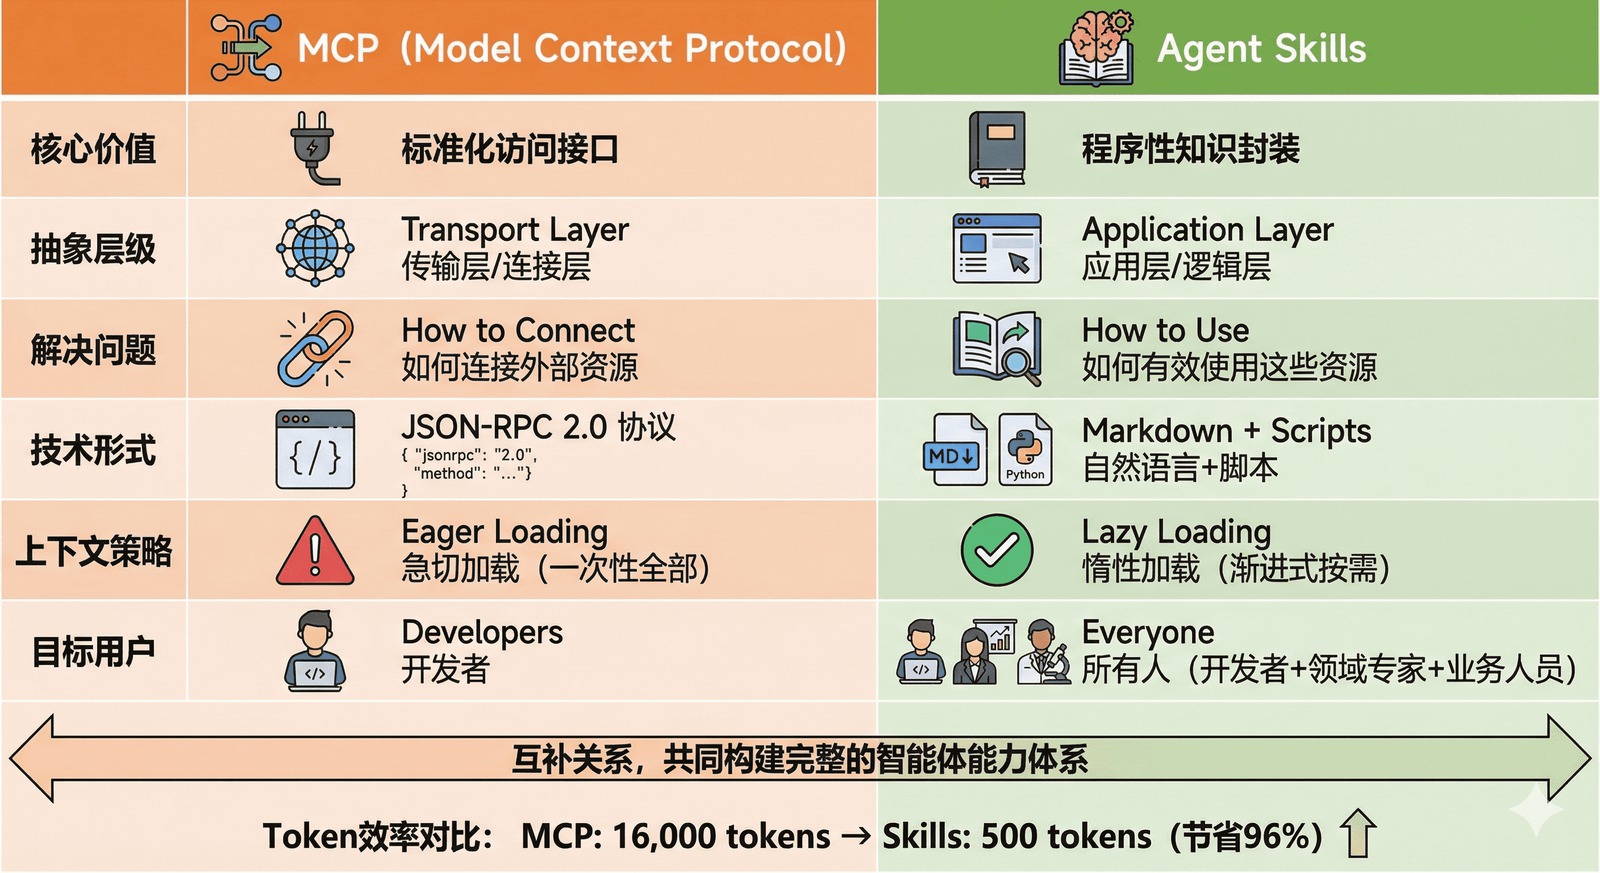
图 6 MCP 与 Agent Skills 全面对比总结
关键洞察:
分层架构是必然趋势:随着智能体系统复杂度增加,”连接层”和”知识层”的分离是不可避免的
上下文效率是核心矛盾:Skills 的渐进式披露机制将 token 消耗降低 90% 以上,这是其最大的技术优势
领域知识的民主化:Skills 让非开发者也能贡献智能体能力,这将极大拓展 AI 应用的边界
混合架构是最佳实践:在企业级应用中,MCP 提供基础设施连接,Skills 提供业务逻辑,两者结合才能构建高效、可维护的智能体系统
实践建议:
- 对于外部服务连接(数据库、API、云服务),优先使用 MCP
- 对于复杂工作流(多步骤任务、领域专业知识),优先使用 Skills
- 在上下文受限的场景(长对话、大量工具),使用 Skills 进行渐进式管理
- 构建企业级智能体时,采用 MCP + Skills 的分层架构
通过本章的学习,你应该能够:
- 理解 Agent Skills 和 MCP 的本质区别与协作关系
- 掌握 Skills 的渐进式披露机制及其优势
- 编写高质量的 SKILL.md 文件
- 在实际项目中合理选择和组合两种技术
- 构建分层清晰、高效可维护的智能体系统
智能体技术仍在快速演进中。MCP 已成为连接层的事实标准,Skills 的理念也在影响整个行业。掌握这两种技术,将帮助你在 AI 浪潮中构建更强大、更实用的智能体应用。
参考资料
- Anthropic Agent Skills 官方文档:https://docs.anthropic.com/en/docs/agent-skills
- Anthropic Skills GitHub 仓库:https://github.com/anthropics/skills
- Model Context Protocol 规范:https://modelcontextprotocol.io/
- Anthropic 博客:Improving Frontend Design Through Skills:https://www.claude.com/blog/improving-frontend-design-through-skills
- 第十章:智能体通信协议(hello-agents)