上下文工程
本文是阅读整理,不是原创。
原文:《万字长文解析 Agent 框架中的上下文管理策略》(知乎 @魔法学院的Chilla,约 12,536 字)
整理原则:保留原文全部关键技术论点、示例与配图,重组结构、精简其个人叙述部分。文中配图均来自原文(含作者水印)。
0x00 引子
2026 年春节前后,至少 9 家国内厂商密集发布了旗舰模型(GLM5、MiniMaxM2.5、Qwen3.5 等)。可以看到大模型领域的竞争焦点已经从通用能力,转向了 Agent 落地与编程能力这两大方向。
随着 Claude Code、OpenClaw 这类 Agent Scaffold 爆火,各家也把定位锁定在 Agentic Engineering 上——从 “chatbots that respond” 转向 “agents that act”。
作者因此新开了一个 LLM Agent 专题,打算不定期更新。这篇是本系列第二篇,主题是 Agent 的上下文管理策略:如何组织短期记忆、如何管理长期记忆。
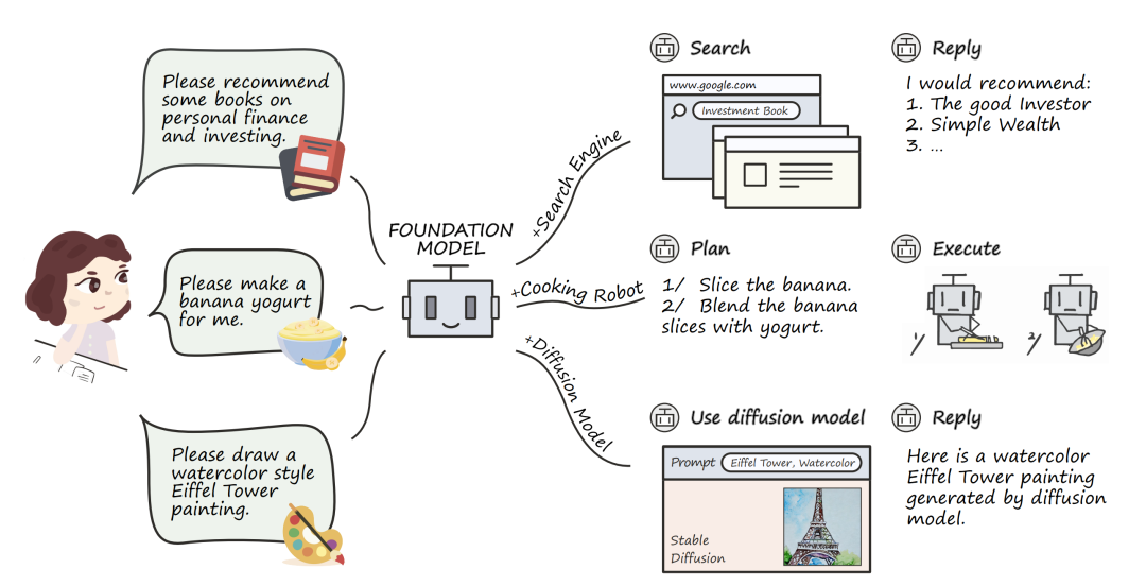
原文提到这个专题的定位:不局限于「怎么用」,而是讲框架设计层面的理解——但也不会特别底层,以理解 Agent 框架的核心设计思路为主。
0x01 背景
(1)什么叫上下文工程(Context Engineering)
定义:在一些 LLM 的约束下(上下文窗口大小、注意力长度限制),优化上下文 token 的效用,从而持续获得理想输出的工程实践。
一个好的 context engineering 追求:用最少的、信号最强的 token 集合,最大化期望输出的概率。
为什么它现在才重要?
| 适用任务 | |
|---|---|
| Prompt Engineering | 单轮文本生成 |
| Context Engineering | 需要多轮推理、长时间运行的智能体——必须管理不断演变的上下文状态 |
Agent 不断运行会不断产生新数据,其中一些对下一轮推理有用,必须放进上下文作为模型的「短期记忆」。Context Engineering 就是从不断变化的信息中,精心挑选出能放进有限窗口的内容。
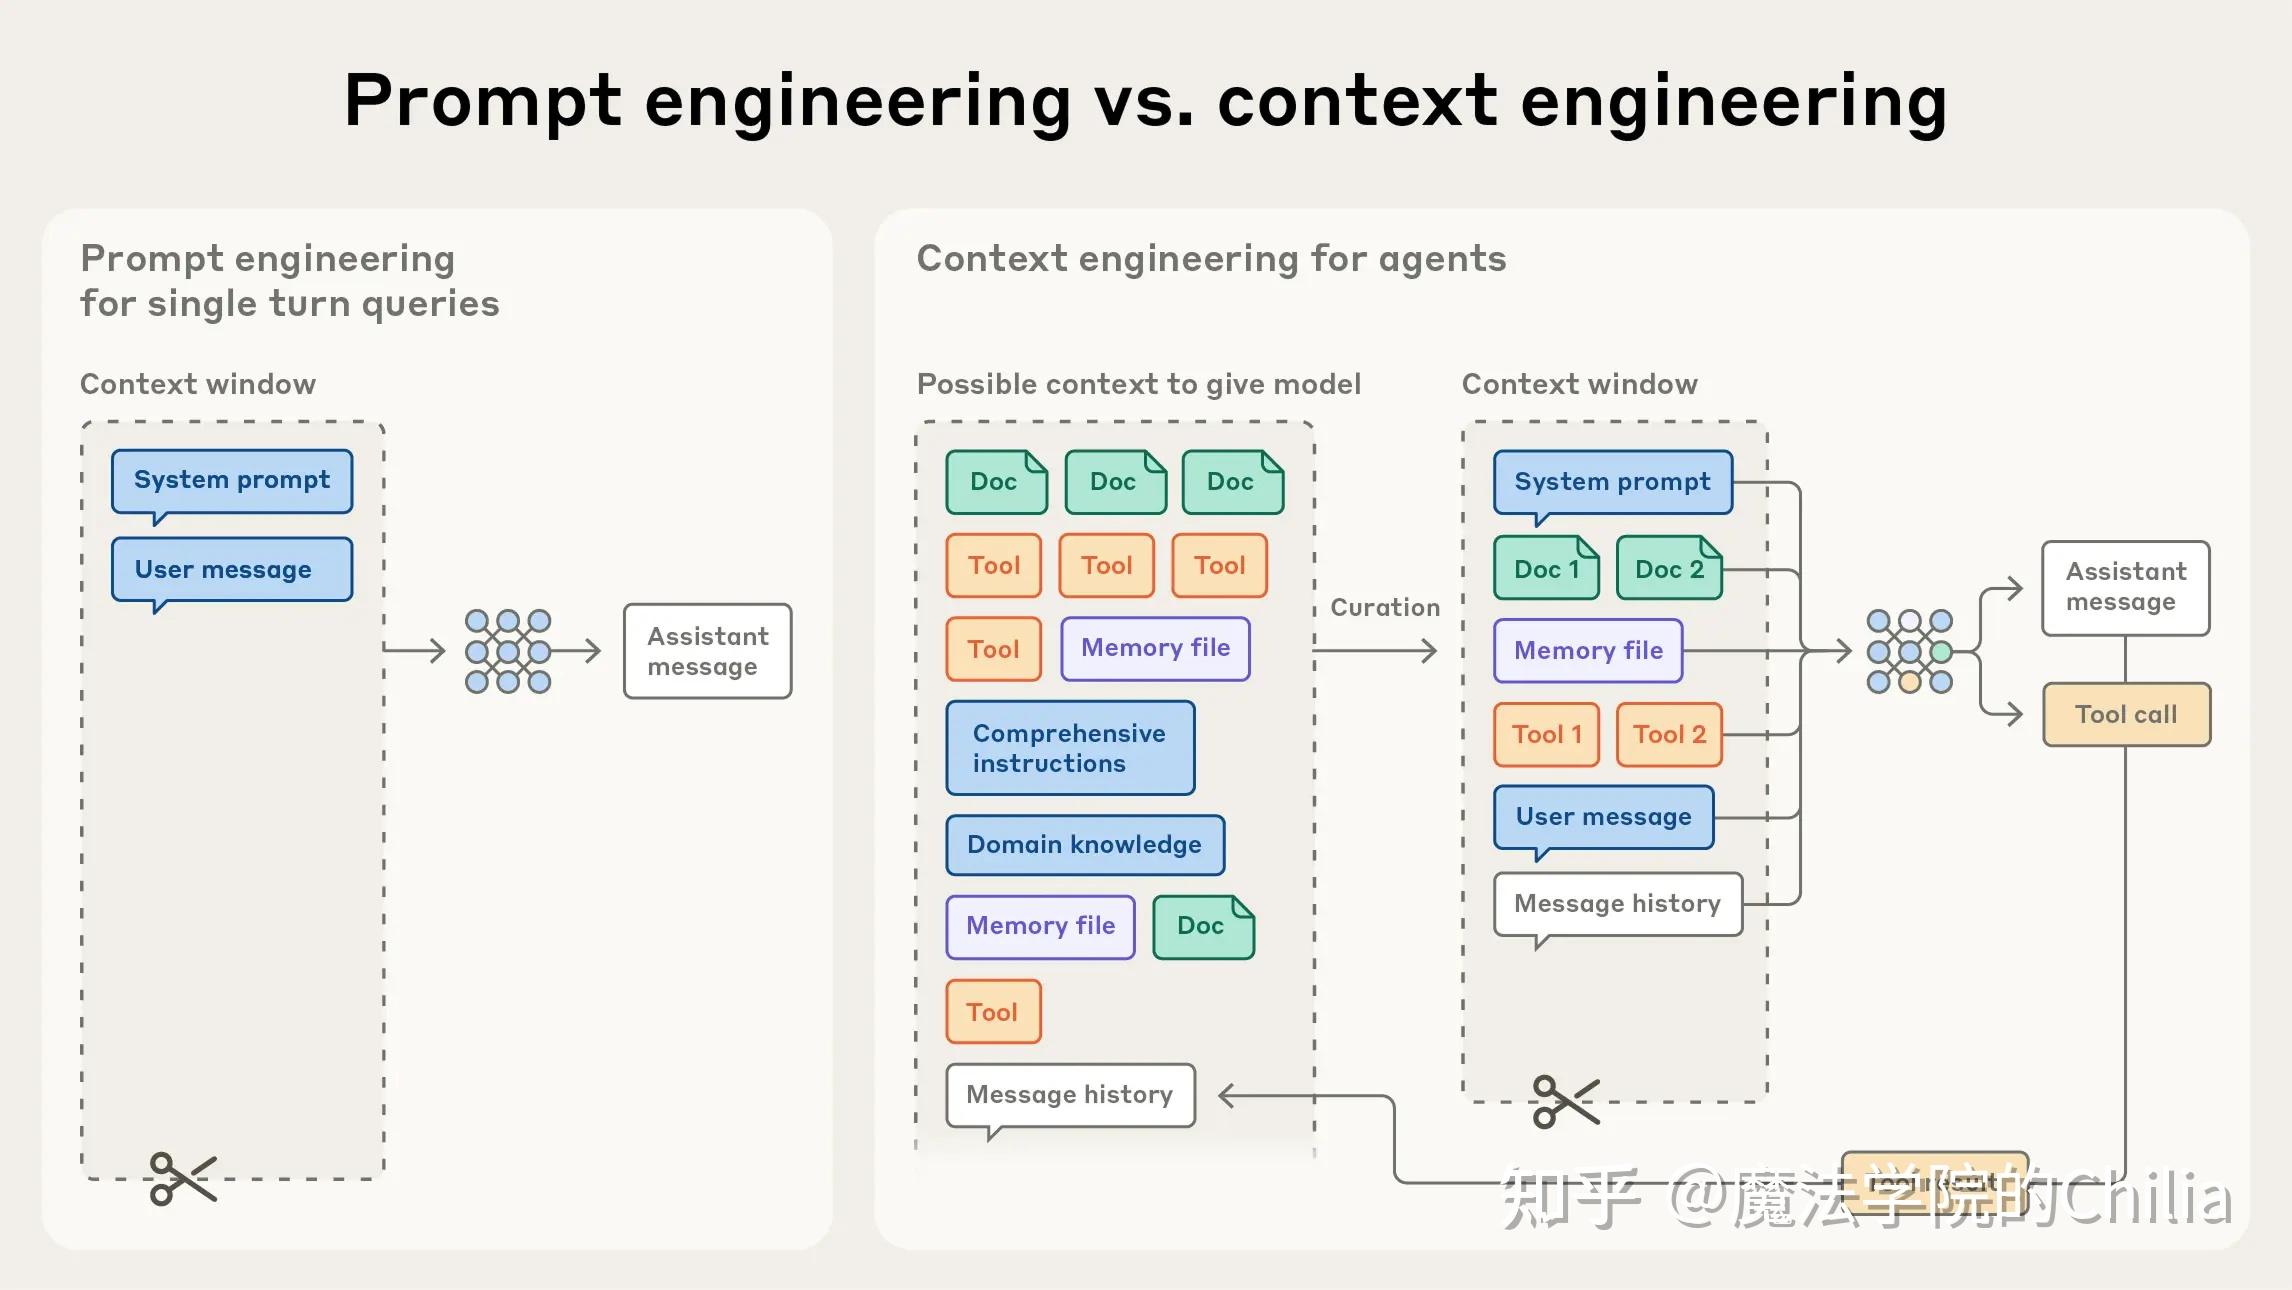
左:prompt engineering 面向单轮任务;右:context engineering 需要从海量信息(文档、工具、记忆文件等)中筛选,形成最优上下文窗口。
(2)为什么 Context Engineering 对构建强大智能体至关重要
Agent 每调用一次工具,就返回一个 Observation,追加到聊天记录里。生产环境的 Agent 可能进行长达数百轮的对话,历史 message 越来越长。而且工具的 Observation 经常特别长——模型执行 Read 读了一个文件的部分内容,或者执行 Bash 输出了很长的 log。
这些长 Observation 不断拼接进上下文,最后很可能超过模型能接受的最长上下文长度(128K ~ 1M)。
更强的模型也一样有 上下文腐败(context rot) 的现象:
虽然现在的 LLM 能接受越来越长的序列,但它们和人类一样,会随上下文增长而注意力涣散——准确回忆信息的能力下降,推理也变慢。
关键的一点是:context rot 会在远低于模型最长序列长度时就出现。比如模型最长支持 1M token,但在 200K token 的时候就已经开始 rot 了。
造成这种现象的两个原因:
- 注意力分散 —— 每个 token 都要关注上下文中的所有其他 token,形成 n² 级别的两两关系。n 变大时,这种关注力被摊薄。
- 训练数据偏差 —— 模型训练时接触的长序列远少于短序列,对长距离依赖的处理经验不足。位置编码插值等技术可以让模型适应更长序列,但通常会牺牲一定精度。
0x02 上下文工程的四种手段
指导原则一句话:找到能够最大化期望输出概率的最小高信号 token 集合。
(1)上下文卸载与检索:把信息转移到文件系统
因为窗口有限,不能把所有信息都塞进短期记忆,而应把信息**「卸载」到外部存储**,需要时再精确检索。
先说为什么不能用截断。 最粗暴的解法当然就是截断,但:
- 一个报错信息可能在日志末尾,截断后 Agent 就无法定位问题
- 一个长列表的中间几行恰好包含重要线索,截断后就拿不到了
- 更根本的问题:Agent 需要基于所有先前状态预测下一步动作,但我们无法提前预判哪个观察结果在十步之后会变得至关重要
所以,任何不可逆的压缩都带有风险。
(a) 把上下文卸载到文件系统(紧凑化 / Compaction)
Manus 提出了一个核心理念:把文件系统视为终极上下文。 理由是文件系统天然具有无限容量、持久化、可随机访问的特性,Agent 可以像人类一样通过路径、文件名、时间戳等元数据来组织信息。
最关键的是:这样的压缩策略是可逆的。 例如:
| 场景 | 做法 |
|---|---|
| 访问网页 | 只要保留 URL,就可以把网页内容从上下文中移除,需要时重新请求 |
| 处理文档 | 只要保留文件路径,就可以省略内容,需要时用 cat / tail 读取 |
| 处理日志 | 完整的输出 content 可以移除,只保留一个 path |
这种「可逆压缩」确保上下文长度缩减的同时,信息并未真正丢失——它们只是被卸载到文件系统里了,随时可以重新加载进来。
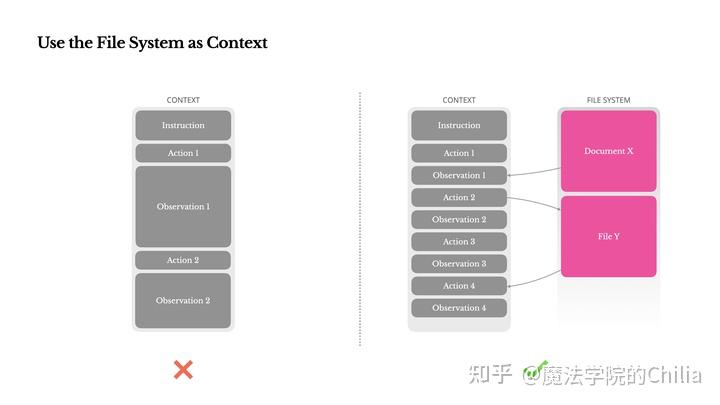
Manus 也鼓励 Agent 主动把中间结果写入文件:执行一个复杂查询后,把结果保存到 output.log,然后上下文中只保留一句话——「结果已写入 /tmp/query_result.json」。Agent 后续可以用 head / tail / grep 渐进式地查看,或一次性读取整个文件。既减少上下文占用,又保留完整信息。
(b) 检索:推理前检索 vs. “Just-in-time” 检索
很多早期 Agent 依赖 RAG(Retrieval-Augmented Generation)这种「推理前检索」方式:预先对知识库文本做向量化,推理前预先检索相关片段。
但 Manus、Claude Code 这些新锐 Agent Scaffold 采取了不同方法:弱化甚至抛弃 RAG,转而让 LLM 自己生成搜索命令,像人类一样主动探索大文件或代码库——即 “just-in-time” 检索。
为什么要弱化 RAG? 因为 RAG 包含的组件太多、太复杂:某个步骤稍有差池,整体效果就受影响。比如——
- 如何对代码合理分块?按函数、按行数,还是按语法结构?
- 选什么 embedding 模型?如何计算相似度?
- 对于非结构化数据(PDF、图片),RAG 很难有效处理
如果说从 Claude Code 等 SOTA agent 框架中学到了什么,那就是 “Keep Things Simple, Dummy”:让框架的逻辑尽可能简单,把有难度的事情交给模型本身。
“Just-in-time” 检索的优势(以 Claude Code 为例):
- Claude Code 处理大型数据时,会生成复杂的 Bash 命令(ripgrep、jq、find 等),利用自己对代码的深刻理解,用精细而复杂的正则表达式定位相关代码块,无需把大段数据加载进上下文
- 这也模仿了人类认知:我们不会记忆所有信息,但知道什么时候该查找、知道去哪里查找
具体优势有两点:
- 灵活性 —— 搜索内容可根据当前需求动态调整,不受预索引限制。RAG 索引需要定期更新,而直接搜索始终反映最新状态。
- 渐进式寻找 —— debug 时,Agent 可以像人一样:先
grep查找函数定义 → 再搜索调用这个函数的位置 → 再打开某个文件查看上下文。每一步都基于前一步的结果。
(2)上下文摘要(Context Summarization)
当上下文窗口即将被填满、且没有办法进一步做紧凑化的时候,只能采用另一种手段:摘要化。
这是一种有损压缩——把对话历史浓缩成一段摘要来释放空间。但它必然导致信息模糊和丢失:模型无法再访问精确的代码行,或工具输出的完整内容。
因此两条纪律:
- 摘要化只能作为上下文窗口即将耗尽时的最后手段
- 摘要化必须设计得可恢复
怎么做到可恢复? 把完整对话历史 dump 到一个持久化文件。这个文件像一个黑匣子,保留所有原始消息、工具调用及其结果。Agent 在后续交互中如果发现摘要缺少关键细节,可以通过工具(grep、Read)主动检索这个历史文件,找回丢失的信息。
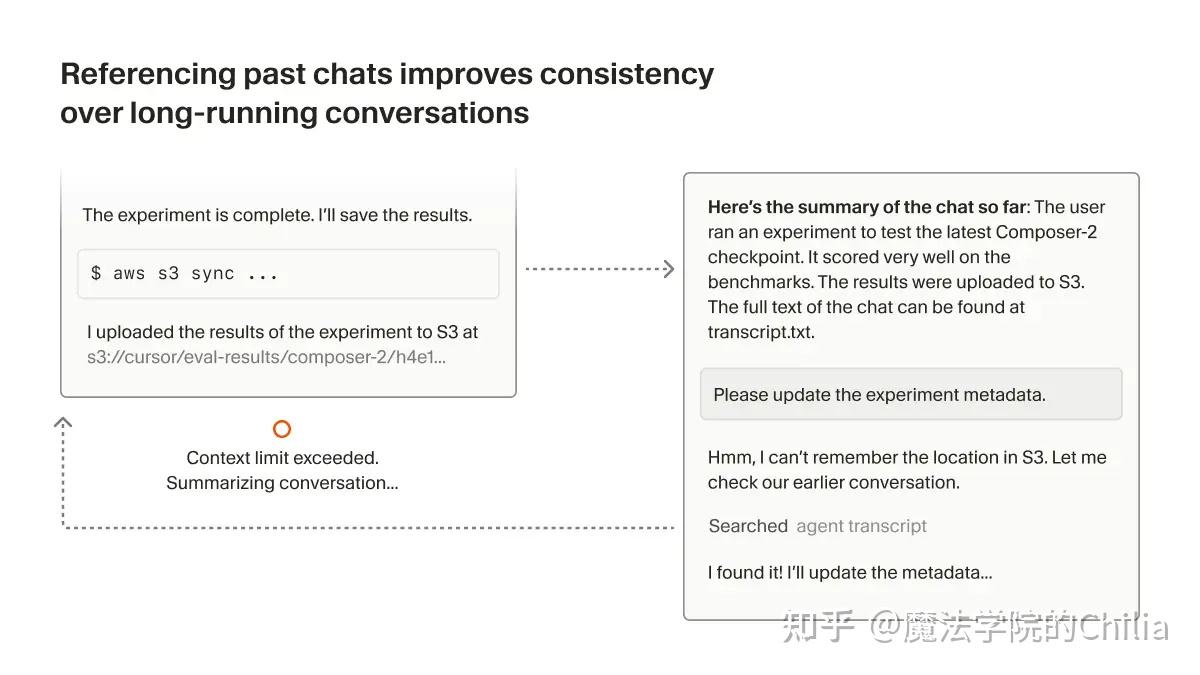
为了确保模型能平滑地继续工作,通常还会保留最后几次完整的工具调用及其结果。这样模型能清楚知道自己从何处中断,保持风格和语气的连贯性,避免因上下文重置而失忆。
什么时候用紧凑化,什么时候用摘要化?
| 优先级 | 手段 | 说明 |
|---|---|---|
| 优先 | 可逆的紧凑化 | 大文件输出写入磁盘,上下文只保留路径 |
| 兜底 | 带备份的摘要化 | 已经无法再紧凑化、且窗口确实即将耗尽时——先完整 dump 聊天记录,再摘要,让有损压缩变得可恢复 |
两者结合,Agent 理论上就能处理无限长的任务,而无需无限大的上下文窗口,同时保留关键信息——在有限中创造无限。
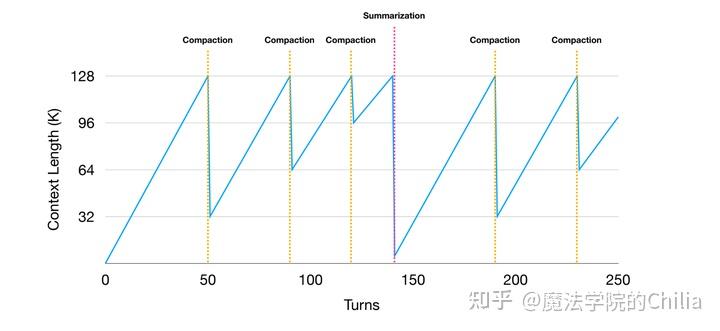
图中可以看到:随着 Turn 增加,上下文长度反复触顶,每次都靠 Compaction 压回去;只有到最后无法再压时,才动用一次 Summarization。
Claude Code 的压缩流程
两种触发方式:
- 自动触发 —— Claude Code 会监控当前上下文的 token 使用量,当对话内容接近模型窗口上限时,系统自动触发压缩
- 手动触发 —— 用户可通过
/compact命令主动执行
压缩输出的摘要骨架(原文给出了脱敏后的结构,九段):
1 | |
⚠️ 最关键的一点:摘要末尾会附上完整 transcript 的路径——
read the full transcript at: /root/.claude/projects/PATH/SESSION_ID.jsonl
也就是说,原始对话被完整保存到了本地 JSONL 文件中。如果需要精确的代码片段或变量名,Agent 完全可以按照摘要的提示,主动读取该 JSONL 文件相应部分来「回忆」。这种方式牺牲了即时访问的便利性,但确保了信息的可恢复性。
(3)上下文隔离(多智能体架构)
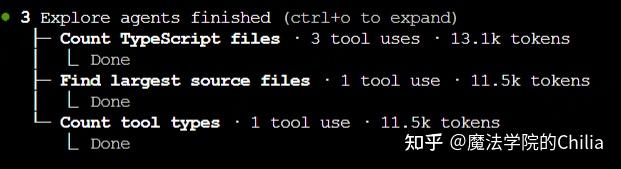
面对复杂任务,可以把任务分解,由主智能体协调多个专门化的子智能体(sub-agents)处理具体任务。每个子智能体拥有干净的上下文窗口,运行在自己的窗口里,有独立的 system prompt 和工具权限(tool access)。主 Agent 根据每个 subagent 的功能描述,自动决定什么时候把什么任务委托(delegate)给哪个 subagent;用户也可以直接显式指定。
四个好处:
| 好处 | 说明 |
|---|---|
| 节省主 Agent 上下文 | 子智能体的上下文与主 Agent 隔离,所以它可以深入探索、产生较多 token 也不要紧,反正不会污染主对话;只返回精简摘要给主 Agent |
| 权限控制 | 限制 subagent 可用的工具(如某些 Agent 只能执行只读操作)。Claude Code 内置的 Explore 就是只读 agent,专门用于搜索和分析代码库;General-Purpose 则是全能型 |
| 特定领域专业化 | 为特定领域编写专门的系统提示,提高任务质量。Claude Code 内置了多个:Explore(代码库探索)、Plan(理解代码库并规划)、General-Purpose(探索 + 修改) |
| 节约调用成本 | 把简单任务路由到更快、更便宜的模型。Claude Code 中 Explore 任务简单,用的是快速低成本的 Haiku;Plan 和 General-Purpose 较复杂且重要,继承主 Agent 模型(通常 Sonnet 或 Opus) |
多智能体架构对上下文管理的核心贡献:每个 subagent 拥有完全独立的上下文窗口,不与主对话共享历史。subagent 看不到主对话的早期交互(除非显式传递信息),主对话的上下文也不会被 subagent 的输出污染。
举例:一些会产生大量输出的任务(运行测试、获取文档、处理日志),主 Agent 就把它委托给 subagent,让详细输出留在 subagent 的上下文里,只把摘要返回主对话,从而保持主对话上下文简洁。
分类一:按运行模式
| 模式 | 行为 | 权限怎么给 |
|---|---|---|
| 前台运行 | subagent 运行时阻塞主对话,用户必须等它完成才能继续与主 Agent 交互 | 每个操作的 permission 实时传给用户,用户实时决定要不要 accept |
| 后台运行 | subagent 在后台运行,用户可以在它执行的同时继续与主 Agent 进行其他对话 | 因为用户没法实时决定各操作是否 accept,所以在启动 subagent 之前就收集所需的权限,运行中自动拒绝未批准的操作请求,然后自动运行 |
分类二:按调用关系
- 并行调用 —— 多个 subagent 同时独立运行,彼此无依赖。例如同时让多个 subagent 分别分析不同模块,最后由主 Agent 汇总结果。
- 链式调用 —— 多个 subagent 顺序执行,后一个依赖于前一个的输出。例如先用
code-reviewer找出性能问题,再用optimizer根据 review 结果进行优化。
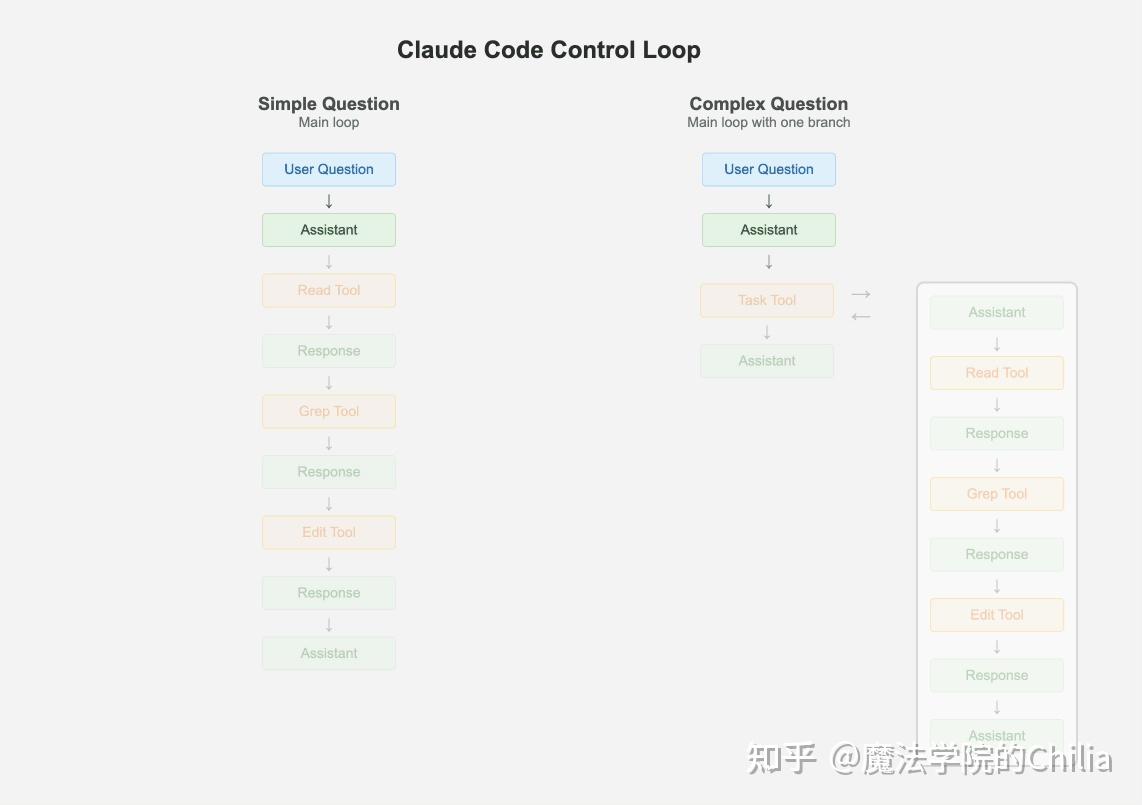
Claude Code 的极简设计(”Keep Things Simple, Dummy” 的典范):
- 当遇到需要分解为多个子任务的情况时,主 Agent 生成自己的克隆作为子 Agent
- 但每个子 Agent 不能再派生出更多子 Agent —— 这是为了避免无限递归和过度复杂的嵌套
- 每个子 Agent 执行完毕后,其结果以工具响应的形式返回主历史,主 Agent 继续推进
- 此外,主 Agent 内部有一个 TODO list,跟踪需要完成的子任务,始终关注着最终目标
一个实际调用示例:作者让主 Agent 分析 opencode 项目的 agent 系统(找出关键入口文件、核心数据结构、sub-agent 如何被调用),主 Agent 调用了一个 General-Purpose subagent 并在后台运行:
1 | |
这个任务触发了 Glob → Grep → 多次 Read → Write 等多种工具,约两分钟后完成,屏幕上出现 ● Agent "Analyze opencode agent system" completed,报告已生成好。
(4)上下文缓存
什么是 KV Cache
Transformer 模型在生成每个 token 时,需要计算所有之前 token 的 Key 和 Value 向量,用于注意力机制的计算——这些 KV 向量就构成了上下文的状态。KV Cache 就是把这些中间计算结果保存下来,当后续请求包含相同前缀时,可以直接复用,避免重复计算。
Prefill(预填充):指在生成第一个输出 token 之前,模型对所有输入 token 进行并行处理的阶段。在这个阶段,模型计算每个输入 token 的 K/V 向量,构建用于后续解码的 KV Cache。
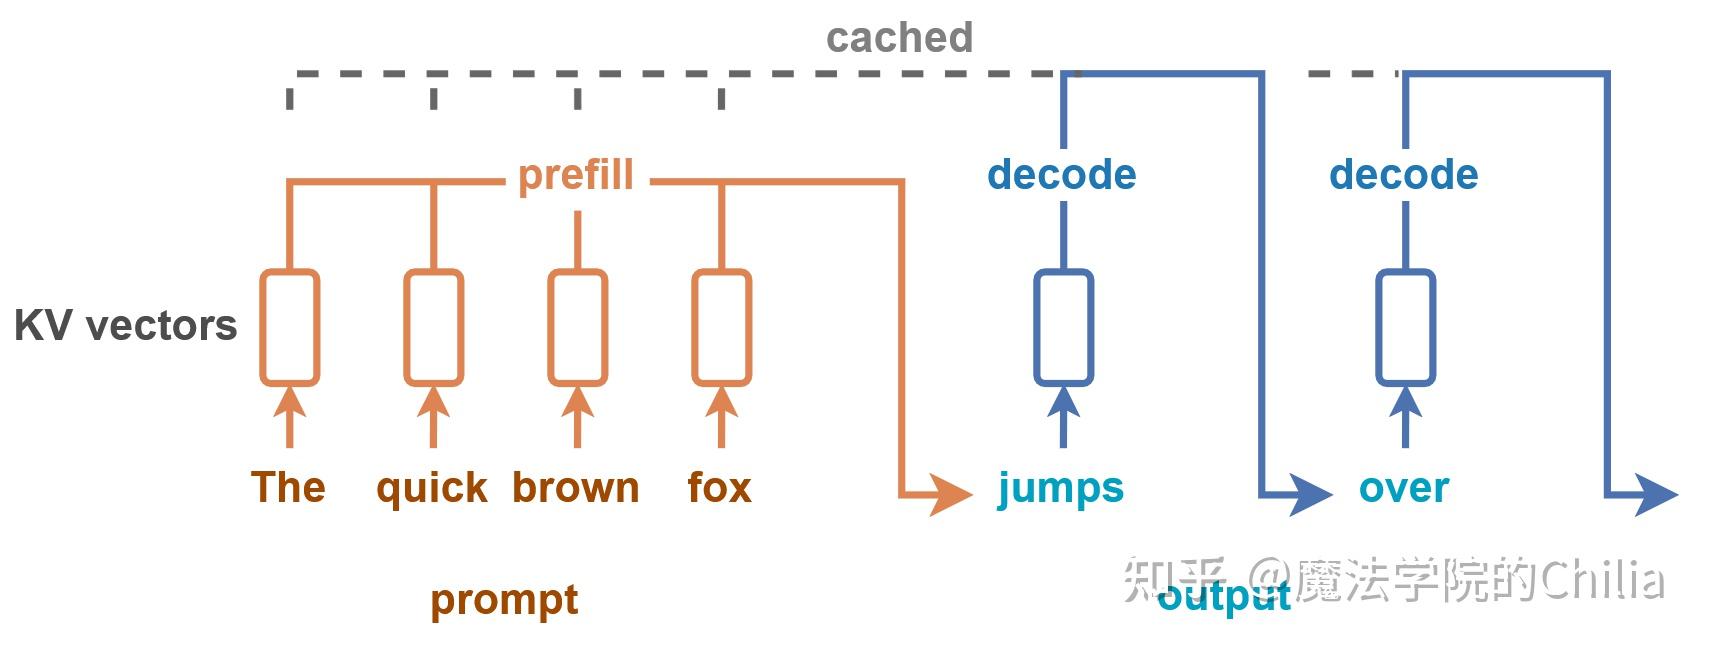
为什么缓存对 Agent 至关重要
Agent 的工作流程通常是多轮工具调用的重复:
1 | |
随着轮次增加,上下文不断增长,而每次模型的输出长度相对较短。有统计表明,平均 Agent 的输入输出 token 比高达 100:1——这意味着每轮推理的大部分时间都花在处理历史上下文上。
- 没有缓存 → 每次请求都要从头计算所有历史 token → 延迟、成本剧增
- 有 KV Cache → 复用相同 prefix 的结果。多轮对话中前几轮历史作为 prefix 被缓存,后续请求只需处理新追加的内容。这样即使上下文很长,TTFT(Time to First Token,首字延迟)仍能保持很低
成本差距也非常大:以 Claude Sonnet 为例,缓存输入 token 为 0.30 美元/百万 token,而未缓存的则高达 3 美元/百万 token——相差 10 倍。
KV 缓存的 Agent 设计原则(以 Claude Code 为例)
缓存命中的前提是:新请求的前缀与已缓存的内容完全一致——哪怕多一个空格、换行符,或者 JSON 键的顺序不同,都会导致缓存失效。
所以核心原则是:上下文只追加,不修改。
- 不要试图在 system prompt 开头加入时间戳、会话 ID 等变化的内容,而是始终以追加方式添加新内容
- 如果需要对历史进行修正,使用新的消息,而不是直接修改已有记录
- 确保序列化确定性 —— 许多编程语言在序列化 JSON 时不保证键顺序,导致相同内容产生不同哈希值。例如 Python 的
json.dumps(obj)默认键无序,而sort_keys=True可保证稳定顺序
Claude Code 有自动缓存和手动缓存两种模式:
① 自动缓存 —— 在请求顶层添加一个 cache_control 字段,系统就会自动将最后一个可缓存的内容块作为缓存断点,把整个请求 prefix(从开头到该块)存入缓存。默认缓存生命周期是 5 分钟,每次命中缓存会自动刷新、延长 5 分钟;通过付费可以将这个时间延长到 1 小时。
1 | |
1 | |
② 显式断点 —— 对稳定性极高的内容(如 system prompt、工具定义)使用显式断点,确保它们被缓存。
⚠️ Claude Code 允许最多 4 个缓存断点(包括显式和自动缓存)。自动缓存会占用其中一个槽位——所以如果已经设置了 4 个显式断点,自动缓存将会失败。
自动缓存与显式缓存结合的示例:
1 | |
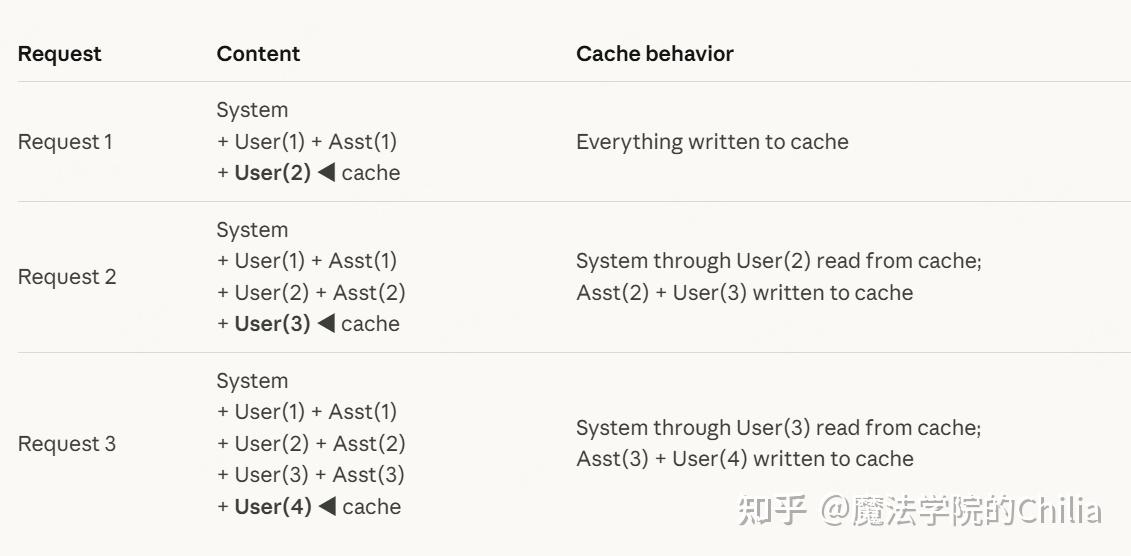
从图中可以看到缓存的滑动行为:每个请求都把「已缓存前缀」读到,只把新增的那条消息写入缓存——缓存断点随上下文增长而不断后移,同时 System 这类稳定前缀始终命中。
参考
原文与作者引用的资料(均来自原文末尾):
- 原文:万字长文解析 Agent 框架中的上下文管理策略 —— 知乎 @魔法学院的Chilla
- Effective context engineering for AI agents —— Anthropic
- Decoding Claude Code —— MinusX
- Context Engineering for AI Agents: Lessons from Building Manus —— Manus
- Claude 官方文档
一页速览
| 手段 | 一句话 | 可逆? | 何时用 |
|---|---|---|---|
| 卸载到文件系统 | 大内容写盘,上下文只留路径/URL | ✅ 可逆 | 优先 |
| Just-in-time 检索 | 让模型自己生成搜索命令,别预建索引 | ✅ | 替代/弱化 RAG |
| 摘要化 | 对话压成摘要 | ❌ 有损 | 最后手段,且必须先 dump 原始记录 |
| 上下文隔离 | 子 Agent 独立窗口,只回传摘要 | — | 任务可分解、或产出量巨大时 |
| KV Cache | 前缀不变才能复用;只追加不修改 | — | 所有多轮 Agent 场景 |
贯穿全文的一条主线:优先可逆的手段,把有损压缩留到最后;把复杂性交给模型,把框架做简单。