JVM
JVM内存区域(Java内存区域详解(重点) | JavaGuide)
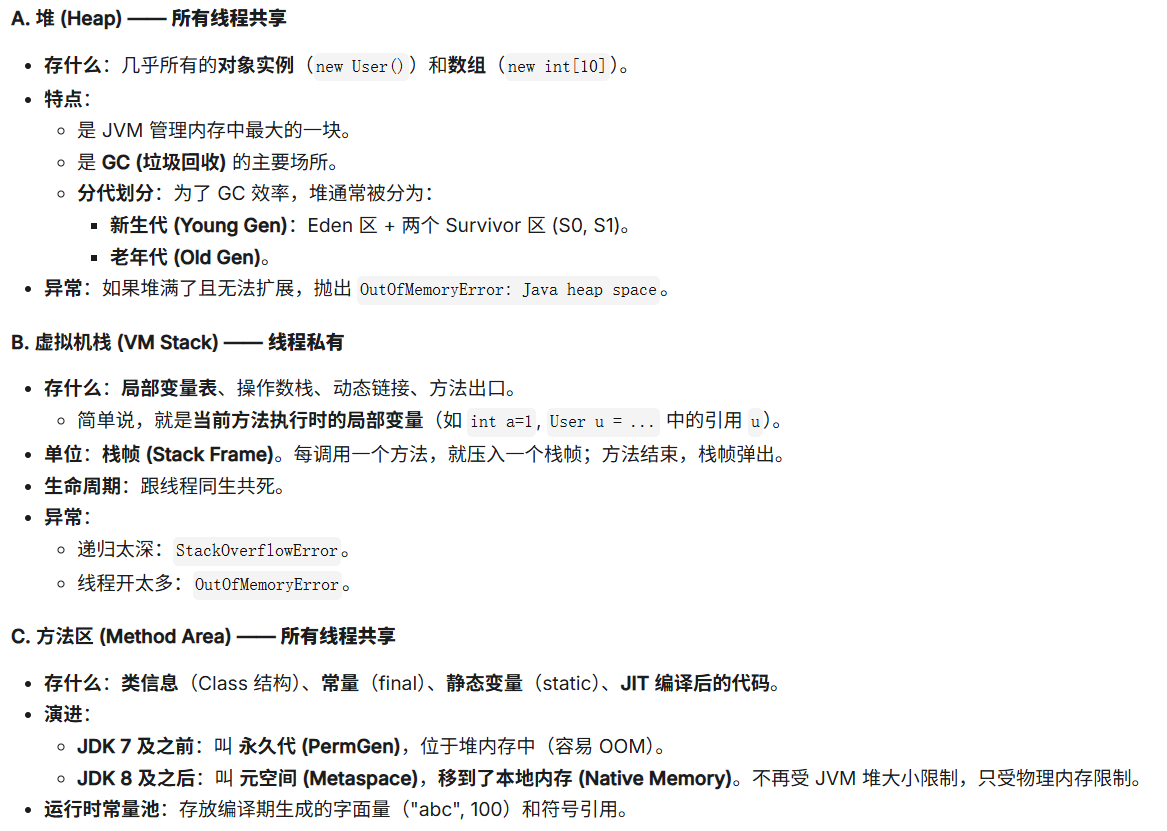
D. 本地方法栈 (Native Method Stack) —— 线程私有
- 存什么:为 native 方法服务(如 System.currentTimeMillis() 这种 C++ 写的底层方法)。
E. 程序计数器 (PC Register) —— 线程私有
- 存什么:当前线程执行到的字节码行号。
- 作用:线程切换回来后,知道接着从哪一行开始执行。
- 特点:唯一一个不会发生 OOM 的区域。
谈谈你理解的堆内存和栈内存,说说他们之间的区别;
| 特点 | 堆(Heap) | 栈(Stack) |
|---|---|---|
| 内存分配方式 | 动态分配(运行时) | 自动分配(编译时确定大小) |
| 管理方式 | 手动管理(程序员或GC) | 自动管理(函数调用时分配和释放) |
| 存储内容 | 对象实例、动态数据 | 局部变量、函数参数、返回地址 |
| 生命周期 | 不确定,需手动释放或由GC回收 | 随函数调用开始和结束自动分配和释放 |
| 访问速度 | 较慢 | 快 |
| 空间大小 | 较大 | 较小 |
| 碎片问题 | 可能存在内存碎片 | 不存在内存碎片 |
| 线程共享 | 线程间共享 | 线程独立 |
垃圾回收算法,*判断垃圾的方法有哪些?,垃圾回收器(JVM垃圾回收详解(重点) | JavaGuide)
知道full GC的虚拟机调优吗
“针对 Full GC 的调优,我的核心策略是 ‘将对象尽可能留在新生代’。
- 首先,我会分析 GC 日志。如果发现 Full GC 频繁,且老年代增长很快,通常说明新生代太小或者晋升过快。
- 我会尝试调大新生代 (-Xmn),让短命对象在 Young GC 阶段就被回收掉,减少流向老年代的数量。
- 如果应用是大内存服务(如 8G+),我会切换到 G1 收集器,并设置 -XX:MaxGCPauseMillis,利用 G1 的 Mixed GC 代替传统的 Full GC,从而控制停顿时间。
- 最后,我会检查代码,杜绝 System.gc() 的显式调用(通过 -XX:+DisableExplicitGC)。”
JVM堆、栈的原理和区别
哪些可以作为Gc Root,G1垃圾回收器的特点,会产生停顿嘛?(深入JVM:详解G1垃圾回收器原理-CSDN博客)G1 垃圾回收器中的可预测停顿模型是如何实现的?
哪些对象可以作为 GC Roots 呢?
- 虚拟机栈(栈帧中的局部变量表)中引用的对象
- 本地方法栈(Native 方法)中引用的对象
- 方法区中类静态属性引用的对象
- 方法区中常量引用的对象
- 所有被同步锁持有的对象
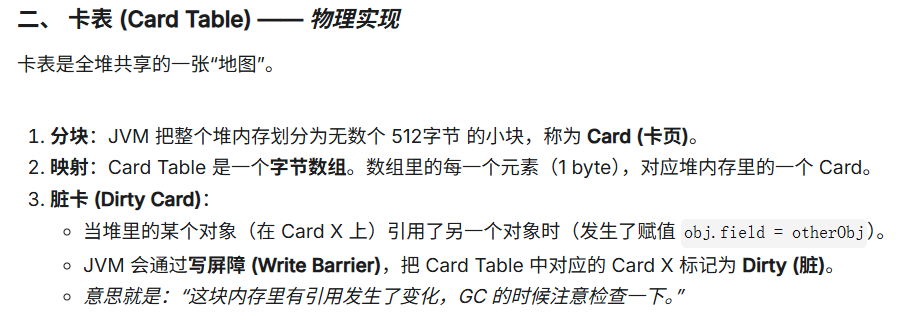
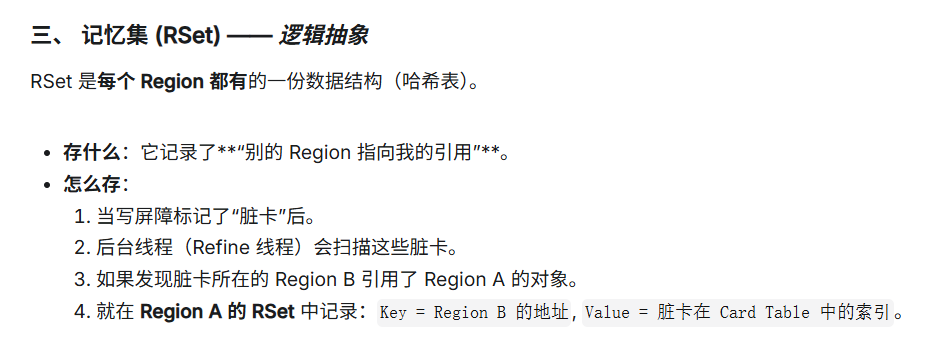
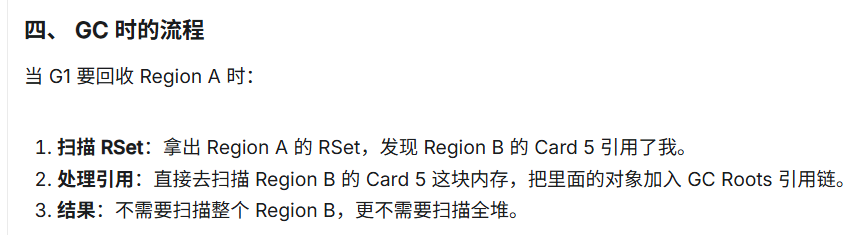
第一阶段:运行时赋值(埋雷)
场景:代码正在运行,老年代对象 OldObj(位于 Region A)的字段引用了新生代对象 YoungObj(位于 Region B)。
代码:OldObj.field = YoungObj;
- 拦截(Write Barrier):
JVM 不会直接干巴巴地执行赋值。在赋值操作完成后,写屏障(Post-Write Barrier) 像一个安检员一样拦截了这个操作。 - 标记脏卡(Mark Dirty):
写屏障根据 OldObj 的内存地址,算出它属于哪个 卡页(Card Page)。然后把全局 卡表(Card Table) 中对应的位置标记为 Dirty(脏)。- 潜台词:“注意!Region A 的第 X 页这块地儿有情况!”
- 入队(Enqueue):
为了不卡顿主线程,G1 不会立刻去更新复杂的 RSet 数据结构。它只是把这个“脏卡页的坐标”丢到一个 线程本地的脏卡队列(Dirty Card Queue) 里,然后主线程就继续跑业务代码了。
第二阶段:异步处理(传导)
场景:后台默默工作,不影响业务线程。
后台线程处理(Refinement Threads):
JVM 内部有一组 并发优化线程(Concurrent Refinement Threads)。它们发现脏卡队列里有东西了,就取出来处理。更新 RSet(关键一步):
线程拿到“Region A 的第 X 页”这个坐标,它会去解析这一页,发现这里指向了 Region B。
于是,它找到 Region B 的记忆集(RSet),在里面记上一笔:“Region A 的第 X 卡页 引用了我!”
- 注意方向:RSet 是“谁引用了我”。所以是 Region B(被引用者)记录了 Region A(引用者)的位置。
三阶段:GC 发生时(扫雷)
场景:发生了 Young GC,我们要回收 Region B(新生代)。
- 面临问题:
我们不知道 YoungObj 是不是活的。如果全堆扫描 Region A(老年代)太慢了。 - 查 RSet:
GC 线程直接打开 Region B 的 RSet。
RSet 告诉它:“别瞎找了,去 Region A 的第 X 卡页 看看,那里有人引用我。” - 精准扫描:
GC 线程直接跳到 Region A 的第 X 卡页(只有 512 字节),扫描这一小块内存。
它立刻发现了 OldObj 引用着 YoungObj。 - 标记存活:
YoungObj 被标记为存活,复制到 Survivor 区,逃过一劫。
GC年轻代回收的过程,GC的时机,什么时候会触发full GC,触发了该怎么排查处理(JVM: GC过程总结(minor GC 和 Full GC)-CSDN博客)
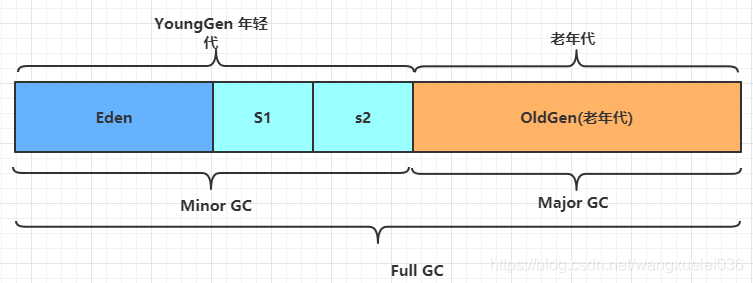
- Eden:这是对象最初诞生的区域,并且对大多数对象来说,这里是它们唯一存在过的区域。
- Survivor区: 存活区,每次Minor GC 完后,将仍然被引用的对象存放的区域,有两个同样大小的区域。
full gc触发了该怎么排查处理
- 出现异常可以先通过jstat、jmap等分析一下堆的情况,以及gc情况。
- 通过分析gc日志可以快速定位gc触发的原因,以及堆的变化。
- 如果是System.gc主动触发,可以通过阿里开源的arthas去拦截得到调用链。
CMS 和 G1 垃圾收集器的区别?
一、 核心架构区别
1. 内存布局
- CMS (Concurrent Mark Sweep)
- 物理分代:堆内存被物理隔离为一块连续的 Eden、两块 Survivor 和一块连续的 Old (老年代)。
- 职责单一:CMS 专门负责回收老年代(通常配合 ParNew 回收新生代)。
- G1 (Garbage-First)
- Region 分区:堆被切分成几千个大小相等的小方块(Region)。
- 逻辑分代:这些 Region 物理上不连续,但逻辑上被标记为 Eden、Survivor 或 Old。
- Humongous:专门处理大对象的区域。
2. 回收算法
- CMS:标记-清除 (Mark-Sweep)。
- 致命伤:内存碎片。就像切蛋糕切得乱七八糟,最后剩下一堆碎渣。虽然总量够,但放不下一个大盘子,导致频繁触发 Full GC(STW)来整理碎片。
- G1:标记-整理 (Mark-Compact)(整体看)/ 复制 (Copying)(局部看)。
- 优势:G1 把存活对象从一个 Region 复制到另一个 Region。这天然起到了整理内存的作用,没有碎片。
二、 核心特性区别
1. 停顿模型 (Pause Prediction) —— G1 的杀手锏
- CMS:尽力而为。它尽量并发执行,减少停顿,但如果碎片太多导致 Full GC,可能会卡死很久(不可控)。
- G1:可预测停顿。
- 你可以设置 -XX:MaxGCPauseMillis=200。
- G1 会去算每个 Region 里有多少垃圾,回收大概要多久。
- Garbage-First:它会挑出那些**“垃圾最多、回收价值最大”**的 Region,优先回收它们,确保在 200ms 内搞定。不求扫完,只求不超时。
JVM 层次 一个new Object 从创建到GC的完整过程
1.java对象的创建
- 查看类是否加载,未加载则加载类
- 分配内存,对象初始化,Eden区 分配内存(除非对象过大直接进入老年代)。
2.对象存活阶段
年轻代存活周期
- 首次Minor GC:当Eden区满时触发 Minor GC:
- 标记存活对象:通过 可达性分析(Reachability Analysis) 判断对象是否被GC Roots引用。
- 复制到Survivor区:存活对象被复制到 Survivor区(S0/S1),年龄(Age)+1。
- 清空Eden区:回收Eden区中不可达对象的内存。
Survivor区的晋升
- 年龄阈值:对象每经历一次Minor GC且存活,年龄增加1。当年龄达到阈值(默认15,可通过 -XX:MaxTenuringThreshold 调整)时,晋升到 老年代(Old Generation)。
- 动态年龄计算:若Survivor区中相同年龄对象的总大小超过Survivor区容量的一半,年龄≥该值的对象直接晋升老年代。
对象不可达则进行垃圾回收
jvm内存区域,堆为什么要分成新生代和老年代
大多数 Java 对象“朝生暮死”,少数对象“命长”——基于这个特性,堆分代可以显著提高垃圾回收(GC)的效率。
栈内存泄漏和堆内存泄漏(JVM系列之六:内存溢出、内存泄漏 和 栈溢出 - 海米傻傻 - 博客园)
第一步:现象确认(怎么发现的?)
“首先,通常是运维监控(如Prometheus/Zabbix)报警,发现线上服务堆内存(Heap)占用率持续上升。
我会先通过监控或 jstat -gcutil
1000 观察 GC 情况。如果发生内存泄露,典型的特征是:频繁触发 Full GC,但 Old Gen(老年代)的占用率在 GC 后并没有明显下降,且底线在不断抬高。”
第二步:保留现场(怎么取证的?)
“确认是泄露后,我需要获取堆内存快照(Dump 文件)。
- 如果是正在运行的服务,我会用 jmap -dump:live,format=b,file=heap.hprof
命令导出。注意加上 live 参数,只导出存活对象,减小文件体积。 - 为了防止服务直接 OOM 挂掉没留现场,我们线上通常配置了 -XX:+HeapDumpOnOutOfMemoryError 参数,让 JVM 在崩溃前自动生成 Dump 文件。”
第三步:工具分析(核心步骤,重点讲 MAT)
“拿到 hprof 文件后,我会使用 Eclipse MAT (Memory Analyzer Tool) 进行分析,重点看三个地方:
- 看直方图 (Histogram): 按 Retained Heap(深堆)倒序排列,看哪种类型的对象实例数量异常多,占用内存最大。
- 看支配树 (Dominator Tree): 找出内存占用最大的对象实例(Big Object)。
- 查 GC Roots 引用链 (Path to GC Roots): 这是最关键的一步。选中可疑的大对象,查看它到 GC Roots 的引用链(排除软/弱/虚引用)。
目的是找到:究竟是哪个静态变量、哪个线程或者哪个缓存容器,强引用了这个对象,导致它无法被回收。”
第四步:常见原因(展示知识储备)
“根据排查经验,找到引用链后,通常对应以下几种代码问题:
- 静态集合类滥用: 比如定义了 static Map 做缓存,只 put 不 remove,导致对象越积越多。
- ThreadLocal 未清理: 在线程池场景下,使用 ThreadLocal 存数据,请求结束时忘记调用 remove(),导致线程复用时内存无法释放。
- 资源未关闭: 数据库连接、IO 流没在 finally 或 try-with-resources 中关闭。
- 内部类引用: 非静态内部类隐式持有外部类引用,导致外部类无法回收。”
本地缓存为什么不安全
CPU飙升占用率过高排查==(linux cpu飙高原因排查(有手就行)_linux cpu故障注入报告-CSDN博客)
“遇到 CPU 飙高,我会按以下步骤排查:
先用 top 确认是哪个进程,并观察是用户态高还是内核态高。
再用 top -H -p 找到最耗 CPU 的具体线程 ID,并转为十六进制。
接着用 jstack 抓取堆栈,查看该线程在运行哪行代码。
分析原因:
- 如果是业务代码(RUNNABLE),检查是否有死循环、正则回溯或大数据量计算。
- 如果是 GC 线程,结合 jstat 判断是否是 OOM 前兆导致的频繁 Full GC。
- 如果是内核态高,检查是否线程数过多导致上下文切换。
最后根据具体原因,进行代码优化、SQL 优化或增加机器资源。” - 比如高并发下使用了 CAS(乐观锁/自旋锁)。当锁竞争极度激烈时,大量线程在 while 循环里疯狂自旋重试(Spinning),不断消耗 CPU 计算资源却拿不到锁。
“CPU 飙高除了业务代码死循环,一个非常重要的可能性是 JVM 在进行频繁的 Full GC。
这种情况通常是内存泄漏的征兆。当堆内存(特别是老年代)被占满,且大部分都是存活对象时,GC 线程会消耗大量 CPU 去尝试回收,但收效甚微,导致应用线程被长时间暂停,系统吞吐量急剧下降。
排查时,我会先用 jstat 确认 FGC 次数是否异常增多。如果确认是 GC 问题,下一步就是通过 jmap 导出 Heap Dump,再用 MAT 工具去分析是哪个对象导致的内存泄漏。”
ZGC(极致八股文之JVM垃圾回收器G1&ZGC详解)(新一代垃圾回收器ZGC的探索与实践 - 美团技术团队)(从历代GC算法角度剖析ZGC)
1. 核心定位与目标
- G1 (Garbage-First):
- 定位:全能型选手,旨在替代 CMS,成为服务端默认 GC。
- 目标:在吞吐量和延迟之间取得平衡。
- JDK 版本:JDK 9 开始成为默认 GC。
- 适用堆大小:几 GB ~ 几十 GB(比如 6GB - 64GB)。
- 停顿时间 (STW):可控(例如设定 200ms),但在进行 Full GC 或者 Mixed GC 的特定阶段,随着堆变大,停顿时间可能会增加。
- ZGC (Z Garbage Collector):
- 定位:极致低延迟(Low Latency)选手。
- 目标:停顿时间 < 10ms(JDK 16 之前是 10ms,现在甚至能做到 < 1ms),且停顿时间不随堆大小增加而增加。
- JDK 版本:JDK 11 引入(实验),JDK 15 生产可用,JDK 21 分代 ZGC 成为主流。
- 适用堆大小:超大堆(几百 MB ~ 16TB)。即使是 16TB 的堆,停顿依然是毫秒级。
2. 核心架构与原理区别(面试杀手锏)
G1 的核心设计:Region + Remembered Set (RSet)
- 物理分区:将堆划分为几千个大小相等的 Region。
- 逻辑分代:依然保留 Eden、Survivor、Old 的概念,但它们不再是物理隔离的,而是逻辑上的 Region 集合。
- 回收策略:
- Young GC:回收所有年轻代 Region(STW)。
- Mixed GC:回收所有年轻代 + 部分收益最高的老年代 Region(Garbage-First 的由来)。
- 跨代引用:使用 RSet(记忆集) 记录“谁引用了我”。这需要写屏障(Write Barrier)维护,内存占用较大(约占堆的 5%~20%)。
ZGC 的核心设计:Region + 读屏障 + 染色指针
- 物理分区:也有 Region(称为 ZPage),但大小是动态的(小、中、大三种)。
- 无分代(早期) -> 分代(JDK 21+):早期的 ZGC 不分代,全堆扫描;JDK 21 引入了分代 ZGC,性能大幅提升。
- 并发执行:ZGC 几乎所有阶段(标记、转移、重定位)都是并发的,只有初始标记等极短阶段需要 STW。
- 关键黑科技(ZGC 为什么能做到毫秒级停顿?):
- 染色指针 (Colored Pointers):直接在 64 位对象的指针上存储元数据(如 Marked0, Marked1, Remapped),而不是在对象头上。这使得 ZGC 可以在不访问对象内存的情况下感知对象状态。
- 读屏障 (Load Barrier):当你从堆里读取一个对象引用时,ZGC 会插入一段代码检查指针颜色。如果发现指针指向的对象已经被移动了(Relocated),读屏障会自动修正指针地址(自愈能力,Self-Healing)。
- 无 RSet:ZGC 不使用 RSet 处理跨代引用(分代 ZGC 使用了精简版的 RSet),大幅节省内存。
ZGC采用的是标记-复制算法,不过ZGC做了改进,ZGC在标记,转移,重定位阶段基本是并发进行的,ZGC可以实现停顿时间小于10ms,ZGC分为以下几个阶段,初始标记,并发标记阶段,再标记阶段,并发转移准备阶段,初始转移阶段,并发转移阶段.与ZGC对比,G1的转移阶段完全STW的.
ZGC采用了2个关键的技术:着色指针与读屏障,着色指针就是将一些信息存储在指针的技术,在64位地址中,有3个地址视图M0,M1,Remapped,在刚开始整个内存视图都是Remapped,在并发标记阶段,如果对象被GC标记线程或者应用线程访问过,那么就将对象的地址视图从Remapped调整为M0。标记阶段结束之后,对象的地址要么是M0视图,要么是Remapped,果对象的地址是M0视图,那么说明对象是活跃的;如果对象的地址是Remapped视图,说明对象是不活跃的。并发转移阶段,标记结束后就进入转移阶段,此时地址视图再次被设置为Remapped。如果对象被GC转移线程或者应用线程访问过,那么就将对象的地址视图从M0调整为Remapped。
读屏障:就是对象的地址变化了,再次读指向这个对象的指针会重新映射到新地址。
因为初始标记,并发标记,再标记阶段跟G1很像,我介绍一下并发预备重分配,初始迁移,并发迁移三个阶段
一、 转移准备 (Concurrent Prepare for Relocate)
- 核心任务:选出“哪些页面(Page)需要回收?”
- 动作:
- 选页:ZGC 扫描所有页面,根据页面里的垃圾比例,选出一批回收收益最高的页面,放入 Relocation Set (迁移集)。
- 建表:为这些选中的页面,预先分配 Forwarding Table (转发表)。这张表目前是空的,专门用来记录“旧地址 -> 新地址”的映射。
二、 初始迁移 (Relocate Start) —— 短暂 STW
这是 ZGC 整个过程中最关键的 STW 阶段。
- 核心任务:只迁移 GC Roots 直接引用的对象。
- 为什么只迁 Roots?:因为 Roots 数量很少,可以在极短时间内完成,保证 STW 时间极短(毫秒级)。
- 动作:
- 扫描 GC Roots。
- 如果 Root 指向的对象在 Relocation Set 里 -> 立刻搬家(复制到新页) -> 立刻改名(更新 Root 指针为新地址) -> 记录案底(在 Forwarding Table 记录旧址到新址)。
- 如果不在 Relocation Set -> 不动。
三、 并发迁移 (Concurrent Relocate) —— 重头戏
这是最耗时的阶段,但它和用户线程并发执行。
- 核心任务:迁移 堆中剩余的所有存活对象。
- 动作:
- GC 线程遍历 Relocation Set 中的所有页面。
- 把存活对象复制到新页面。
- 在 Forwarding Table 中记录映射关系。
- 关键点:页面里的对象搬空后,这个物理页面其实可以回收了,但 Forwarding Table 不能丢!因为还有很多堆里的普通对象(非 Root)手里拿着旧地址的票,还得靠这张表找新家。
四、 ZGC 的杀手锏:读屏障与指针自愈
这解释了你最后一段提到的场景:如果用户线程访问了一个还没来得及修正引用的对象怎么办?
- 场景:
- 对象 A 已经被 GC 线程搬到了新地址(0x200),Forwarding Table 记了 0x100 -> 0x200。
- 但是,对象 B 里的字段 b.field 依然存着旧地址 0x100。
- 此时,GC 线程还没来得及扫描 B。
- 用户线程突然要读 b.field。
- 读屏障 (Read Barrier):
- ZGC 在用户线程读取引用的那一瞬间(Load 操作),会触发一段代码逻辑。
- 检查:看这个指针的颜色位 (Color Bits)。如果颜色不对(比如是 Remapped 之前的颜色),说明这个对象可能被搬走了。
- 修正 (Self-Healing):
- 去查 Forwarding Table。
- 发现 0x100 确实搬到了 0x200。
- 立刻更新 b.field = 0x200(这就是自愈)。
- 返回新对象给用户。
java虚拟线程(【Java虚拟线程】Java21、SpringBoot3中使用虚拟线程_java 虚拟线程-CSDN博客)(最好与协程对比一下)
虚拟线程在等待 I/O 操作完成时不会阻塞底层的平台线程。JVM 会自动将该虚拟线程“卸载”,让平台线程去执行其他就绪的虚拟线程。当 I/O 操作完成后,虚拟线程会再次被“挂载”到平台线程上继续执行。
下图可以用来表示使用虚拟线程和平台线程(线程池)执行并发任务的区别:
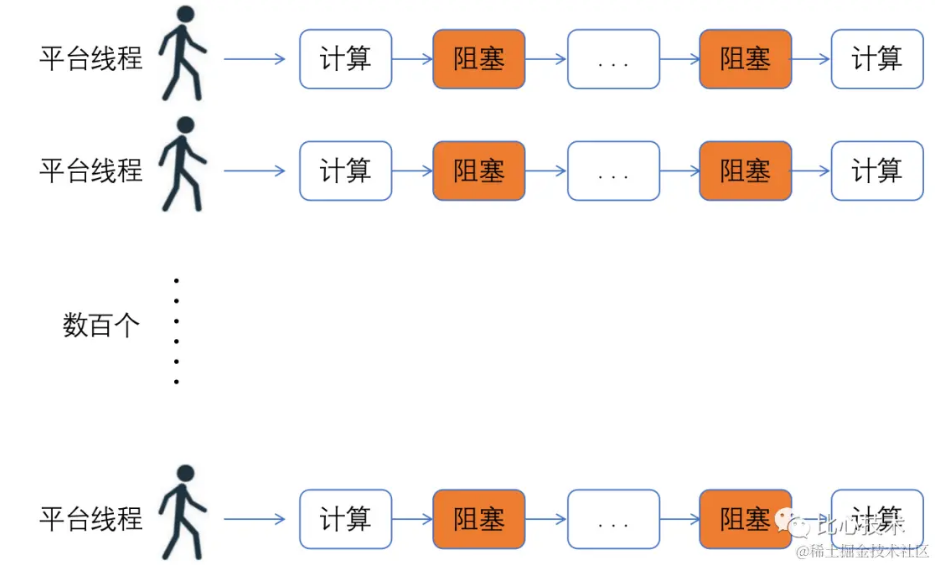
图1-1 线程池处理并发任务
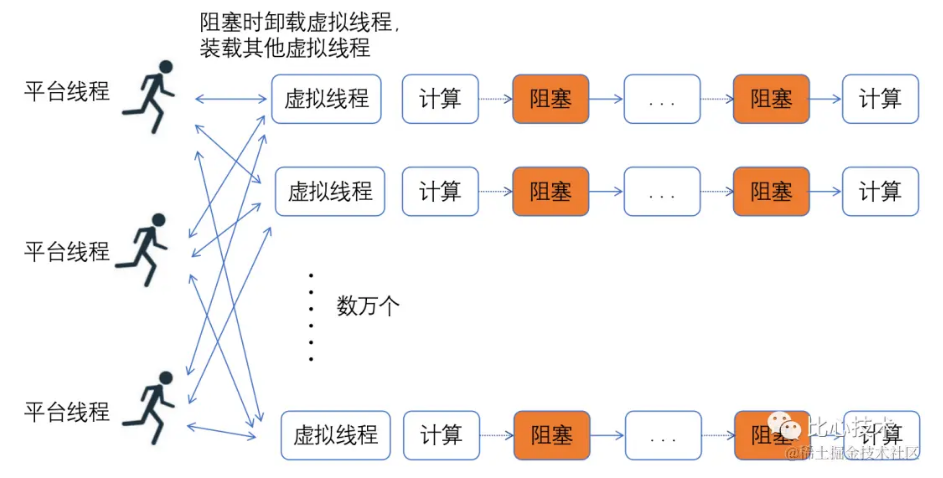
JVM 调优思路(面试官:如何进行 JVM 调优(附真实案例) - 知乎)
一、 核心方法论(展现你的系统化思维)
你可以先总起一句:“在我的经验中,JVM 调优从来都不是为了调优而调优,而是由问题驱动的。通常分为事前规划和事后排查两个阶段。”
1. 事前规划(容量评估与参数设置)
- 内存分配:根据业务场景(是高并发的短生命周期对象多,还是需要缓存的大对象多)来预估内存。例如,通常会将 -Xms 和 -Xmx 设置为相同的值,避免 JVM 运行期间频繁扩容/缩容带来的性能抖动。
- 垃圾回收器选择:
- 如果是吞吐量优先的后台计算服务,可能选择 Parallel GC。
- 如果是延迟敏感的 Web 接口服务,通常选择 G1 GC(或者 JDK 11+ 的 ZGC)。
- 元空间(Metaspace):给 -XX:MaxMetaspaceSize 设定一个合理的上限,防止因为动态生成类(如 CGLIB 代理、Groovy 脚本)过多导致直接内存溢出(OOM)而拖垮整个物理机。
2. 事后排查(发现问题 -> 定位瓶颈 -> 实施优化)
- 监控报警(发现问题):通过 Prometheus + Grafana 等监控大盘,发现 CPU 飙高、接口响应变慢(RT 增加)、或者收到了 OOM 的报警。
- 收集现场数据(定位瓶颈):
- GC 日志:通过分析 GC 日志(使用 GCViewer 或 GCEasy 等工具),看是 Minor GC 太频繁,还是触发了 Full GC,或者是 GC 停顿时间(Stop The World, STW)太长。
- 内存快照(Heap Dump):当发生 OOM 时,通过 -XX:+HeapDumpOnOutOfMemoryError 自动生成的 dump 文件。
- 线程快照(Thread Dump):使用 jstack 查看是否有死锁,或者大量线程处于 BLOCKED 或 WAITING 状态。
- 分析与解决(实施优化):使用 MAT (Memory Analyzer Tool) 或 JProfiler 分析 Dump 文件,找出占用内存最大的对象是谁产生的(GC Root 引用链),然后去修改业务代码,或者调整 JVM 参数。
二、 经典实战案例(准备 1-2 个讲给面试官听)
你需要根据你的实际情况,准备一个故事。以下提供两个最典型的场景供你参考和修改。
案例 1:频繁 Full GC 导致接口响应超时(CPU 飙高)
- 背景/现象:线上某个核心接口偶尔会大面积超时,监控显示该服务器的 CPU 使用率在某个时段会突然飙升到近 100%。
- 排查过程:
- 首先查看监控面板,发现 CPU 飙高的同时,Full GC 的次数非常频繁,且每次 Full GC 的停顿时间(STW)长达好几秒。
- 我立刻把这台机器隔离(摘掉流量),然后下载了当时的 GC 日志。
- 分析 GC 日志发现,老年代(Old Generation)的空间在每次 Full GC 后并没有明显下降。这说明有大量存活的对象进入了老年代,并且无法被回收。
- 接着,我使用 jmap -dump:format=b,file=heap.hprof
命令导出了当时的内存快照(Heap Dump)。 - 把 Dump 文件导入到 MAT (Memory Analyzer Tool) 中进行分析。使用 “Leak Suspects”(泄漏嫌疑人)功能,发现有一个 List 集合占用了将近 70% 的堆内存。
- 根本原因:顺着这个 List 的 GC Root 引用链找下去,发现是业务代码中有一个定时任务。这个任务每次执行都会从数据库捞取几万条数据进行处理,处理完后,本应该把这些对象释放掉,但因为代码逻辑错误,把这些对象塞进了一个全局的静态 List 中(或者 ThreadLocal 忘记 remove),导致对象一直强引用存活,最终塞满了老年代,引发疯狂的 Full GC。
- 解决方案:
- 代码层面:修复 Bug,将全局静态 List 改为局部变量,确保方法执行完后,对象能变成不可达状态,从而在 Minor GC 时就被回收掉。对于 ThreadLocal,确保在 finally 块中调用 remove()。
- JVM 层面(锦上添花):在修复代码后,我重新评估了对象的晋升年龄阈值(-XX:MaxTenuringThreshold),将其适当调大,让那些短命的对象在年轻代(Survivor 区)多待一会儿,尽可能在 Minor GC 时被干掉,避免过早进入老年代。
案例 2:大对象直接进入老年代导致的 Full GC(内存分代不合理)
- 背景/现象:系统并没有明显的内存泄漏,但监控发现每天都会发生几次规律的 Full GC,导致短暂卡顿。
- 排查过程:
- 观察 GC 日志,发现年轻代(Eden + Survivor)的 Minor GC 频率正常,但老年代的内存占用在持续、快速地增长,直到触发 Full GC。
- 使用 jstat -gcutil
1000 实时观察,发现每次发生 Minor GC 时,Survivor 区并没有怎么被使用,而老年代的占用量却大幅增加。
- 根本原因(分析):这通常是因为年轻代分配的空间太小,或者业务中存在较大的对象(如大数组、大报表文件、长字符串)。
- 当 Eden 区满了触发 Minor GC 时,存活的对象(哪怕是短命的大对象)由于 Survivor 区放不下,触发了空间分配担保机制,直接被送入了老年代。
- 或者对象的大小直接超过了 -XX:PretenureSizeThreshold 的设置,直接在老年代分配。
- 解决方案(调优过程):
- 调整年轻代比例:通过 -Xmn 参数适当增大年轻代(Young Gen)的总大小,同时调整 -XX:SurvivorRatio(Eden 与 Survivor 的比例,默认是 8:1:1)。目的是让 Survivor 区有足够的空间容纳 Minor GC 后存活的临时大对象。
- 业务优化:检查代码,发现某个导出 Excel 报表的接口,一次性把几十万条记录全部加载到了内存里的一个大 List 中。我将这个接口改成了分页查询 + 流式写入(如 EasyExcel),从根源上消除了这个“大对象”的产生。
- 结果:经过调整后,短命的大对象在年轻代就被成功回收,老年代的增长极其缓慢,规律性的 Full GC 彻底消失。
介绍一下Java的常量池(JAVA常量池,一篇文章就足够入门了。(含图解)_javaclass常量池-CSDN博客)
类常量池的组成:
- 常量池项:包括各种常量,例如字符串字面量、常量数值、类、方法、字段的符号引用。
- 符号引用:用于指向其他类、方法或字段的名称,可以通过解析这些符号引用来获得实际的内存地址。
java内存模型是咋样的?((一)玩命死磕Java内存模型(JMM)与Volatile关键字底层原理引言 本篇文章结合我个人对Java内存模型的理解 - 掘金)
一句话总结:
JMM 是一套抽象的规范,它屏蔽了底层不同 CPU 架构和操作系统的内存访问差异,为 Java 程序员提供了一个统一的、可预测的内存视图,确保在多线程环境下能正确地处理共享变量的读写问题。
它定义了一套规则来保证可见性 (Visibility)、原子性 (Atomicity) 和 有序性 (Ordering)。
2. JMM 的抽象结构
JMM 并没有规定物理内存怎么划分,而是定义了一个抽象模型:
- 主内存 (Main Memory):
- 所有实例字段、静态字段、数组元素都存在这里。
- 它是所有线程共享的。
- 工作内存 (Working Memory):
- 每个线程都有自己私有的工作内存。
- 它存储了该线程需要用到的变量的副本(从主内存拷贝来的)。
- 关键:线程对变量的所有操作(读、写)都必须在自己的工作内存中进行,不能直接读写主内存。
3. JMM 的三大特性
A. 原子性 (Atomicity)
- 定义:一个操作是不可分割、不可中断的。
- 例子:int i = 1; 是原子的。但 i++; 不是(它分三步:读-改-写)。
- 保障:synchronized, Lock, Atomic 原子类。
B. 可见性 (Visibility)
- 定义:当一个线程修改了共享变量的值,其他线程能够立即得知这个修改。
- 保障:
- volatile: 强制每次读都从主内存读,每次写都立刻刷回主内存。
- synchronized: 解锁前会把工作内存刷回主内存。
- final: 一旦初始化完成,对其他线程可见。
C. 有序性 (Ordering)
- 问题:为了性能,编译器和 CPU 可能会进行指令重排序 (Reordering)。在单线程下没问题,但在多线程下可能导致逻辑错误。
- 保障:
- volatile: 内部通过内存屏障 (Memory Barrier) 禁止指令重排。
- synchronized: 一个变量在同一个时刻只允许一个线程对其进行 lock 操作,保证了持有同一个锁的两个同步块只能串行执行。
- Happens-Before 原则: 这是 JMM 定义的“先行发生”规则,是判断是否存在数据竞争、代码是否线程安全的主要依据。
4. Happens-Before 原则 (面试重点)
如果操作 A happens-before 操作 B,那么 A 的执行结果对 B 是可见的。
核心规则有:
- 程序次序规则:一个线程内,代码写的顺序在前的操作 happens-before 后面的。
- volatile 规则:对一个 volatile 变量的写操作,happens-before 后面对这个变量的读。
- 锁规则:一个锁的解锁 (unlock) 操作,happens-before 后面对这个锁的加锁 (lock)。
- 传递性:A happens-before B, B happens-before C, 那么 A happens-before C。
new一个对象的过程中,分配内存有几种方式?分配内存在并发环境下如果存在锁的竞争,JVM如何解决这个问题?(深入理解Java虚拟机P81)
TLAB的全称是啥?你刚刚好几次提到了TLAB的伊甸区,伊甸区在哪里?TLAB是线程独享的吗?TLAB会给每个线程划分一块小小的区域,比如100KB,但是随着线程的运行比如调用栈特别深,new了很多对象,TLAB内存不够了,这时候需要怎么办?(TLAB(Thread Local Allocation Buffer)-CSDN博客)
大对象具体是如何进入老年代的
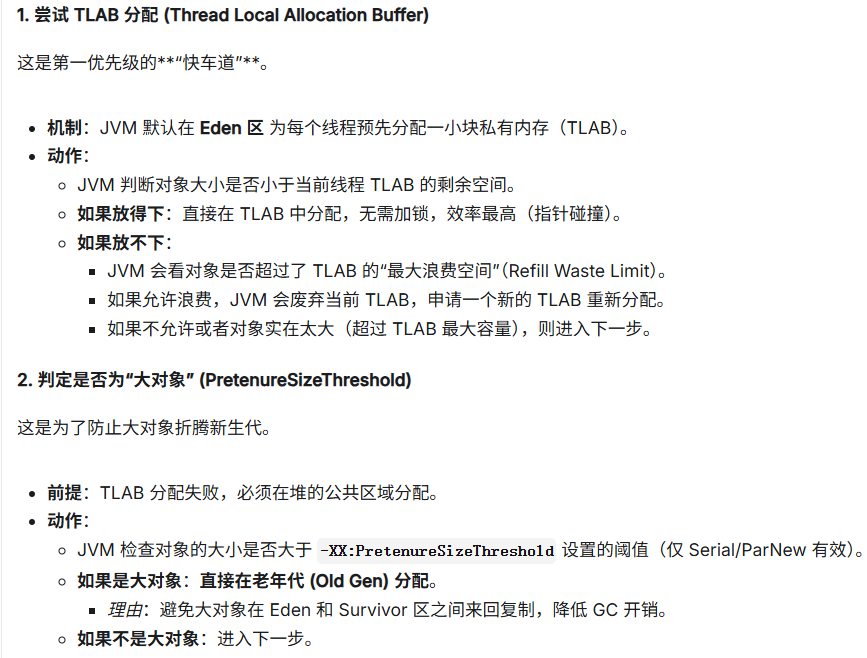
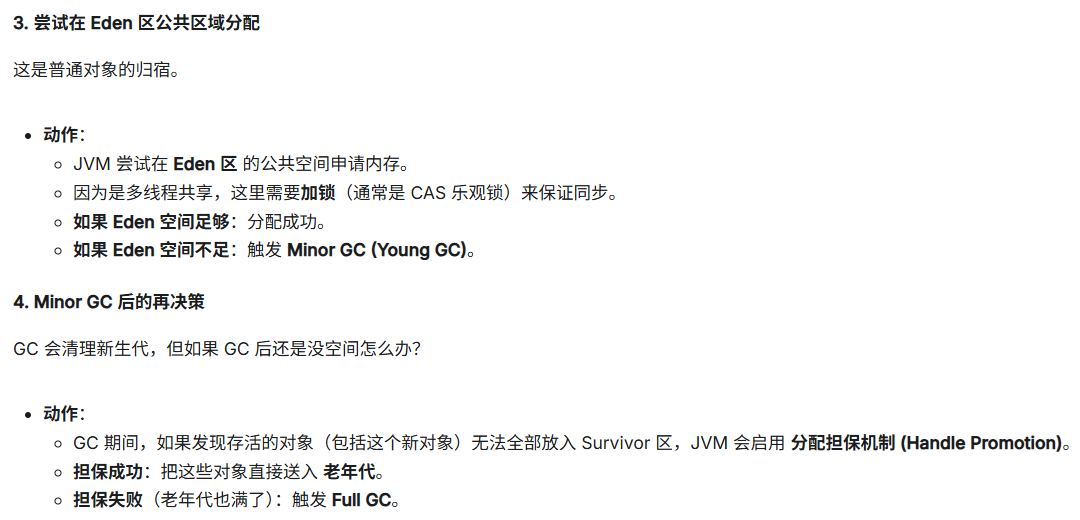
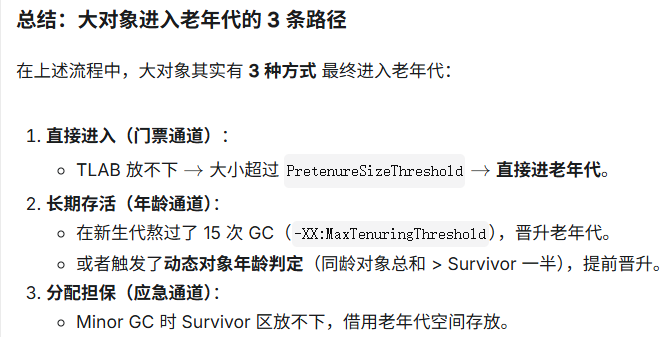
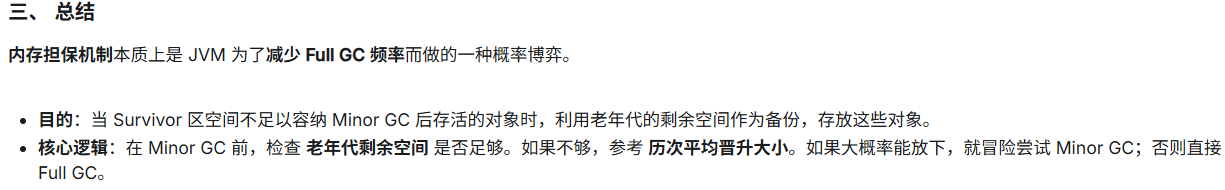
内存分配担保机制

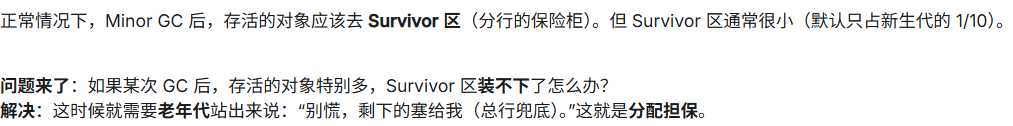
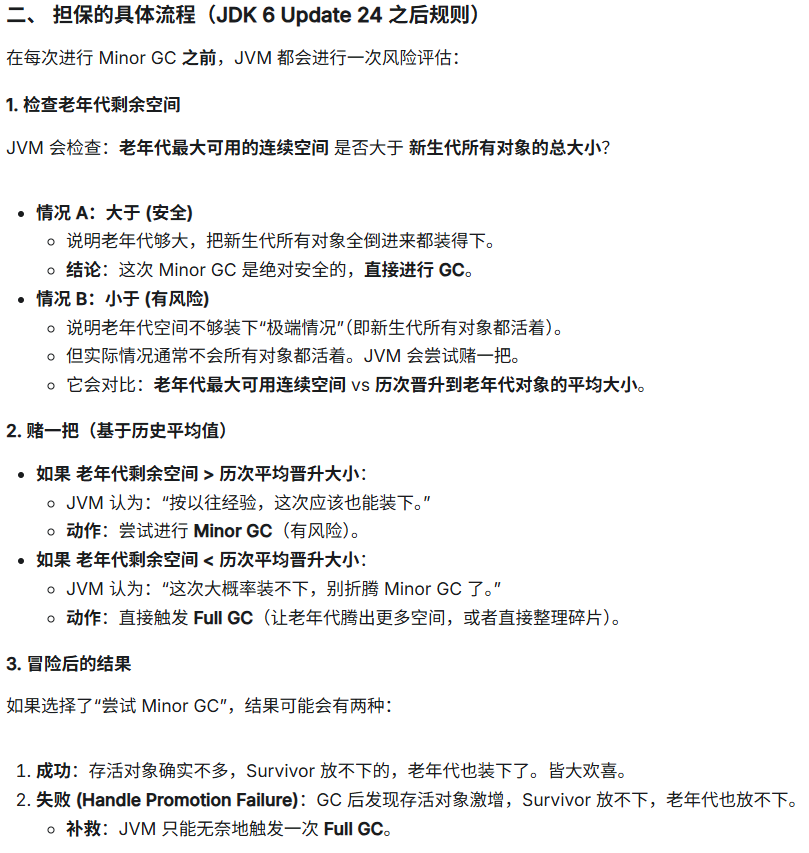
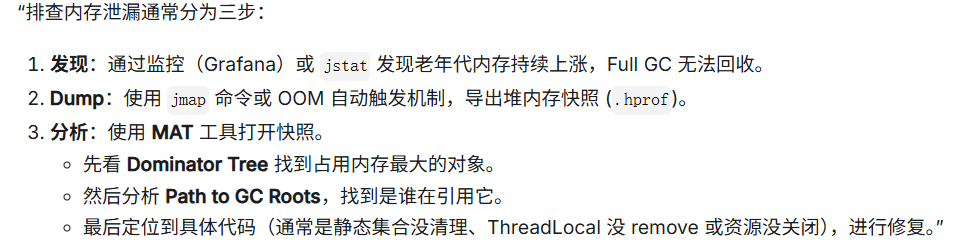
内存泄露排查的方法
jvm常用参数有哪些
一、 堆内存设置(最常用)
这部分决定了应用能吞吐多少数据,以及 GC 的频率。
- -Xms:初始堆内存大小。
- -Xmx:最大堆内存大小。
- 专业建议:通常将 -Xms 和 -Xmx 设为相等,以防止 JVM 在运行时因频繁调整堆大小(Resizing)带来的性能抖动。
- -Xmn:设置年轻代(Young Generation)的大小。通常设为堆总大小的 1/3 或 1/4。
- -XX:NewRatio:老年代与年轻代的比例。例如 -XX:NewRatio=2 表示 老年代:年轻代 = 2:1。
- -XX:SurvivorRatio:Eden 区与一个 Survivor 区的比例。默认是 8,即 Eden:S0:S1 = 8:1:1。
二、 非堆与栈设置
- -XX:MetaspaceSize / -XX:MaxMetaspaceSize(JDK 8+):
- 元空间(存储类信息、常量池)。建议设置最大值,防止类加载过多导致耗尽宿主机物理内存。
- -Xss:每个线程的栈大小。
- 默认通常是 1MB。如果方法调用深度很深(如递归),需调大;如果线程极多,可适当调小(如 256k)以节省内存。
三、 垃圾回收器(GC)相关
根据业务场景(低延迟 vs 高吞吐)选择合适的收集器。
- 指定收集器:
- -XX:+UseG1GC:开启 G1 收集器(目前主流,适合 4G-64G 堆内存)。
- -XX:+UseZGC:开启 ZGC 收集器(JDK 11+ 引入,低延迟神器,停顿 < 1ms)。
- -XX:+UseConcMarkSweepGC:开启 CMS 收集器(已过时,但在老系统中常见)。
- GC 调优参数:
- -XX:MaxGCPauseMillis:设置最大 GC 停顿时间目标(G1 核心参数)。
- -XX:ParallelGCThreads:并行 GC 时使用的 CPU 核心数。
四、 线上排障与诊断(生产环境必配)
这部分是体现经验的关键。
- -XX:+HeapDumpOnOutOfMemoryError:当发生 OOM 时,自动生成堆转储文件(Dump 文件)。
- -XX:HeapDumpPath=/path/to/dump:指定 Dump 文件的存放位置。
- -XX:+PrintGCDetails / -XX:+PrintGCDateStamps(JDK 8):打印详细 GC 日志。
- -Xlog:gc*(JDK 9+):新的统一日志管理命令。
- -XX:OnOutOfMemoryError:OOM 后执行的脚本(例如重启服务或发送告警通知)。
“我在生产环境中通常会遵循 ‘稳定优先’ 的原则:
- 首先,我会把 -Xms 和 -Xmx 设为一致(比如 4G),防止堆内存抖动。
- 针对 Web 应用,我会优先选择 G1 收集器 (-XX:+UseG1GC),并设置一个合理的停顿时间目标(比如 200ms)。
- 最重要的是诊断参数:我一定会配置 -XX:+HeapDumpOnOutOfMemoryError。这样一旦线上发生内存泄漏导致 OOM,我能第一时间拿到 Dump 文件,通过 MAT 或 VisualVM 进行离线分析,定位是哪个类占用了过多内存。”
面试真题
内存逃逸是什么,简单介绍一下。
1. 核心定义(是什么):
局部变量的生命周期超出了当前函数的作用域,导致原本应该分配在**栈(Stack,速度极快且自动销毁)上的对象,被迫分配到了堆(Heap,速度慢且依赖GC清理)**上。
2. 常见触发场景(怎么发生的):
- 将方法内部 new 出来的对象,作为返回值抛给了外部。
- 将局部对象赋值给了全局变量或外部类的属性。
3. 带来的影响(有什么坏处):
它不是内存泄漏(对象最终还是会被回收),但它是性能杀手。逃逸到堆上的对象越多,触发**垃圾回收(GC)**的频率就越高,容易导致程序卡顿(STW)和分配效率下降。
4. JVM 的反制手段(逃逸分析):
现代 Java 虚拟机(JDK 1.6+)默认开启了**“逃逸分析”技术。JVM 在编译时会偷偷检查:如果发现一个对象只在方法内部使用(*未发生逃逸*),JVM 就会把它优化在**栈上分配(或者打散成标量)。方法一结束直接灰飞烟灭,完全不需要 GC 参与,速度极快。
反射能修改类的前提是什么,结合着JVM底层模型原理说
反射生效的前提是类已经被 JVM 加载并生成 Class 对象,通过 Class 获取字段或方法元数据后,利用 Field/Method 内部保存的偏移量定位到堆中对象实例数据或静态区数据进行修改。对于 private 成员,需要通过 setAccessible(true) 关闭访问检查,但反射只能修改运行时数据,不能修改类结构,因为类元数据在加载后已经固定在元空间中。
结合 JVM 模型原理解析:
- 类的加载与存储(方法区/元空间):
当我们用 Java 写完代码编译成 .class 字节码文件后,JVM 启动运行。当你第一次使用某个类(或者通过 Class.forName() 主动加载)时,类加载器会将 .class 文件的二进制数据读入内存。
这些类结构元数据(包括常量池、字段描述、方法字节码、父类信息等)被存储在 JVM 的 方法区(Method Area,在 Java 8 之后称为元空间 Metaspace,位于本地内存中)。
原理说明:方法区就像是存放“汽车图纸”的档案馆。图纸一旦放进去,它的结构就定型了。 - 反射的入口(Java 堆中的 Class 对象):
在类被加载到方法区的同时,JVM 会在 Java 堆(Heap) 中自动创建一个对应的 java.lang.Class 类的实例对象。
这个 Class 对象就是反射的绝对核心前提。 它是一个“镜子”或者说是访问方法区元数据的“代理人”。反射 API(如 getDeclaredFields())本质上都是在向这个分配在堆中的 Class 对象发起查询。 - 如何越权修改 private 属性的底层逻辑:
假设你通过反射拿到一个 private 字段并调用 field.setAccessible(true),然后 field.set(obj, value)。- JVM 层面的阻拦:正常情况下,Java 语言层面的访问控制(public/private)是在编译期和 JVM 运行期的解析阶段进行检查的。
- 反射的绕过:setAccessible(true) 会将该 Field 对象内部的一个 override 标志位设为 true。当 JVM 执行反射赋值调用时(底层通常通过 Unsafe 类或 JNI 本地方法),会检查这个标志位。如果为 true,JVM 就会跳过 Java 语言级别的访问控制检查。
- 内存偏移量操作:JVM 会根据方法区中的元数据,计算出该字段在特定对象 obj 所在的堆内存区块中的具体内存偏移量(Offset)。然后,JVM 绕过正常的面向对象逻辑,直接往那个计算好的内存绝对地址中写入新的 value。
那元空间的内存泄漏了解吗
1. 什么是元空间?存的是什么?
在 JDK 8 之前,类的元数据存放在永久代(PermGen)中;JDK 8 之后,永久代被移除,取而代之的是元空间(Metaspace)。
- 位置: 元空间使用的是本地内存(Native Memory),不再受限于 JVM 堆的大小,它的上限受限于操作系统的可用物理内存(虽然通常我们会通过 -XX:MaxMetaspaceSize 加以限制)。
- 存储内容: 它主要存储了由类加载器(ClassLoader)加载的类的元数据信息(Klass 模型),包括:类的结构、方法、字段、常量池(运行时常量池)、以及编译后的代码等。
2. 为什么会发生元空间泄漏?(核心原因)
元空间的内存回收机制与堆内存不同。一个类被卸载(卸载类才能回收其在元空间的内存)的条件极其苛刻,必须同时满足三个条件:
- 该类的所有实例对象都已经被 GC 回收了。
- 加载该类的 ClassLoader 实例已经被 GC 回收了。
- 该类没有在任何地方被引用(包括反射)。
导致泄漏的根本原因在于:大量的类被动态生成,但加载它们的 ClassLoader 却因为某种原因被“强引用”住了,导致这些动态生成的类及其元数据永远无法被卸载,最终撑爆元空间,抛出 java.lang.OutOfMemoryError: Metaspace。
3. 典型的罪魁祸首(生产环境真实案例)
- 过度使用动态代理框架(如 CGLib, ASM):
- Spring AOP、MyBatis 拦截器等底层都大量使用 CGLib 动态生成子类。如果在使用这些框架时配置不当,或者在业务代码中频繁且不复用地动态生成大量的代理类,就会导致元空间迅速膨胀。
- 反射的滥用(Inflation 机制):
- 正如前面所说,当 Method.invoke() 调用次数超过 15 次时,JVM 为了提升性能,会动态生成一个名为 GeneratedMethodAccessorXXX 的全新 Java 类。如果系统中有海量的反射调用(特别是调用不同的方法),会生成海量的这种小碎片类填满元空间。
full gc 太频繁了,怎么解决
频繁 Full GC 是非常严重的问题,因为它是以 Stop-The-World(系统卡顿)为代价的。
要解决这个问题,必须遵循 “发现现象 -> 抓取证据 -> 定位原因 -> 对症下药” 的流程。
第一步:现象确认与监控(发现问题)
- 现象:系统响应突然变慢,CPU 偶尔飙高,通过 jstat -gcutil 看到 FGC 次数飞速增加。
- 目标:确认到底是 老年代 (Old) 满了,还是 元空间 (Metaspace) 满了导致的 Full GC。
第二步:抓取证据(保留现场)
必须拿到现场的内存快照,否则就是瞎猜。
- 线上直接生成 (可能卡顿,慎用):jmap -dump:format=b,file=heap.hprof
- 设置 OOM 自动抓取 (防患于未然):确保启动参数配了 -XX:+HeapDumpOnOutOfMemoryError。
第三步:使用 MAT 离线分析(定位元凶)
把 heap.hprof 下载到本地,用 Eclipse MAT 打开。
- 看 Leak Suspects(内存泄漏嫌疑人)。
- 点开 Dominator Tree(支配树),按占用大小排序。
- 找到占用最大的几个对象,右键 Path to GC Roots。
- 顺藤摸瓜,找出是哪一行代码、哪个集合抓着这些对象不放。
第四步:常见原因及对症下药(面试重点)
根据 MAT 的分析结果,问题通常跑不出以下四种:
1. 内存泄漏 (Memory Leak) —— 治本
- 表现:每次 Full GC 后,老年代内存不但没降下来,反而呈阶梯状上升。
- 常见元凶:
- 静态集合类:static List 只 add 从不 remove。
- ThreadLocal:线程池中的线程用完没调用 remove()。
- 解决:修 Bug。
2. 大对象直接进老年代 (Large Objects) —— 优化代码
- 表现:没有内存泄漏,但经常有几十 MB 的大对象产生。
- 常见元凶:SQL 查库没加 limit(比如一次查出 10 万条用户数据),或者 Excel 导出时全量加载到内存。
- 解决:
- 代码层面:分批查询、流式读取。
- 参数层面:如果确实需要大对象,适当调大 -XX:PretenureSizeThreshold 的值(仅对 Serial/ParNew 有效)。
3. 新生代太小导致对象过早晋升 (Premature Promotion) —— 调参
- 表现:很多短命的朝生夕死对象,因为 Survivor 区不够大,被动态年龄判断机制直接“挤”到了老年代。
- 解决:
- 调大年轻代比例:增大 -Xmn,或者调整 -XX:NewRatio。
- 调大 Survivor 区比例:调整 -XX:SurvivorRatio。
- 调大晋升年龄:-XX:MaxTenuringThreshold=15。
4. 元空间被打满 (Metaspace Full)
- 表现:老年代没满,但 Metaspace 满了。
- 常见元凶:应用中大量使用了 CGLib 等动态代理技术,疯狂生成新类而不卸载。
- 解决:调大 -XX:MaxMetaspaceSize。
总结话术:
“排查频繁 Full GC,我会先看监控,确认是老年代还是元空间满。如果是老年代问题,我一定会通过 jmap 导出一个 Heap Dump 文件。
然后用 MAT 分析这个文件,看是出现了内存泄漏(如 ThreadLocal 未清理),还是因为一次性加载了超大对象(如全表查询)。
如果代码没问题,只是流量太大,我会检查 JVM 参数,通常是因为年轻代太小,导致本该在 Young GC 中死掉的对象提前晋升到了老年代。我会尝试调大 -Xmn,或者直接切换到对大内存更友好的 G1 垃圾回收器。”
为什么要打破双亲委派机制
场景一:解决包的“版本隔离”问题(以 Tomcat 为例)
这是最常见的必须打破双亲委派的场景。
痛点:
假设你在一台服务器上部署了一个 Tomcat,这个 Tomcat 里面运行了两个 Web 网站(App1 和 App2)。
- App1 使用了 Spring 4.0 版本。
- App2 使用了老旧的 Spring 3.0 版本。
如果遵守双亲委派机制会发生什么?
Tomcat 的公共类加载器(父加载器)会先去加载 Spring。如果它先加载了 App1 的 Spring 4.0,当 App2 启动时,也会往上找,父类说:“我已经加载过 Spring 了,直接给你用。” 结果 App2 被强行塞入了 4.0 版本,导致大量 API 找不到,程序直接崩溃。
如何打破(Tomcat 的做法):
Tomcat 重写了 ClassLoader,为每一个部署的 Web 应用创建了一个专属的 WebAppClassLoader。
它逆转了规则:对于 Web 应用自己 WEB-INF/classes 和 WEB-INF/lib 目录下的类,自己优先加载,找不到才去问父类。
这样,App1 和 App2 各自拥有独立的沙箱,各自加载各自版本的 Spring,完美实现了类隔离。
(注:当然,Tomcat 对 java.lang.* 等核心基础类依然保持向上委派,防止基础安全问题。)
场景二:解决基础类“无法向下调用”的问题(SPI 与 JDBC 开发)
双亲委派机制有一个致命的逻辑漏洞:上级类加载器,看不见下级类加载器加载的类。
痛点:
Java 在核心库(rt.jar)中定义了数据库的标准接口 java.sql.Driver,这个接口是由最顶层的 Bootstrap ClassLoader 加载的。
但是,具体的实现类(比如 MySQL 的 mysql-connector-java.jar、Oracle的驱动)是由第三方厂商提供的,放在项目的 classpath 下,只能由底层的 Application ClassLoader 加载。
这就产生了一个悖论:
核心库的 DriverManager(Bootstrap加载)在初始化时,需要去实例化具体的 MySQL 驱动类。但是最顶层的大佬(Bootstrap)根本看不见底下小弟(Application)加载的类!
如何打破(JDK 的官方“作弊”):
为了解决这个 SPI(Service Provider Interface)问题,Java 引入了 线程上下文类加载器(Thread Context ClassLoader, TCCL)。
简单来说,它开了一个后门:父类加载器可以通过请求当前线程拿到底层的 Application ClassLoader,然后反向指使底层加载器去把具体的实现类(MySQL驱动)加载上来。
这就完全破坏了“严格向上委派”的原则,变成了“向下索取”。
场景三:实现代码的“热部署 / 热更新”(OSGi / 增量编译)
痛点:
在默认的双亲委派模型下,一个类(全限定名相同)被一个 ClassLoader 加载后,就永远驻留在内存中了。如果你修改了 .java 文件并重新编译成 .class,JVM 是不会重新加载它的(必须重启服务器)。
但在现代开发中(比如 IDEA 的热部署 JRebel、各种游戏服务器的热更新),我们希望不重启服务器就能让修改的代码生效。
如何打破:
做法非常暴力:既然一个 ClassLoader 只能加载一次,那我就把原来的 ClassLoader 连同它加载的类一起扔掉(垃圾回收)!
当类被修改时,系统会动态创建一个全新的自定义 ClassLoader,由这个新的加载器去读取新的 .class 文件。
著名的 Java 模块化标准 OSGi 就是打破双亲委派的集大成者。它的类加载器层级不是树状的,而是网状的。各个 Bundle(模块)之间可以互相委派加载,规则极其复杂,完全抛弃了传统的自底向上的双亲委派机制,从而实现了极致的动态模块化和热拔插。