Java基础语法
单例模式有几种?懒汉式单例存在什么问题?单例模式的使用场景?
1.懒汉式单例(Lazy Initialization)
1.1 线程不安全的懒汉式单例
1 | |
问题:这种实现方式在多线程环境下是不安全的。如果多个线程同时执行 instance == null 时,会创建多个实例。
1.2 双重检查锁定(Double-Checked Locking)
1 | |
优点:只有在 instance 为 null 时才加锁,避免了每次访问时都加锁的性能问题。使用 volatile 确保线程可见性。
注意:instance用了volatile关键字修饰,可以保证变量在多线程的可见性以及指令重排序问题。instance = new Singleton()代码其实是分为三步执行:
1.为 Instance 分配内存空间
2.初始化 uniqueInstance
3.将 Instance 指向分配的内存地址
但是由于 JVM 具有指令重排的特性,执行顺序有可能变成 1->3->2。指令重排在单线程环境下不会出现问题,但是在多线程环境下会导致一个线程获得还没有初始化的实例。例如,线程 T1 执行了 1 和 3,此时 T2 调用 getUniqueInstance() 后发现 uniqueInstance 不为空,因此返回 uniqueInstance,但此时 uniqueInstance 还未被初始化,所以需要volatile禁止指令重排序
2.饿汉式单例(Eager Initialization)
饿汉式单例在类加载时就创建实例,线程安全,且不需要进行懒加载的同步。
2.1 饿汉式单例
1 | |
3 静态内部类实现(Bill Pugh Singleton)
这种方式是通过静态内部类的方式来实现懒加载,并且保证线程安全。静态内部类只有在 getInstance() 被调用时才会加载,并且由于类加载时是线程安全的,所以无需加锁。
1 | |
优点:既保证了懒加载,又保证了线程安全,并且性能更高。类加载时,SingletonHelper 类不会立即加载,只有在调用 getInstance() 时才会加载。
使用场景
1. 节省资源 (Resource Saving)
当对象的创建成本很高时,使用单例可以确保它只被创建一次,然后被反复使用,避免性能浪费。
- 场景举例:
- 数据库连接池
- 线程池
- 重量级的配置对象或缓存
2. 保证唯一性与协同 (Ensuring Uniqueness & Coordination)
当一个类必须作为全局唯一的“总管”或“协调者”,以确保所有操作都通过它来同步和管理时,必须使用单例。
- 场景举例:
- 应用程序的配置管理器
- 日志管理器
- Spring 的 ApplicationContext 容器
- 操作系统的窗口管理器
3. 无状态工具 (Stateless Utilities)
当一个类是无状态的(即不包含可变的成员变量),它的功能完全由输入参数决定时,创建一个共享的单例实例就足够了,可以节省内存。
- 场景举例:
- Spring 中的 @Service, @Repository, @Controller
- 只提供计算或操作方法的工具类
Java的三大特性?多态是怎么体现的?
封装,继承,多态
多态:同一个方法调用,在不同对象上表现出不同的行为。
即:父类引用指向子类对象,调用的是子类的重写方法。
父类引用调用子类方法,实现“接口统一,行为多样”,是高可扩展性的重要基础。
二、多态的三个前提(Java)
- 有继承关系
- 子类重写父类方法
- 父类引用指向子类对象
“多态主要分为静态多态和动态多态。
- 静态多态指的是方法重载,在编译期通过参数列表决定调用。
- 动态多态指的是方法重写,它是 OOP 的灵魂。通过‘父类引用指向子类对象’,程序在运行时根据对象的实际类型动态查找虚方法表。
基本类型和包装类的区别(【Java基础】基本类型和包装类的区别_java包装类和基本数据类型的区别-CSDN博客)
String,StringBuilder,StringBuffer的区别,String类不可变性 以及设置为不可变的优点有哪些
| String | StringBuffer | StringBuilder | |
|---|---|---|---|
| 执行速度 | 最差 | 其次 | 最高 |
| 线程安全 | 线程安全 | 线程安全(方法用synchronized修饰) | 线程不安全 |
| 使用场景 | 少量字符串操作 | 多线程环境下的大量操作 | 单线程环境下的大量操作 |
不可变性:
String 内部使用的是一个 final char[] value 数组(JDK 8 及以前),该数组一旦被赋值,引用就不能更改;
优点:
- 线程安全 2. 可以被缓存(字符串常量池)
equals 和==的区别
==”比较基本数据类型时比较的是表面值内容,而比较两个对象时比较的是两个对象的内存地址值
如果没有对equals方法进行重写,则比较的是引用类型的变量所指向的对象的地址;
诸如String、Date等类对equals方法进行了重写的话,比较的是所指向的对象的内容
wait 和 sleep 区别(一文彻底搞懂Java中wait和sleep方法的区别_java中的sleep和wait方法的区别-CSDN博客)
runable、callable有什么区别?
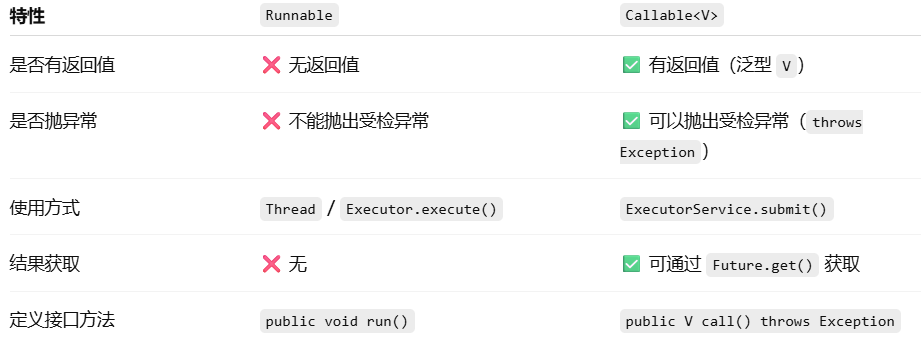
总结:Runnable 适合“跑一下就行”的任务,Callable 更适合“跑完给我个结果”并处理异常的任务。
新建线程的几种方式
1.继承Thread类
1 | |
2.实现Runnable接口
1 | |
3.实现Callable接口
1 | |
4.使用[线程池]
1 | |
线程有哪些状态,不同状态之间怎么进行切换
Java 线程在运行的生命周期中的指定时刻只可能处于下面 6 种不同状态的其中一个状态:
NEW: 初始状态,线程被创建出来但没有被调用
start()。RUNNABLE: 运行状态,线程被调用了
start()等待运行的状态。BLOCKED:阻塞状态,需要等待锁释放。
WAITING:等待状态,表示该线程需要等待其他线程做出一些特定动作(通知或中断)。
TIME_WAITING:超时等待状态,可以在指定的时间后自行返回而不是像 WAITING 那样一直等待。
TERMINATED:终止状态,表示该线程已经运行完毕。
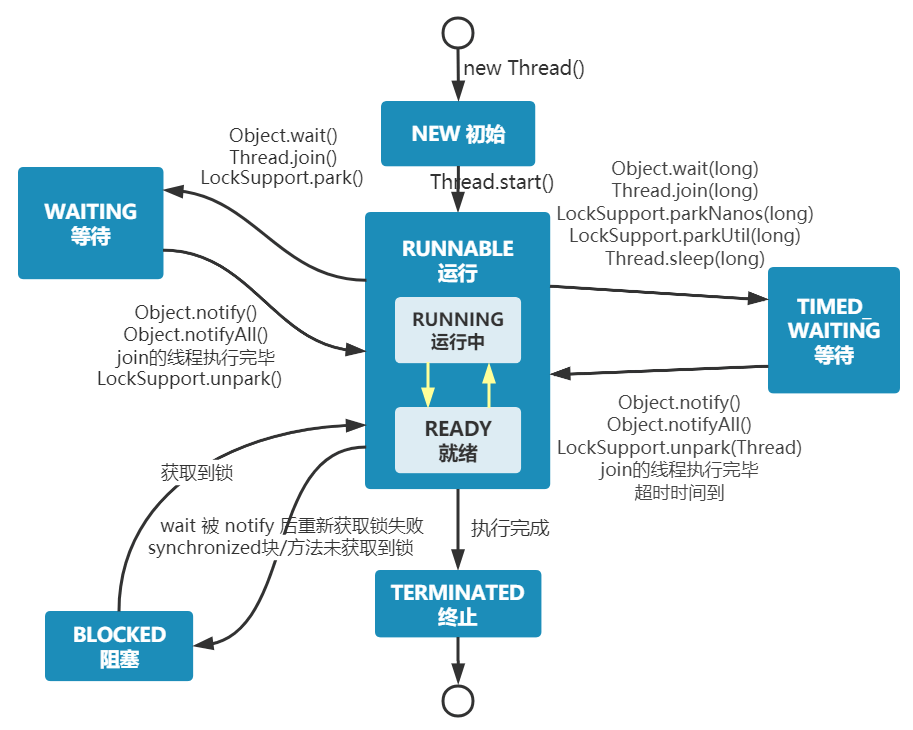
当线程执行 wait()方法之后,线程进入 WAITING(等待) 状态。进入等待状态的线程需要依靠其他线程的通知才能够返回到运行状态。
TIMED_WAITING(超时等待) 状态相当于在等待状态的基础上增加了超时限制,比如通过 sleep(long millis)方法或 wait(long millis)方法可以将线程置于 TIMED_WAITING 状态。当超时时间结束后,线程将会返回到 RUNNABLE 状态。
当线程进入 synchronized 方法/块或者调用 wait 后(被 notify)重新进入 synchronized 方法/块,但是锁被其它线程占有,这个时候线程就会进入 BLOCKED(阻塞) 状态。
线程在执行完了 run()方法之后将会进入到 TERMINATED(终止) 状态。
在 Linux 内核的状态机中,它们都属于“睡眠(Sleep)”状态,但触发机制和唤醒方式不同。
1. 阻塞态 (Blocked) —— 被迫停下(等资源)
- 核心特征:被动性。进程/线程想继续往下跑,但是它需要的一个外部资源现在拿不到,操作系统强行把它踢出了 CPU,让它去旁边排队。
- 常见场景:
- 等待 I/O 完成:你想读硬盘上的文件,但硬盘转得很慢,数据还没取出来。在这个过程中,你只能干等(这是最典型的阻塞)。
- 等待获取锁(Lock/Mutex):你想进入临界区修改一个变量,但是发现这个变量正在被另一个线程修改(锁被别人占了)。你拿不到锁,只能在锁的等待队列里被迫阻塞。
- 如何唤醒:由外部事件被动唤醒。比如硬盘把数据读完了,给 CPU 发了个中断;或者占用锁的那个线程把锁释放了,OS 会通知你:“资源有了,你可以回就绪队列了。”
2. 等待态 (Waiting) —— 主动停下(等条件/时间)
- 核心特征:主动性。进程/线程当前没有被任何具体的硬件 I/O 或锁卡住,而是它自己主动决定休息一会儿,或者它在等一个**逻辑上的“条件”或“信号”**发生。
- 常见场景:
- 定时等待(Timed Waiting):程序里写了 sleep(5)(睡 5 秒)。这时候没有任何资源竞争,纯粹是程序自己要求暂停 5 秒。
- 条件等待(Condition Wait):线程调用了 wait() 或 await()。比如一个生产者-消费者模型,消费者发现队列空了,它主动调用 wait() 进入等待态。它不是在等一把锁(它可能已经拿到锁了),而是在等“队列里有数据”这个业务条件成立。
- 如何唤醒:
- 时间到了:sleep(5) 的 5 秒钟走完了,操作系统的定时器把你叫醒。
- 收到信号:别的线程(比如生产者放了数据后)主动调用 notify() 或 signal() 发个信号给你:“别睡了,条件满足了。”
JDK代理和CGLIB的代理有什么区别
JDK 动态代理只能代理实现了接口的类或者直接代理接口,而 CGLIB 可以代理未实现任何接口的类。 另外, CGLIB 动态代理是通过生成一个被代理类的子类来拦截被代理类的方法调用,因此不能代理声明为 final 类型的类和方法。
就二者的效率来说,大部分情况都是 JDK 动态代理更优秀,随着 JDK 版本的升级,这个优势更加明显。
CGLIB 动态代理类使用步骤
定义一个类;
自定义 MethodInterceptor 并重写 intercept 方法,intercept 用于拦截增强被代理类的方法,和 JDK 动态代理中的 invoke 方法类似;
通过 Enhancer 类的 create()创建代理类
了解双亲委派机制吗,tomcat打破了双亲委派模型,为什么要打破他?
在介绍双亲委派机制的时候,不得不提ClassLoader(类加载器)。说ClassLoader之前,我们得先了解下Java的基本知识。
Java是运行在Java的虚拟机(JVM)中的,但是它是如何运行在JVM中了呢?我们在IDE中编写的Java源代码被编译器编译成.class的字节码文件。然后由我们得ClassLoader负责将这些class文件给加载到JVM中去执行。
JVM中提供了三层的ClassLoader:
1.Bootstrap classLoader:主要负责加载核心的类库(java.lang.*等),构造ExtClassLoader和APPClassLoader。
2.ExtClassLoader:主要负责加载jre/lib/ext目录下的一些扩展的jar。
3.AppClassLoader:主要负责加载应用程序的主函数类
另外,类加载器之间的父子关系一般不是以继承的关系来实现的,而是通常使用组合关系来复用父加载器的代码。
1 | |
在面向对象编程中,有一条非常经典的设计原则:**组合优于继承,多用组合少用继承
那如果有一个我们写的Hello.java编译成的Hello.class文件,它是如何被加载到JVM中的呢?别着急,请继续往下看。
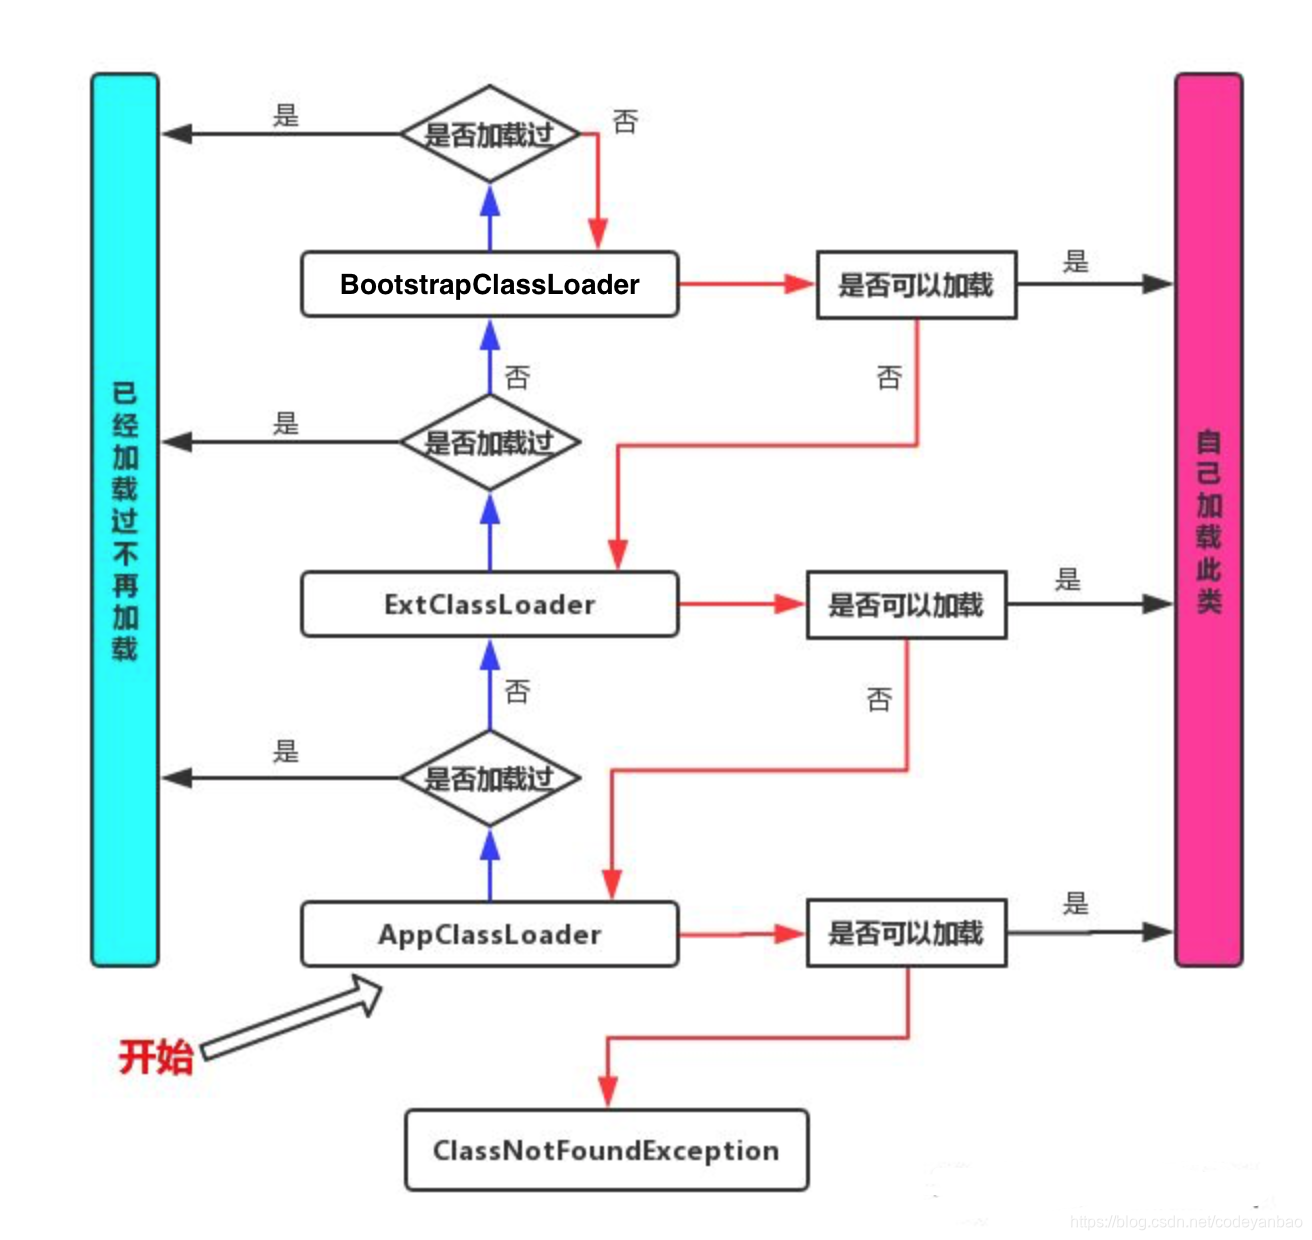
从上图中我们就更容易理解了,当一个Hello.class这样的文件要被加载时。不考虑我们自定义类加载器,首先会在AppClassLoader中检查是否加载过,如果有那就无需再加载了。如果没有,那么会拿到父加载器,然后调用父加载器的loadClass方法。父类中同理也会先检查自己是否已经加载过,如果没有再往上。注意这个类似递归的过程,直到到达Bootstrap classLoader之前,都是在检查是否加载过,并不会选择自己去加载。直到BootstrapClassLoader,已经没有父加载器了,这时候开始考虑自己是否能加载了,如果自己无法加载,会下沉到子加载器去加载,一直到最底层,如果没有任何加载器能加载,就会抛出ClassNotFoundException。那么有人就有下面这种疑问了?
为什么要设计这种机制
这种设计有个好处是,如果有人想替换系统级别的类:String.java。篡改它的实现,在这种机制下这些系统的类已经被Bootstrap classLoader加载过了(为什么?因为当一个类需要加载的时候,最先去尝试加载的就是BootstrapClassLoader),所以其他类加载器并没有机会再去加载,从一定程度上防止了危险代码的植入。
保障类加载的安全性
双亲委派机制的核心目的是为了保证Java程序的安全。通过双亲委派,JVM确保了核心类库(如java.lang包下的类)只能由启动类加载器加载,防止恶意代码通过自定义类加载器来篡改这些核心类库。
避免重复加载
双亲委派机制可以避免同一个类被多次加载。当一个类被请求加载时,JVM会从最顶层的启动类加载器开始,向下逐层查找,如果已经加载则直接返回,否则委派给父类加载器。
双亲委派的执行流程
1 | |
每当一个类加载器接收到加载请求时,它会先将请求转发给父类加载器。在父类加载器没有找到所请求的类的情况下,该类加载器才会尝试去加载。
结合上面的源码,简单总结一下双亲委派模型的执行流程:
- 在类加载的时候,系统会首先判断当前类是否被加载过。已经被加载的类会直接返回,否则才会尝试加载(每个父类加载器都会走一遍这个流程)。
- 类加载器在进行类加载的时候,它首先不会自己去尝试加载这个类,而是把这个请求委派给父类加载器去完成(调用父加载器
loadClass()方法来加载类)。这样的话,所有的请求最终都会传送到顶层的启动类加载器BootstrapClassLoader中。 - 只有当父加载器反馈自己无法完成这个加载请求(它的搜索范围中没有找到所需的类)时,子加载器才会尝试自己去加载(调用自己的
findClass()方法来加载类)。 - 如果子类加载器也无法加载这个类,那么它会抛出一个
ClassNotFoundException异常。
拓展一下:
JVM 判定两个 Java 类是否相同的具体规则:JVM 不仅要看类的全名是否相同,还要看加载此类的类加载器是否一样。只有两者都相同的情况,才认为两个类是相同的。即使两个类来源于同一个 Class 文件,被同一个虚拟机加载,只要加载它们的类加载器不同,那这两个类就必定不相同。
打破双亲委派模型的方法
自定义加载器的话,需要继承 ClassLoader 。如果我们不想打破双亲委派模型,就重写 ClassLoader 类中的 findClass() 方法即可,无法被父类加载器加载的类最终会通过这个方法被加载。但是,如果想打破双亲委派模型则需要重写 loadClass() 方法。
为什么是重写 loadClass() 方法打破双亲委派模型呢?双亲委派模型的执行流程已经解释了:
类加载器在进行类加载的时候,它首先不会自己去尝试加载这个类,而是把这个请求委派给父类加载器去完成(调用父加载器
loadClass()方法来加载类)。
重写 loadClass()方法之后,我们就可以改变传统双亲委派模型的执行流程。例如,子类加载器可以在委派给父类加载器之前,先自己尝试加载这个类,或者在父类加载器返回之后,再尝试从其他地方加载这个类。具体的规则由我们自己实现,根据项目需求定制化。
我们比较熟悉的 Tomcat 服务器为了能够优先加载 Web 应用目录下的类,然后再加载其他目录下的类,就自定义了类加载器 WebAppClassLoader 来打破双亲委托机制。这也是 Tomcat 下 Web 应用之间的类实现隔离的具体原理。
Tomcat 的类加载器的层次结构如下:
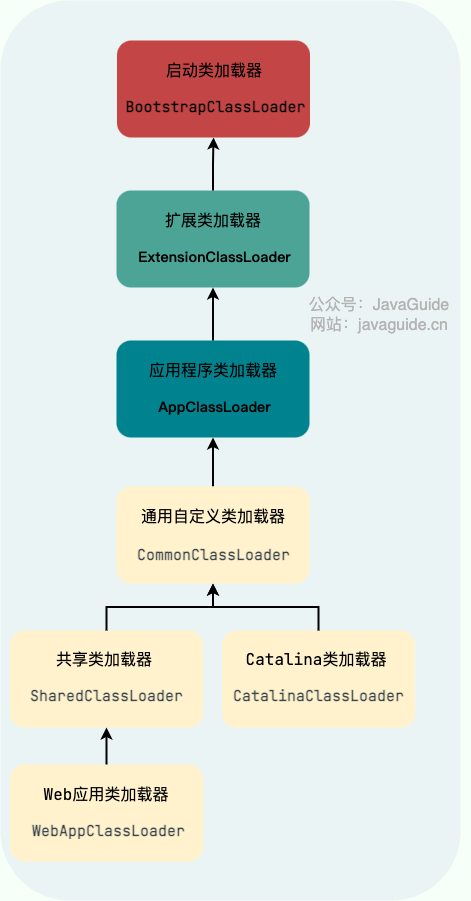
为什么要打破双亲委派机制:((2 封私信 / 2 条消息) Tomcat为什么要JAVA破坏双亲委派机制? - 知乎)
因为有时候我们需要加载自己定义的类或框架类,而不想被系统类覆盖或者影响。
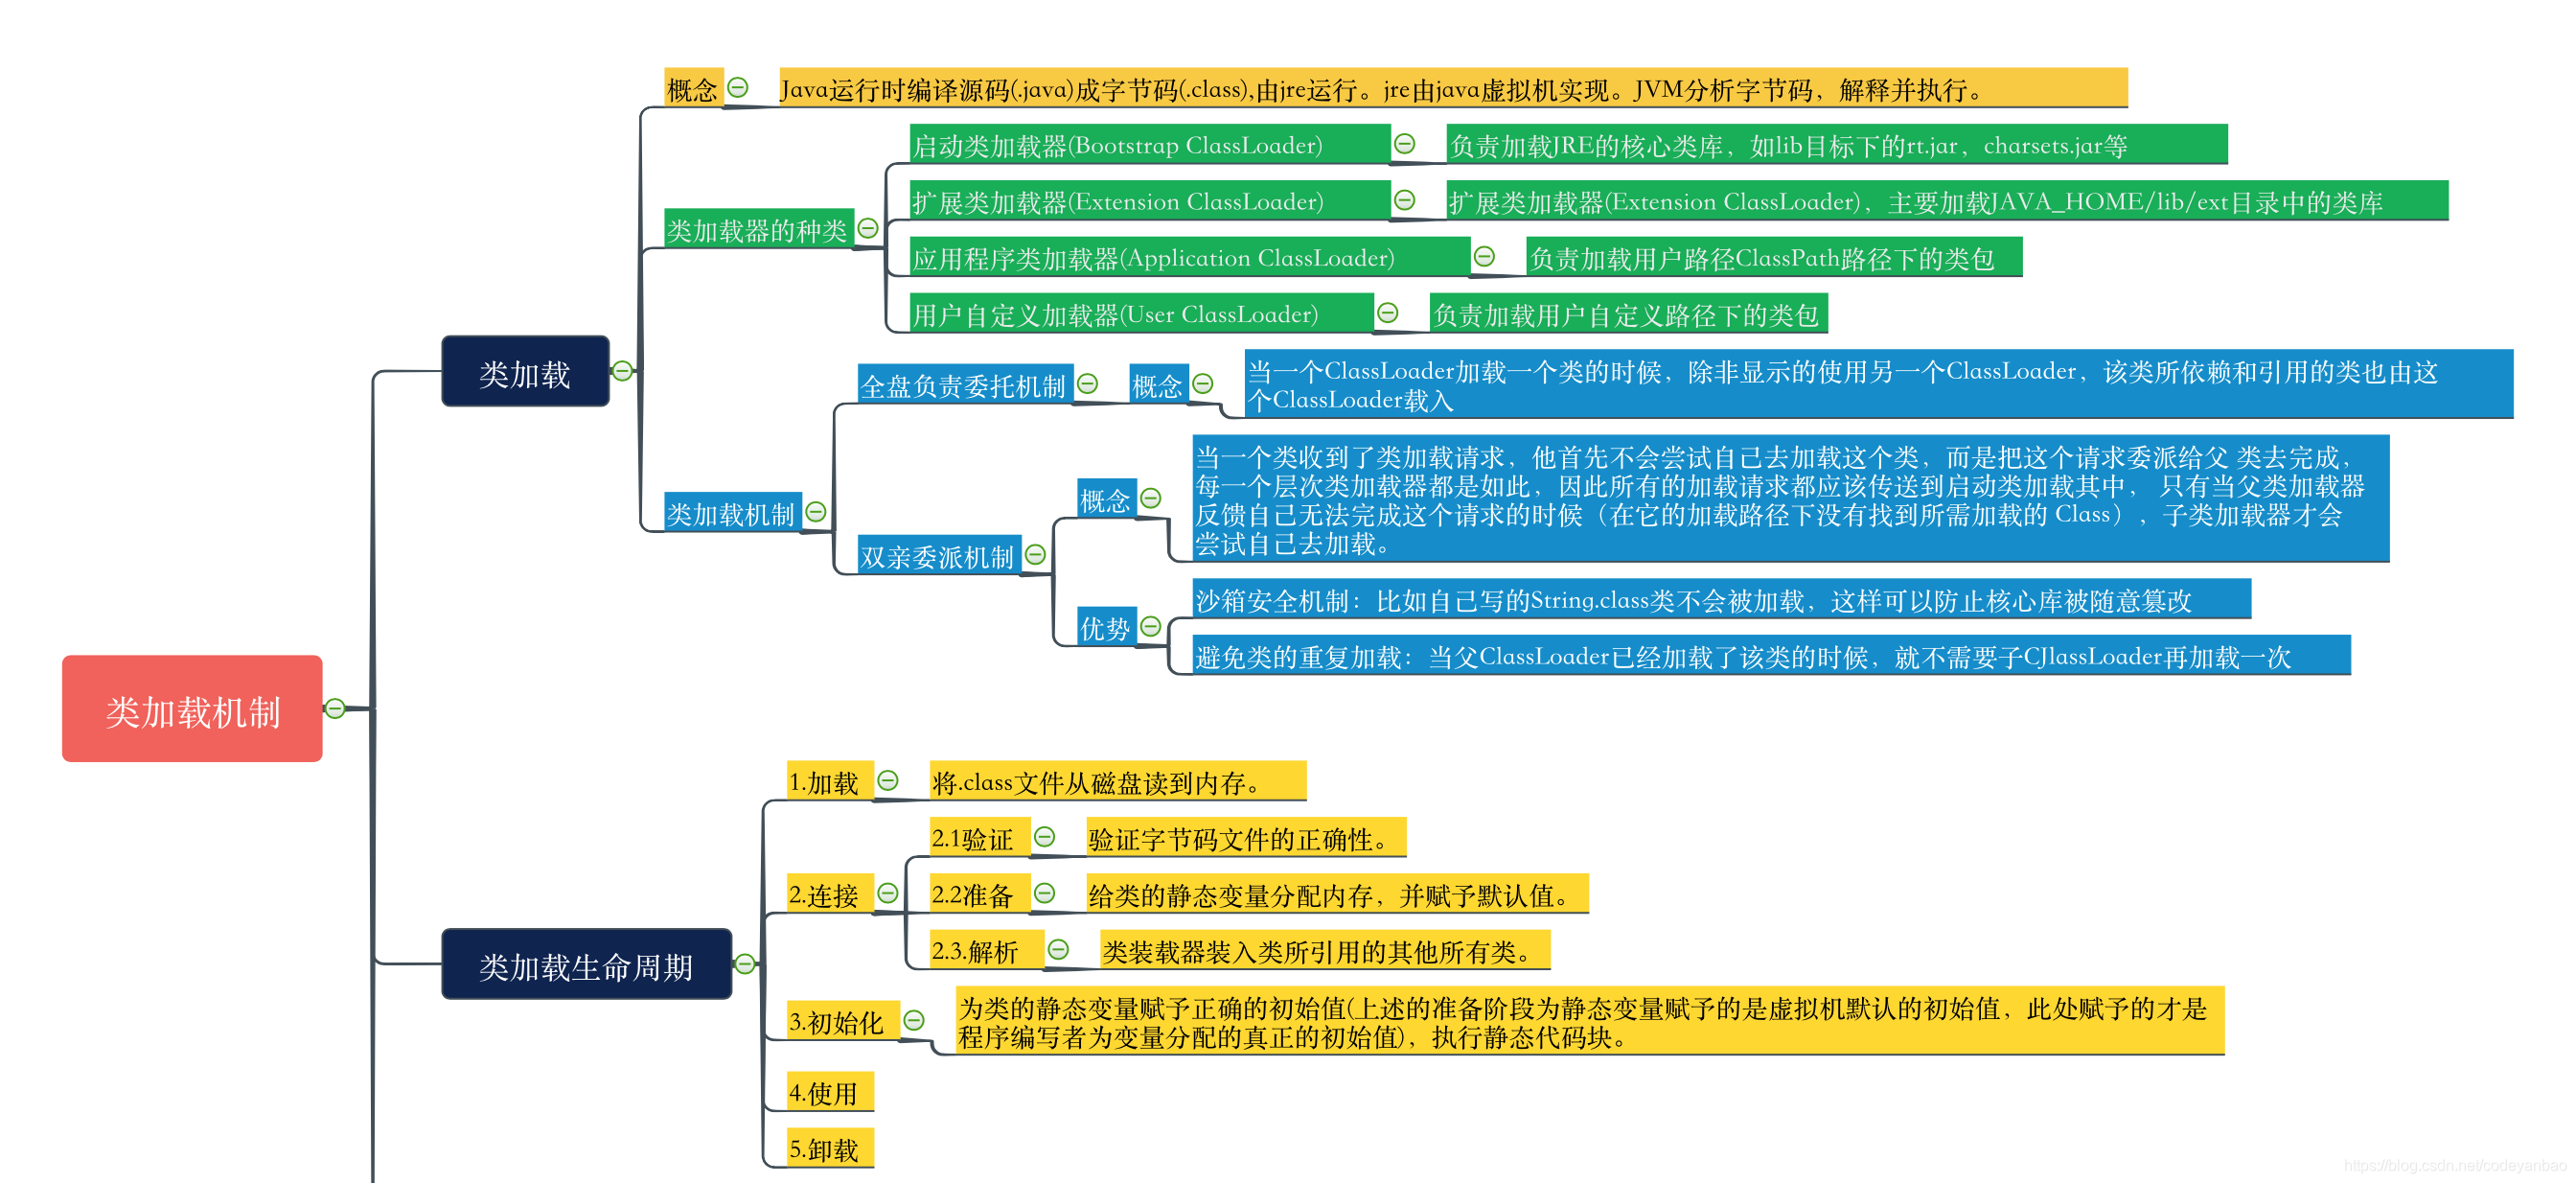
类加载器有哪些?加载过程是怎样的?
1.类的生命周期
类从被加载到虚拟机内存中开始到卸载出内存为止,它的整个生命周期可以简单概括为 7 个阶段:加载(Loading)、验证(Verification)、准备(Preparation)、解析(Resolution)、初始化(Initialization)、使用(Using)和卸载(Unloading)。其中,验证、准备和解析这三个阶段可以统称为连接(Linking)。
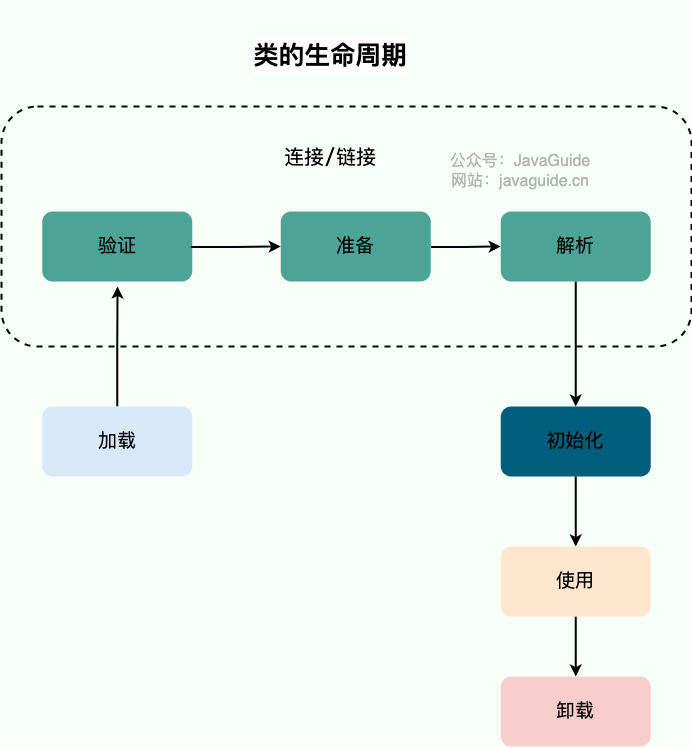
2.类的加载过程
Class 文件需要加载到虚拟机中之后才能运行和使用,那么虚拟机是如何加载这些 Class 文件呢?
系统加载 Class 类型的文件主要三步:加载->连接->初始化。连接过程又可分为三步:验证->准备->解析。
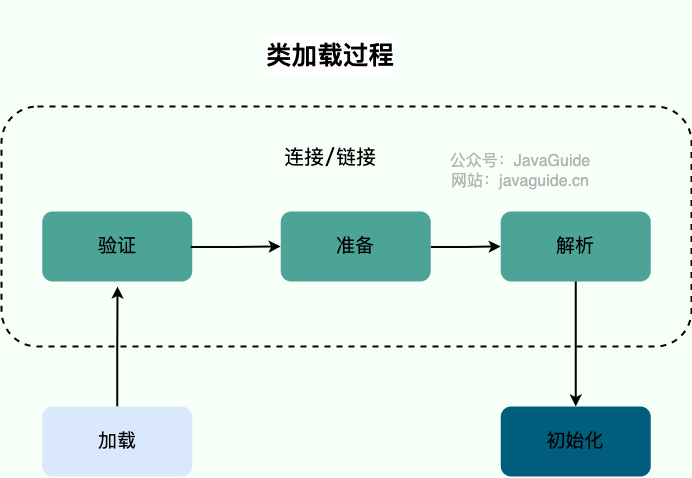
2.1加载
类加载过程的第一步,主要完成下面 3 件事情:
- 通过全类名获取定义此类的二进制字节流。
- 将字节流所代表的静态存储结构转换为方法区的运行时数据结构。
- 在内存中生成一个代表该类的
Class对象,作为方法区这些数据的访问入口。
加载这一步主要是通过我们后面要讲到的 类加载器 完成的。类加载器有很多种,当我们想要加载一个类的时候,具体是哪个类加载器加载由 双亲委派模型 决定(不过,我们也能打破由双亲委派模型)。
每个 Java 类都有一个引用指向加载它的 ClassLoader。不过,数组类不是通过 ClassLoader 创建的,而是 JVM 在需要的时候自动创建的,数组类通过getClassLoader()方法获取 ClassLoader 的时候和该数组的元素类型的 ClassLoader 是一致的。
一个非数组类的加载阶段(加载阶段获取类的二进制字节流的动作)是可控性最强的阶段,这一步我们可以去完成还可以自定义类加载器去控制字节流的获取方式(重写一个类加载器的 loadClass() 方法)。
加载阶段与连接阶段的部分动作(如一部分字节码文件格式验证动作)是交叉进行的,加载阶段尚未结束,连接阶段可能就已经开始了。
2.2验证
验证是连接阶段的第一步,这一阶段的目的是确保 Class 文件的字节流中包含的信息符合《Java 虚拟机规范》的全部约束要求,保证这些信息被当作代码运行后不会危害虚拟机自身的安全。
2.3准备
准备阶段是正式为类变量分配内存并设置类变量初始值的阶段,这些内存都将在方法区中分配。对于该阶段有以下几点需要注意:
这时候进行内存分配的仅包括类变量( Class Variables ,即静态变量,被 static 关键字修饰的变量,只与类相关,因此被称为类变量),而不包括实例变量。实例变量会在对象实例化时随着对象一块分配在 Java 堆中。
从概念上讲,类变量所使用的内存都应当在 方法区 中进行分配。不过有一点需要注意的是:JDK 7 之前,HotSpot 使用永久代来实现方法区的时候,实现是完全符合这种逻辑概念的。 而在 JDK 7 及之后,HotSpot 已经把原本放在永久代的字符串常量池、静态变量等移动到堆中,这个时候类变量则会随着 Class 对象一起存放在 Java 堆中。相关阅读:《深入理解 Java 虚拟机(第 3 版)》勘误#75
这里所设置的初始值”通常情况”下是数据类型默认的零值(如 0、0L、null、false 等),比如我们定义了public static int value=111 ,那么 value 变量在准备阶段的初始值就是 0 而不是 111(初始化阶段才会赋值)。特殊情况:比如给 value 变量加上了 final 关键字public static final int value=111 ,那么准备阶段 value 的值就被赋值为 111。
2.4解析
解析阶段是虚拟机将常量池内的符号引用替换为直接引用的过程。 解析动作主要针对类或接口、字段、类方法、接口方法、方法类型、方法句柄和调用限定符 7 类符号引用进行。
具体来说,解析包括:
- 将类的符号引用(如类名)转换为类的直接引用(即 JVM 中的
Class对象)。 - 将字段的符号引用转换为字段的直接引用(即字段的内存地址)。
- 将方法的符号引用转换为方法的直接引用(即方法的内存地址)。
解析阶段的目的是通过符号表来查找并替换符号引用(类名、字段名等)为实际的地址或对象引用。
例如:
1 | |
2.5初始化阶段
初始化阶段是执行初始化方法 <clinit> ()方法的过程,是类加载的最后一步,这一步 JVM 才开始真正执行类中定义的 Java 程序代码(字节码)。
对于<clinit> () 方法的调用,虚拟机会自己确保其在多线程环境中的安全性。因为 <clinit> () 方法是带锁线程安全,所以在多线程环境下进行类初始化的话可能会引起多个线程阻塞,并且这种阻塞很难被发现。
对于初始化阶段,虚拟机严格规范了有且只有 6 种情况下,必须对类进行初始化(只有主动去使用类才会初始化类):
- 当遇到 new、 getstatic、putstatic 或 invokestatic 这 4 条字节码指令时,比如 new一个类,读取一个静态字段(未被 final 修饰)、或调用一个类的静态方法时。
- 当 jvm 执行
new指令时会初始化类。即当程序创建一个类的实例对象。 - 当 jvm 执行
getstatic指令时会初始化类。即程序访问类的静态变量(不是静态常量,常量会被加载到运行时常量池)。 - 当 jvm 执行
putstatic指令时会初始化类。即程序给类的静态变量赋值。 - 当 jvm 执行
invokestatic指令时会初始化类。即程序调用类的静态方法。
- 当 jvm 执行
- 使用
java.lang.reflect包的方法对类进行反射调用时如Class.forName("..."),newInstance()等等。如果类没初始化,需要触发其初始化。 - 初始化一个类,如果其父类还未初始化,则先触发该父类的初始化。
- 当虚拟机启动时,用户需要定义一个要执行的主类 (包含
main方法的那个类),虚拟机会先初始化这个类。 MethodHandle和VarHandle可以看作是轻量级的反射调用机制,而要想使用这 2 个调用,
就必须先使用findStaticVarHandle来初始化要调用的类。
2.6类卸载
卸载类即该类的 Class 对象被 GC。
卸载类需要满足 3 个要求:
- 该类的所有的实例对象都已被 GC,也就是说堆不存在该类的实例对象。
- 该类没有在其他任何地方被引用
- 该类的类加载器的实例已被 GC
所以,在 JVM 生命周期内,由 jvm 自带的类加载器加载的类是不会被卸载的。但是由我们自定义的类加载器加载的类是可能被卸载的。
只要想通一点就好了,JDK 自带的 BootstrapClassLoader, ExtClassLoader, AppClassLoader 负责加载 JDK 提供的类,所以它们(类加载器的实例)肯定不会被回收。而我们自定义的类加载器的实例是可以被回收的,所以使用我们自定义加载器加载的类是可以被卸载掉的。
类加载器
类加载器是一个负责加载类的对象,用于实现类加载过程中的加载这一步。
每个 Java 类都有一个引用指向加载它的
ClassLoader。数组类不是通过
ClassLoader创建的(数组类没有对应的二进制字节流),是由 JVM 直接生成的。
简单来说,类加载器的主要作用就是加载 Java 类的字节码( .class 文件)到 JVM 中(在内存中生成一个代表该类的 Class 对象)。 字节码可以是 Java 源程序(.java文件)经过 javac 编译得来,也可以是通过工具动态生成或者通过网络下载得来。
1.类加载器加载规则
JVM 启动的时候,并不会一次性加载所有的类,而是根据需要去动态加载。也就是说,大部分类在具体用到的时候才会去加载,这样对内存更加友好。
2.类加载器总结
BootstrapClassLoader(启动类加载器):最顶层的加载类,由 C++实现,通常表示为 null,并且没有父级,主要用来加载 JDK 内部的核心类库(%JAVA_HOME%/lib目录下的rt.jar、resources.jar、charsets.jar等 jar 包和类)以及被-Xbootclasspath参数指定的路径下的所有类。ExtensionClassLoader(扩展类加载器):主要负责加载%JRE_HOME%/lib/ext目录下的 jar 包和类以及被java.ext.dirs系统变量所指定的路径下的所有类。AppClassLoader(应用程序类加载器):面向我们用户的加载器,负责加载当前应用 classpath 下的所有 jar 包和类。
rt.jar:rt 代表“RunTime”,rt.jar是 Java 基础类库,包含 Java doc 里面看到的所有的类的类文件。也就是说,我们常用内置库 java.xxx.*都在里面,比如java.util.*、java.io.*、java.nio.*、java.lang.*、java.sql.*、java.math.*。
Java 9 引入了模块系统,并且略微更改了上述的类加载器。扩展类加载器被改名为平台类加载器(platform class loader)。Java SE 中除了少数几个关键模块,比如说 java.base 是由启动类加载器加载之外,其他的模块均由平台类加载器所加载
除了 BootstrapClassLoader 是 JVM 自身的一部分之外,其他所有的类加载器都是在 JVM 外部实现的,并且全都继承自 ClassLoader抽象类。这样做的好处是用户可以自定义类加载器,以便让应用程序自己决定如何去获取所需的类。
每个 ClassLoader 可以通过getParent()获取其父 ClassLoader,如果获取到 ClassLoader 为null的话,那么该类是通过 BootstrapClassLoader 加载的。
3.自定义类加载器
除了 BootstrapClassLoader 其他类加载器均由 Java 实现且全部继承自java.lang.ClassLoader。如果我们要自定义自己的类加载器,很明显需要继承 ClassLoader抽象类。
我们前面也说说了,除了 BootstrapClassLoader 其他类加载器均由 Java 实现且全部继承自java.lang.ClassLoader。如果我们要自定义自己的类加载器,很明显需要继承 ClassLoader抽象类。
ClassLoader 类有两个关键的方法:
protected Class loadClass(String name, boolean resolve):加载指定二进制名称的类,实现了双亲委派机制 。name为类的二进制名称,resolve如果为 true,在加载时调用resolveClass(Class<?> c)方法解析该类。protected Class findClass(String name):根据类的二进制名称来查找类,默认实现是空方法。
如果我们不想打破双亲委派模型,就重写 ClassLoader 类中的 findClass() 方法即可,无法被父类加载器加载的类最终会通过这个方法被加载。但是,如果想打破双亲委派模型则需要重写 loadClass() 方法。
Object有什么方法
- getClass():获取类的class对象。
- hashCode:获取对象的hashCode值
- equals():比较对象是否相等,比较的是值和地址,子类可重写以自定义。
- clone():克隆方法。
- toString():如果没有重写,应用对象将打印的是地址值。
- notify():随机选择一个在该对象上调用wait方法的线程,解除其阻塞状态。该方法只能在同步方法或同步块内部调用。如果当前线程不是锁的持有者,该方法抛出一个IllegalMonitorStateException异常。
- notifyall():解除所有那些在该对象上调用wait方法的线程的阻塞状态。该方法只能在同步方法或同步块内部调用。如果当前线程不是锁的持有者,该方法抛出一个IllegalMonitorStateException异常。
- wait():导致线程进入等待状态,直到它被其他线程通过notify()或者notifyAll唤醒。该方法只能在同步方法中调用。如果当前线程不是锁的持有者,该方法抛出一个IllegalMonitorStateException异常。
- finalize():对象回收时调用
为什么要设置wait和notify在父类中
将 wait() 和 notify() 放在父类中,可以实现更高效的线程同步和共享资源的管理,避免代码重复,提高可维护性。父类可以集中管理同步逻辑,而子类通过继承父类来获得这些功能,专注于自己的业务逻辑。
重载和重写区别
答:方法的重载和重写都是实现多态的方式,区别在于前者实现的是编译时的多态性,而后者实现的是运行时的多态性。重载发生在一个类中,同名的方法如果有不同的参数列表(参数类型不同、参数个数不同或者二者都不同)则视为重载;重写发生在子类与父类之间,重写要求子类被重写方法与父类被重写方法有相同的参数列表,有兼容的返回类型,比父类被重写方法更好访问,不能比父类被重写方法声明更多的异常(里氏代换原则)。重载对返回类型没有特殊的要求,不能根据返回类型进行区分。
接口是什么,使用的场景,和抽象类区别
反射的概念及应用,反射在JVM层面的底层实现?使用场景?
1.反射的概念
反射(Reflection)是 Java 的一种特性,它可以让程序在运行时获取自身的信息,并且动态地操作类或对象的属性、方法和构造器等。通过反射功能,可以通过反射,程序可以在不知道类的具体实现的情况下,操作类的对象和成员。
定义:反射是指在运行状态(Runtime)**中,对于任意一个类,都能够知道这个类的所有属性和方法;对于任意一个对象,都能够调用它的任意方法和属性。
这种**动态获取信息**以及动态调用对象方法**的功能称为 Java 语言的反射机制。
- 一句话总结:反射就是把 Java 类中的各种成分(成员变量、方法、构造器等)映射成一个个的 Java 对象
2.反射的作用
- 运行时探查类的信息:反射允许我们在运行时加载、检查和使用类,甚至可以在运行时获取一个未加载的类。
- 动态创建对象:使用反射可以实现动态地创建对象,而且可以选择该类的任意一个构造函数来创建对象实例。
- 访问或修改私有成员:反射可以访问和修改一个类中私有的字段和方法,即使这些字段和方法是私有的。
- 扩展应用程序的可控性:反射可以提高应用程序的可扩展性,例如,它可以读取配置文件来决定需要加载哪个类。
3.什么情况下使用反射
- 动态加载类:可以使用类加载器动态加载要使用的类,而不是在编译期间声明对该类的依赖关系。
- 获取类的信息:通过反射可以获取一个类的属性、方法、构造函数等信息,甚至可以获取注解和泛型信息。
- 通过名称调用方法或访问属性:使用反射可以根据方法/属性名称动态地调用/访问对应的方法/属性,这使得编写通用代码更加容易。
- 动态代理:使用反射可以实现动态代理,即在运行时动态地创建一个实现某个接口的代理类,从而实现一些特殊的功能,如事务处理等。
- 获取一个类的Class对象
1 | |
2.获取类中的构造方法
1 | |
3.创建一个实例
1 | |
4.获取类的字段
1 | |
5.修改字段值
1 | |
6.调用类的方法
1 | |
底层实现可以分为两个阶段:
1. 核心前提:类加载与 Class 对象
反射的起点是 Class 对象。当你写下一段代码并编译后,所有的类信息(类名、属性、方法、注解等)都会被写入 .class 文件中。
- 类加载(Class Loading): 当程序运行且首次用到某个类时,ClassLoader 会将 .class 文件加载到 JVM 的内存中(具体是方法区/元空间 Metaspace)。
- 生成镜像: JVM 解析这些字节码后,会在堆内存中自动创建一个 java.lang.Class 类型的实例。这个 Class 对象就像是一面镜子,里面映射了该类的所有结构信息。
- 反射API: 我们平时用的 Class.forName(), obj.getClass(),拿到的就是这个对象。所有的反射操作(获取方法、获取字段)都是在这个 Class 对象上进行的。
2. JVM 底层数据结构 (OOP-Klass 模型)
当你在 Java 层调用 clazz.getDeclaredMethods() 时,底层其实是通过 JNI(Java Native Interface)调用了 JVM 的 C++ 源码。JVM 会顺着 Java Class 对象找到对应的 C++ InstanceKlass 结构,然后从中提取出方法列表、字段列表等元数据,再将这些 C++ 数据转换成 Java 的 Method[] 或 Field[] 数组返回给你。
3. 核心机制:Method.invoke() 的底层执行逻辑
这是反射最核心、也是面试最常问的部分:当我们调用 method.invoke(obj, args) 时,到底发生了什么?
Method.invoke 的底层并不只有一种实现方式,而是采用了一种叫做 “通货膨胀”(Inflation) 的动态切换机制。
当你追踪 invoke 源码,会发现它把工作委托给了 MethodAccessor 接口。这个接口有两个主要实现:
阶段一:本地方法实现 (NativeMethodAccessorImpl)
默认情况下,前 15 次反射调用使用的是它。
- 原理: 它通过 JNI 调用 C++ 编写的底层代码来实现方法的执行。
- 优点: 启动快,不需要生成额外的 Java 字节码。
- 缺点: 每次执行都要跨越 Java 和 C++ 的边界(JNI 调用),执行效率较低。
阶段二:动态字节码生成 (GeneratedMethodAccessorXXX)
- 触发: JVM 会维护一个计数器。当同一个方法的反射调用次数超过阈值(默认是 15 次,由参数 -Dsun.reflect.inflationThreshold 控制)时,JVM 会认为这个方法被频繁调用,于是触发“膨胀机制”。
- 原理: JVM 会在运行期动态生成一个全新的 Java 类(名字类似 sun.reflect.GeneratedMethodAccessor1),这个类里面包含了直接调用目标方法的普通 Java 字节码。然后将反射调用的委托对象切换到这个新生成的类上。
- 优点: 因为是纯 Java 字节码调用,JIT 编译器可以对其进行深度优化(比如内联优化),执行速度极快,接近原生调用。
- 缺点: 动态生成类、加载类需要消耗时间和内存(Metaspace)。
总结: 偶尔用一次反射,走 C++ JNI 层;频繁用反射,JVM 会动态写一段 Java 代码去帮你直接调用,以提升性能。
4. 字段的访问 (Field.get / Field.set)
获取和设置字段的值与方法调用类似,也存在 FieldAccessor。
在底层,如果是通过反射直接修改属性,JVM 往往会借助 Unsafe 类。Unsafe 能够根据字段在对象内存布局中的内存偏移量(Offset),直接对那块内存进行读写,从而实现赋值和取值。这也是为什么反射可以无视 private 修饰符的原因——它直接操作了内存。
5. 权限控制与 setAccessible(true)
在正常 Java 代码中,调用私有方法会在编译期报错。而在反射中,检查是在运行期进行的。
- 当你调用 invoke 时,底层首先会执行 Reflection.ensureMemberAccess() 进行权限检查。
- 如果你调用了 method.setAccessible(true),并不是把方法的修饰符改成了 public,而是将 override 标志位设为 true。
- 在 invoke 执行时,如果看到 override == true,就会直接跳过安全检查。
- 性能提示: 安全检查是非常耗时的字符串匹配和位运算。因此,即使是 public 方法,如果你追求极致性能,在反射调用前执行 setAccessible(true) 也能带来一定的性能提升。
使用场景
Spring IOC
Spring 在启动时会:
- 扫描类
- 读取注解
- 通过反射创建对象
依赖注入(DI)
Spring 会通过反射:
- 找到字段
- 设置可访问
- 注入对象
动态代理
protected是什么情况下不能访问
Java的泛型?泛型擦除机制是什么?java的泛型有了解吗,在什么场景下,需要使用泛型,泛型的底层是什么(Java 中的泛型(两万字超全详解)_java 泛型-CSDN博客)
静态方法和非静态方法的区别,synchronized在静态和非静态方法下的区别
1.synchronized作用于非静态方法
synchronized作用于非静态方法,实际上是对当前实例对象加锁,就是说如果一个实例对象的非静态同步方法获取锁后,该实例对象的其他非静态同步方法必须等待获取锁的方法释放锁后才能获取锁,可是别的实例对象的非静态同步方法因为跟该实例对象的非静态同步方法用的是不同的锁,所以毋须等待该实例对象已获取锁的非静态同步方法释放锁就可以获取他们自己的锁。
情况1:同一个对象在两个线程中分别访问该对象的两个同步方法
结果:会产生互斥。
解释:因为锁针对的是对象,当对象调用一个synchronized方法时,其他同步方法需要等待其执行结束并释放锁后才能执行。
情况2:不同对象在两个线程中调用同一个同步方法
结果:不会产生互斥。
解释:因为是两个对象,锁针对的是对象,并不是方法,所以可以并发执行,不会互斥。形象的来说就是因为我们每个线程在调用方法的时候都是new 一个对象,那么就会出现两个空间,两把钥匙。
2.synchronized作用于静态方法
synchronized作用于静态方法 ,实际上是对当前类的class对象加锁,但是一旦一个静态同步方法获取锁后,其他的静态同步方法都必须等待该方法释放锁后才能获取锁,而不管是同一个实例对象的静态同步方法之间,还是不同的实例对象的静态同步方法之间,只要它们同一个类的实例对象。但是对于一个对象的静态方法和非静态方法,因为不是同一把锁,所以可以同时获取,不会冲突。
接口和抽象类的区别
1.什么是抽象类和接口
抽象方法 即使用 abstract 关键字修饰,仅有声明没有方法体的方法。
1 | |
如果一个类包含一个或者多个抽象方法,该类必须被限定为抽象的。抽象类可以不包含抽象方法。
1 | |
区别
抽象类它的作用就是:定义规范,强制子类符合标准;如果有调用抽象方法,也会制定执行顺序的规则
抽象层次不同
- 抽象类是对类抽象,而接口是对行为的抽象
- 抽象类是对整个类 括属性、行为,但是接口却是对类局部行为进行抽象
跨域不同
- 抽象类所跨域的是具有相似特点的类,而接口却可以跨域不同的类
- 抽象类所体现的是一种继承关系,考虑的是子类与父类本质“是不是”同一类的关系
- 而接口并不要求实现的类与接口是同一本质,它们之间只存在“有没有这个能力”的关系
设计层次不同
抽象类是自下而上的设计,在子类中重复出现的工作,抽象到抽象类中
接口是自上而下,定义行为和规范
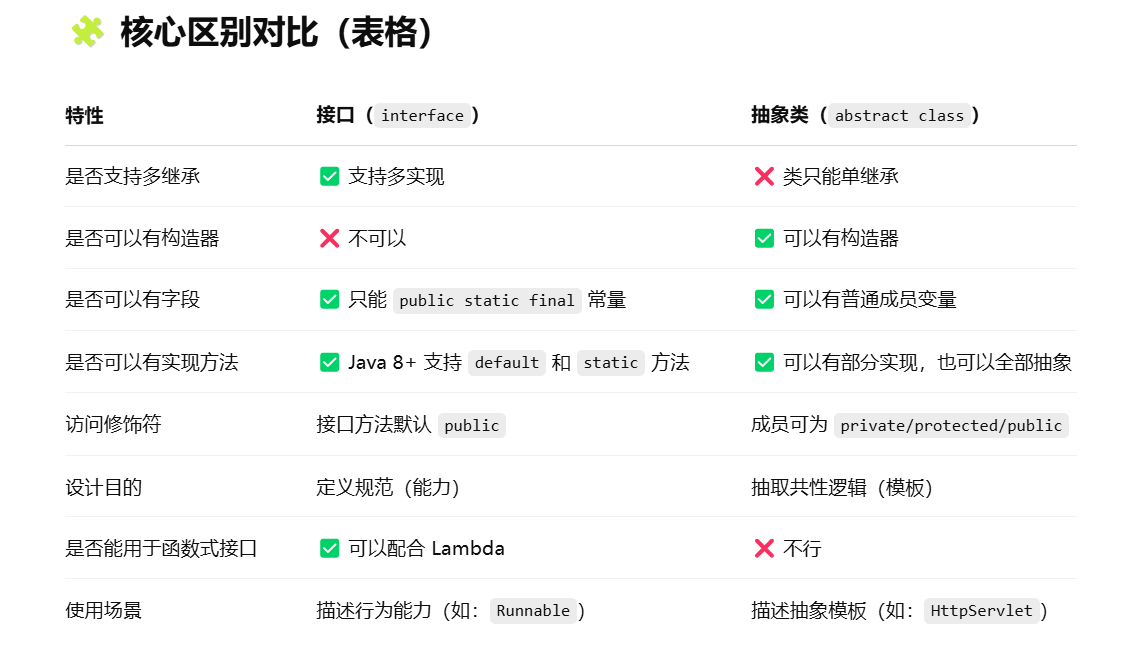
“我一般在设计中,如果是为了提供一组规范或行为能力,比如 Serializable、Runnable 这种,就用接口;如果是为了统一父类的属性、方法和生命周期控制,像 HttpServlet、AbstractList 这种,就会使用抽象类。
局部变量和全局变量 java里如何表示这两个
进程和线程,为什么线程切换开销小, 进程切换时要恢复哪些东西
1.为什么线程切换小
线程是进程的最小执行单元,多个线程共享一个进程的资源(如内存空间、文件句柄等)。所以线程切换不需要切换这些共享资源,开销更小。
线程上下文切换一般涉及:
- CPU 寄存器内容保存/恢复
- 程序计数器(PC)保存/恢复
- 线程栈切换
2.进程切换时要恢复哪些东西
除了线程切换要做的操作,进程切换额外需要:
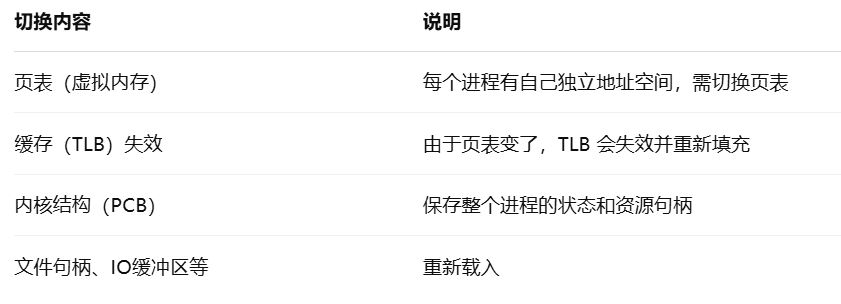
三、 线程切换的详细步骤(微观视角)
当发生线程切换时,操作系统会严格执行以下步骤:
1. 陷入内核(User Mode -> Kernel Mode)
线程通常运行在用户态(Ring 3)。无论是时间片用完引发的硬件中断,还是 I/O 阻塞引发的系统调用,都会导致 CPU 暂停当前指令,权限提升,跳转到操作系统的内核态(Ring 0)去执行中断处理程序。
2. 保存线程 A 的上下文
进入内核后,操作系统会将 CPU 寄存器里的所有当前值,拷贝到**线程 A 的 TCB(线程控制块)**中保存起来。
3. 调度器介入(Scheduler)
操作系统的调度算法(如 Linux 的 CFS 完全公平调度器)开始运行。它会遍历就绪队列,根据优先级、等待时间等规则,挑选出下一个要运行的线程 B。
4. 恢复线程 B 的上下文
调度器选中线程 B 后,找到线程 B 的 TCB,将其之前保存的寄存器数据、PC 指针、栈指针等,重新加载回 CPU 的物理寄存器中。
5. 退出内核(Kernel Mode -> User Mode)
权限降级,CPU 根据刚刚加载的线程 B 的程序计数器(PC)指定的地址,跳转回用户空间,开始执行线程 B 的代码。
java异常机制,Exception下面细分了什么?
Exception 异常又可分为两大类:运行时异常和非运行时异常(编译异常)。程序中应当尽可能去处理这些异常。
运行时异常:RuntimeException类及其子类异常,如NullPointerException(空指针异常)、IndexOutOfBoundsException(下标越界异常)等,这些异常是不可查异常,程序中可以选择捕获处理,也可以不处理。这些异常一般是由程序逻辑错误引起的,程序应该从逻辑角度尽可能避免这类异常的发生。
运行时异常的特点:Java编译器不会检查它,也就是说,当程序中出现这类异常时,也会编译通过。
非运行时异常 (编译异常):是RuntimeException以外的异常,类型上都属于Exception类及其子类。从程序语法角度讲是必须进行处理的异常,如果不处理,程序就不能编译通过。如IOException、SQLException等以及用户自定义的Exception异常,一般情况下不自定义检查异常。
“Java 的异常体系都继承自 Throwable。
Throwable 分为两大类:
- Error:代表 JVM 自身的严重错误,比如 OOM。程序通常无法处理,也无需捕获。
- Exception:代表程序可以处理的异常。它又分为两类:
- 受检异常 (Checked Exception):比如 IOException。编译器会强制我们必须用 try-catch 或 throws 处理,因为它们通常是可预见的外部问题。
- 非受检异常 (Unchecked Exception):也就是 RuntimeException 及其子类,比如 NullPointerException。它们通常是代码逻辑 Bug,编译器不强制处理。”
线程里start方法和run方法有什么区别(start会开启新线程,run不会开启新线程,扔给调用者)
java的序列化要实现一个接口,这个接口有一个序列号UID,这个UID有啥用?,UID怎么来的有了解吗
当一个类实现 Serializable 接口后,Java 允许它的对象被序列化(转换为字节流)并存储或传输。但是,在反序列化时,JVM 会检查当前类的 serialVersionUID 是否与序列化时的 UID 相匹配,如果不匹配,就会抛出 InvalidClassException,表示该类已经发生了不兼容的修改。
怎么来的
1.手动指定 serialVersionUID
2.自动生成 serialVersionUID
“Java 序列化就是把对象转成字节流。主要用于 RPC 远程调用 和 对象持久化。
不过在实际开发中,我们很少用 JDK 自带的 Serializable,因为它性能差且不能跨语言。我们通常使用 JSON(HTTP 接口)或者 Protobuf/Hessian(内部 RPC)来替代它。”
Volatile底层实现,什么场景需要使用volatile关键字?volatile能否保证数组元素的可见性?如何解决?
.volatile的作用**
并发编程中有3大重要特性,了解一下:
- 原子性
一个操作或者多个操作,要么全部执行成功,要么全部执行失败。满足原子性的操作,中途不可被中断。
- 可见性
多个线程共同访问共享变量时,某个线程修改了此变量,其他线程能立即看到修改后的值。
- 有序性
程序执行的顺序按照代码的先后顺序执行。(由于JMM模型中允许编译器和处理器为了效率,进行指令重排序的优化。指令重排序在单线程内表现为串行语义,在多线程中会表现为无序。那么多线程并发编程中,就要考虑如何在多线程环境下可以允许部分指令重排,又要保证有序性)
synchronized关键字同时保证上述三种特性。
synchronized是同步锁,同步块内的代码相当于同一时刻单线程执行,故不存在原子性和指令重排序的问题synchronized关键字的语义JMM有两个规定,保证其实现内存可见性:- 线程解锁前,必须把共享变量的最新值刷新到主内存中;
- 线程加锁前,将清空工作内存中共享变量的值,从主内存中冲洗取值。
volatile关键字作用的是保证可见性和有序性,并不保证原子性。
2.volatile变量的可见性
JMM中规定所有的变量都存储在主内存(Main Memory)中,每条线程都有自己的工作内存(Work Memory),线程的工作内存中保存了该线程所使用的变量的从主内存中拷贝的副本。线程对于变量的读、写都必须在工作内存中进行,而不能直接读、写主内存中的变量。同时,本线程的工作内存的变量也无法被其他线程直接访问,必须通过主内存完成。
整体内存模型如下图所示:
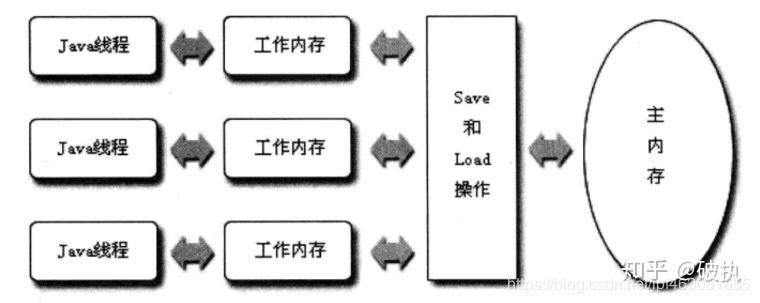
对于普通共享变量,线程A将变量修改后,体现在此线程的工作内存。在尚未同步到主内存时,若线程B使用此变量,从主内存中获取到的是修改前的值,便发生了共享变量值的不一致,也就是出现了线程的可见性问题。
volatile定义:
- 当对volatile变量执行写操作后,JMM会把工作内存中的最新变量值强制刷新到主内存
- 写操作会导致其他线程中的缓存无效
这样,其他线程使用缓存时,发现本地工作内存中此变量无效,便从主内存中获取,这样获取到的变量便是最新的值,实现了线程的可见性。
3.volatile变量的禁止指令重排序
volatile是通过编译器在生成字节码时,在指令序列中添加“内存屏障”来禁止指令重排序的。
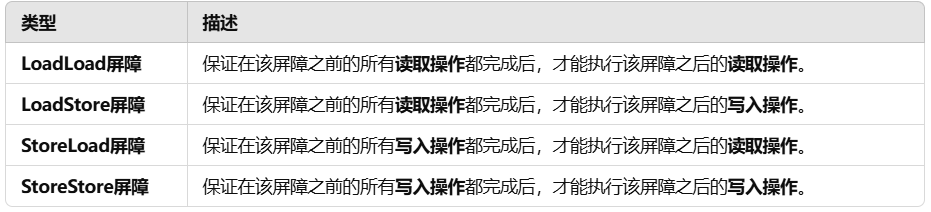
JVM的实现会在volatile读写前后均加上内存屏障,在一定程度上保证有序性。如下所示:
1 | |
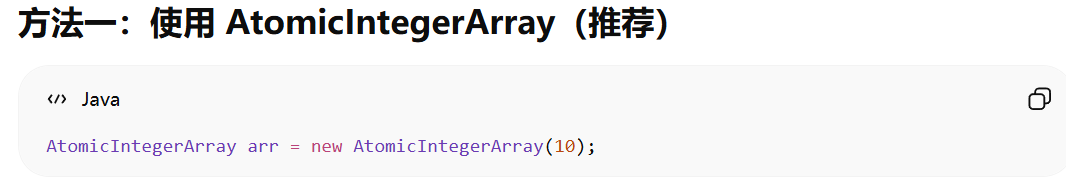
因为 volatile 修饰的是 数组引用本身,而不是 数组里的元素。
java的异常与error(Java中的异常总结详解(异常类型、声明异常、抛出异常、捕获异常)_声明异常的关键字是 ,抛出异常的关键字是 ,捕捉异常的关键字是-CSDN博客)
java对象完整的生命周期(从加载过程开始)
1.先加载类
- 加载:类加载器负责加载类文件,将其字节码加载到内存中
- 验证:验证确保加载的类文件格式正确且符合 JVM 规范,防止非法的类定义进入运行时环境。
- 准备:在此阶段,JVM 为静态变量分配内存,并设置默认值。此时不会执行任何初始化逻辑。
- 解析: 涉及符号引用转换为直接引用。例如,方法调用和字段访问指令中的符号引用会被替换为具体的内存地址。
- 初始化:初始化阶段执行类构造器 () 方法,其中包括静态变量赋值和静态代码块的执行。
**2.内存分配:**在类加载完成后,JVM会在堆内存为对象分配空间(一般在eden区分配,如果对象过大可能会在老年代分配)
3.构造函数的调用:通过构造函数来初始化对象,设置对象的初始状态
4.应用阶段
5.不可达阶段:当对象不在被任何变量引用时,他就变成不可达对象(GC root)
6.Gc阶段:垃圾回收释放内 存
7.销毁阶段:JVM 真正回收对象的内存
额外知识
- 强引用(Strong Reference):普通引用,不可回收
- 软引用(Soft Reference):内存不足时才回收
- 弱引用(Weak Reference):GC 扫描时就回收
- 虚引用(Phantom Reference):用于检测对象被回收的时机
java的cas操作是怎么实现的,unsafe底层层面是怎么样实现的
Java动态代理的实现原理及使用场景?(java动态代理实现与原理详细分析 - Gonjian - 博客园)
Java 语言线程模型,现在使用的是什么线程模型
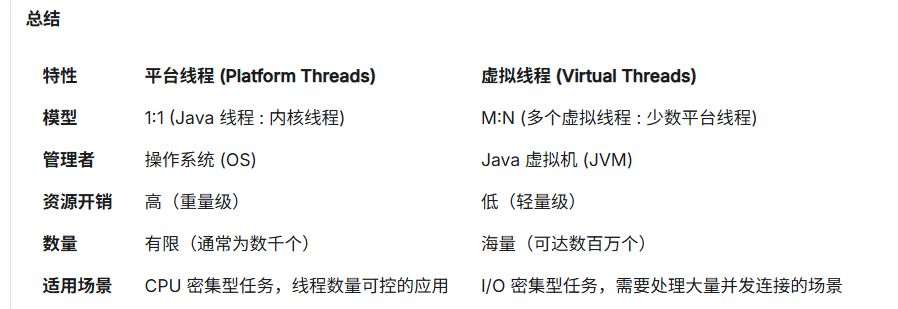
目前,Java 语言主要采用基于操作系统原生线程的 1:1 模型。这意味着每个 Java 线程 (java.lang.Thread) 都直接映射到一个操作系统的内核级线程。此外,从 Java 21 开始,虚拟线程(Virtual Threads) 作为一项重大革新被正式引入,为高并发场景提供了更高效的解决方案。
1. 主流的 1:1 线程模型
自 JDK 1.2 版本以来,Java 就放弃了早期的“绿色线程”(在 JVM 层面模拟的线程),转向了与操作系统更紧密结合的 1:1 线程模型。
核心机制:
- 一对一映射:每一个你通过 new Thread() 创建的 Java 线程,JVM 都会请求操作系统为其创建一个对应的内核线程。[3] 之后,这个 Java 线程的生命周期就与该内核线程绑定。
- 依赖 OS 调度:线程的调度完全由操作系统内核的调度器来负责。[2] Java 线程的优先级(Thread.setPriority())只是向操作系统提供的一个建议,并不保证严格执行。[3]
- 重量级资源:由于内核线程的创建、切换和销毁都需要陷入内核态,这些操作会消耗相当大的系统资源。因此,可以创建的平台线程数量是有限的。[4]
优点:
- 实现简单:线程的创建和管理都委托给了操作系统,简化了 JVM 的设计。
- 充分利用多核:由于直接使用操作系统线程,可以无缝地利用多核 CPU 的并行处理能力。[3] 一个 Java 线程阻塞,不会影响其他线程的执行。[5]
缺点:
- 资源开销大:线程的创建和上下文切换成本较高,不适合需要大量线程的场景。[4]
- 数量受限:受限于操作系统对线程数量的限制。
2. 面向未来的虚拟线程(Project Loom)
为了解决 1:1 模型在超高并发场景下的局限性,Java 引入了虚拟线程(最初作为 Project Loom 的一部分)。该特性在 Java 21 中已经成熟稳定。[6]
核心机制:
- 轻量级线程:虚拟线程是由 JVM 管理的轻量级用户线程,它并不直接与特定的操作系统线程绑定。
- M:N 调度:多个(M)虚拟线程可以被 JVM 调度运行在少数(N)的平台线程上(这些平台线程仍然是 1:1 模型的内核线程)。JVM 内部的调度器负责在虚拟线程发生阻塞(如 I/O 操作)时,将其从平台线程上卸下,并换上另一个可运行的虚拟线程。
- 极低开销:创建和切换虚拟线程的成本远低于平台线程,因为这个过程在 JVM 内部完成,无需内核态切换。这使得创建数百万个虚拟线程成为可能。[6]
优点:
- 高吞吐量:非常适合 I/O 密集型和高并发的应用,可以极大地提升应用的吞吐能力。
- 简化编程模型:开发者可以用传统“一个请求一个线程”的同步阻塞式代码,来编写具有异步非阻塞性能的程序,避免了回调地狱(Callback Hell)。
protected 修饰符的作用域,什么时候用protected 修饰符的作用域
protected 是 Java 的四个访问控制修饰符之一(另外三个是 public、private 和 default (包私有))。它的作用域可以理解为两个部分的并集:
- 包内可见 (Package-Private):同一个包(package)中的任何类都可以访问被 protected 修饰的成员(字段、方法或内部类)。这一点和 default (不写任何修饰符) 的作用域是相同的。
- 子类可见 (Subclass-Visible):在不同包中,只有该类的子类可以访问其父类的 protected 成员。
这些连接点(protected 成员)的特点是:
- 对普通玩家是隐藏的:一个只是“玩”车的人(外部类),根本不需要也看不到这些底盘上的连接点。对他来说,车是一个整体。
- 专门为改装者准备:一个想“改装”这辆车的玩家(子类),他需要拿到你的设计,然后他可以利用你预留的这些 protected 连接点,装上他自己的高性能配件。
protected 就是父类给子类开放的、用于扩展和定制的“内部接口”或“工具”。它对外界是封闭的,但对“自家人”(子类)是开放的。
满足什么条件时,一个 Java 类会被卸载?
类卸载非常罕见,主要发生在大量使用动态类生成(如 CGLib)或热部署的场景。
必须同时满足三个条件:实例没了、ClassLoader 没了、Class 对象没引用了。
只要是 JDK 自带类加载器加载的类,基本不会被卸载。”
#能不能讲一下countdownlatch底层,我想听你对他深刻的理解
第一层:核心思想的提炼(一句话定调)
“我对 CountDownLatch 的深刻理解是:它本质上是一个基于 AQS 实现的、不可重置的‘一次性共享锁(门栓)’。
它的核心思想是解决**‘一等多’或‘多等一’**的线程协同问题。
- 一等多(主线程等子线程): 就像裁判等所有运动员跑过终点线,主线程调用 await() 阻塞,等所有子线程完成任务并分别调用 countDown() 把计数器减到 0 后,主线程才被唤醒继续执行。
- 多等一(子线程等主线程): 就像所有运动员在起跑线上准备好调用 await() 阻塞,裁判主线程一声令下 countDown(),所有子线程瞬间并发冲出起跑线。
而这套机制的底层,完全是由 AQS 的状态变量(state)和等待队列来支撑的。”
第二层:底层源码与 AQS 机制的深度解析(核心硬核部分)
“当我们深入源码,会发现 CountDownLatch 内部其实非常精简。它所有的魔法都委托给了一个继承自 AQS 的私有内部类 Sync。
具体来说,它利用 AQS 做了三件核心的事:”
1. 初始化:将倒数值映射为 AQS 的 state
- 当我们 new CountDownLatch(N) 时,其实就是调用了 Sync 的构造器,直接把这个初始的倒数数值 N,赋值给了 AQS 内部由 volatile 修饰的 state 变量。
- 这个 state 就是整个机制的“命门”,volatile 保证了所有线程对它修改的可见性。
2. await() 的底层逻辑:尝试获取共享锁(失败则进队列阻塞)
- 当线程调用 await() 时,它其实是在调用 AQS 的 acquireSharedInterruptibly(1) 方法。
- 语义是:“尝试以共享模式获取锁,且响应中断”。
- AQS 会回调 CountDownLatch.Sync 实现的 tryAcquireShared() 方法。这个方法的逻辑极其简单粗暴:它只检查当前的 state 是否等于 0。
- 情况 A(门栓已开): 如果 state == 0,返回 1。表示获取锁成功,await() 方法直接 return,线程继续往下走(说明别人都干完活了,或者门本来就是开的)。
- 情况 B(门栓锁着): 如果 state > 0(比如还是初始的 N),返回 -1。表示获取锁失败。
- AQS 的排队机制生效: 获取失败后,AQS 会自动把当前调用 await() 的线程包装成一个 Node 节点,加入到 AQS 底层的双向阻塞队列(CLH 队列)中,并调用 LockSupport.park() 将该线程挂起(阻塞),交出 CPU 资源。
3. countDown() 的底层逻辑:释放共享锁(归零时触发群体唤醒)
- 当工作线程干完活调用 countDown() 时,它其实是在调用 AQS 的 releaseShared(1) 方法。
- 语义是:“尝试以共享模式释放锁”。
- AQS 会回调 Sync 实现的 tryReleaseShared() 方法。这里发生了一个非常关键的**自旋(for(;;))加 CAS(Compare-And-Swap)**操作:
- 读取当前的 state 值。
- 如果 state 已经是 0 了,说明倒数早就结束了,直接返回 false(啥也不做)。
- 如果 state > 0,就尝试用 CAS 将 state 的值减 1(即 state - 1)。
- 质变的发生点: 如果 CAS 减 1 成功,并且减完之后的 state 刚好等于 0 了! 这就意味着“我是最后一个完成任务的线程”。此时 tryReleaseShared() 会返回 true。
- AQS 的唤醒机制生效: 一旦返回 true,AQS 就会从等待队列的头部开始,调用 LockSupport.unpark(),依次唤醒所有因为调用 await() 而被阻塞在队列里的线程。
- 为什么叫“共享锁”? 因为是共享模式,所以这种唤醒是传播式的(Propagate)。被唤醒的第一个线程拿到锁后(因为此时 state 已经等于 0 了),它不仅自己会继续执行,还会立刻唤醒队列里它的下一个邻居,下一个又唤醒下一个,直到队列里所有等待的线程都被“释放”,从而实现了“瞬间并发冲出起跑线”的壮观效果。
第三层:深刻的反思与局限性(对比 CyclicBarrier)
“在深刻理解了它是由 AQS 的 state 减法实现后,我也就明白了 CountDownLatch 最大的局限性:它是一次性的(一次性门栓)。
- 因为 state 减到 0 之后,CountDownLatch 就没有提供任何 API 可以把 state 重新恢复到最初的 N。这扇门一旦打开,就再也关不上了。后续如果有线程再调用 await() 会直接毫无阻拦地通过,调用 countDown() 也不会有任何实质反应。
- 这就把它和另外一个长得很像的工具 CyclicBarrier(循环栅栏) 彻底区分开了。CyclicBarrier 的底层不是直接依赖 AQS 的共享锁,而是基于 ReentrantLock 和 Condition 实现的。它在计数归零并打破栅栏后,可以自动重置计数器(reset()),从而支持循环使用。
- 所以我认为,在架构选型时,CountDownLatch 更适合**‘一次性的大规模事件协调或初始化等待’(比如主线程等待多个后台组件全部加载完毕再启动服务);而 CyclicBarrier 更适合‘分批次、多阶段的迭代计算’**(比如一组线程做完第一阶段的汇总后,在栅栏处等齐了,再一起开始做第二阶段)。”