MySQL:高可用与扩展
mysql的主从复制
什么是主从复制?简单来说就是在主服务器上执行的语句,从服务器执行同样的语句,在主服务器上的操作在从服务器产生了同样的结果。
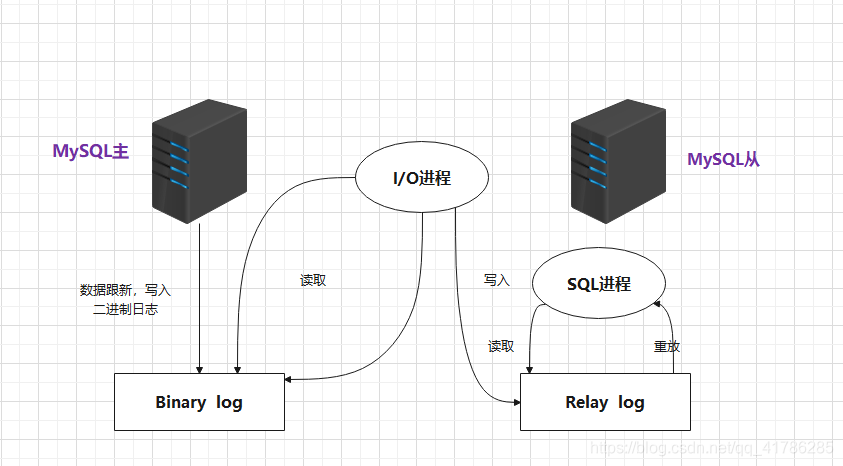
主从复制的基本过程如下:
Master(主数据库)将用户对数据库更新的操作以二进制格式保存到BinaryLog日志文件中。
Slave(从数据库)上面的I0进程连接上Master, 并请求从指定日志文件的指定位置(或者从最开始的日志)之后的日志内容。
Master接收到来自Slave的I0进程的请求后,通过负责复制的I0进程根据请求信息读取制定日志指定位置之后的日志信息,返回给Slave 的I0进程。返回信息中除了日志所包含的信息之外,还包括本次返回的信息已经到Master端的bin-log文件的名称以及bin-log的位置。
Slave的I0进程接收到信息后,将接收到的日志内容依次添加到Slave端的relay-log文件的最末端,并将读取到的Master端的bin-log的文件名和位置记录到master-info文件中,以便在下一次读取的时候能够清楚的告诉Master “我需要从某个bin- log的哪个位置开始往后的日志内容,请发给我”。
Slave的Sql进程检测到relay-log中新增加了内容后,会马上解析relay- log的内容成为在Master端真实执行时候的那些可执行的内容,并在自身执行。
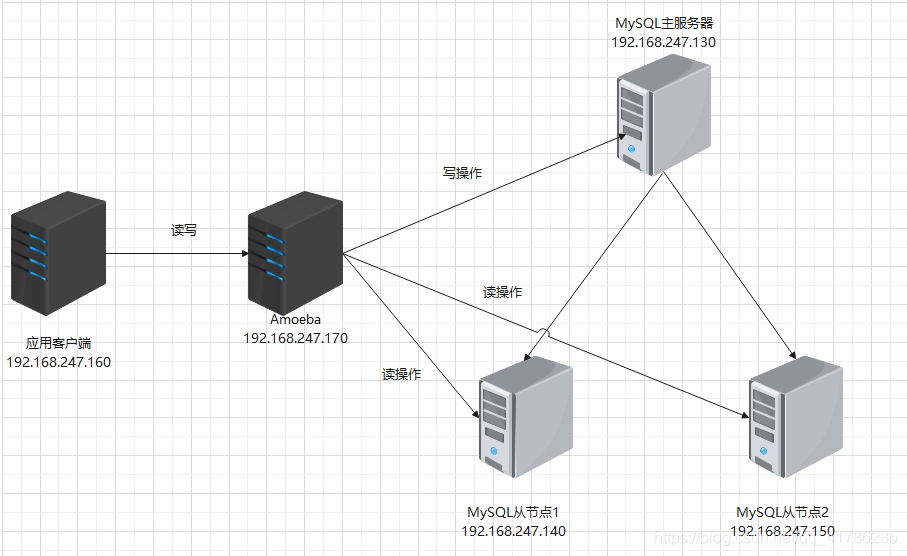
主从读写分离
- 只在主服务器上写,在从服务器上读;
- 主数据库处理事务性查询,从数据库处理SELECT查询;
- 进行读操作时,是在两个从服务器上轮流读取,利用虚拟模块MySQL-Proxy做读取从服务器时的轮询。
主从复制模式
1.主从复制原理
以MySQL一主两从架构为为例,也就是一个master节点下有两个slave节点,在这套架构下,写操作统一交给master节点,读请求交给slave节点处理。
为了保证master节点和slave节点数据一致,在master节点写入数据后,会同时将数据复制到对应的slave节点。主从复制数据的过程中会用到三个线程,master节点上的binlog dump线程,slave节点的I\O线程和SQL线程。
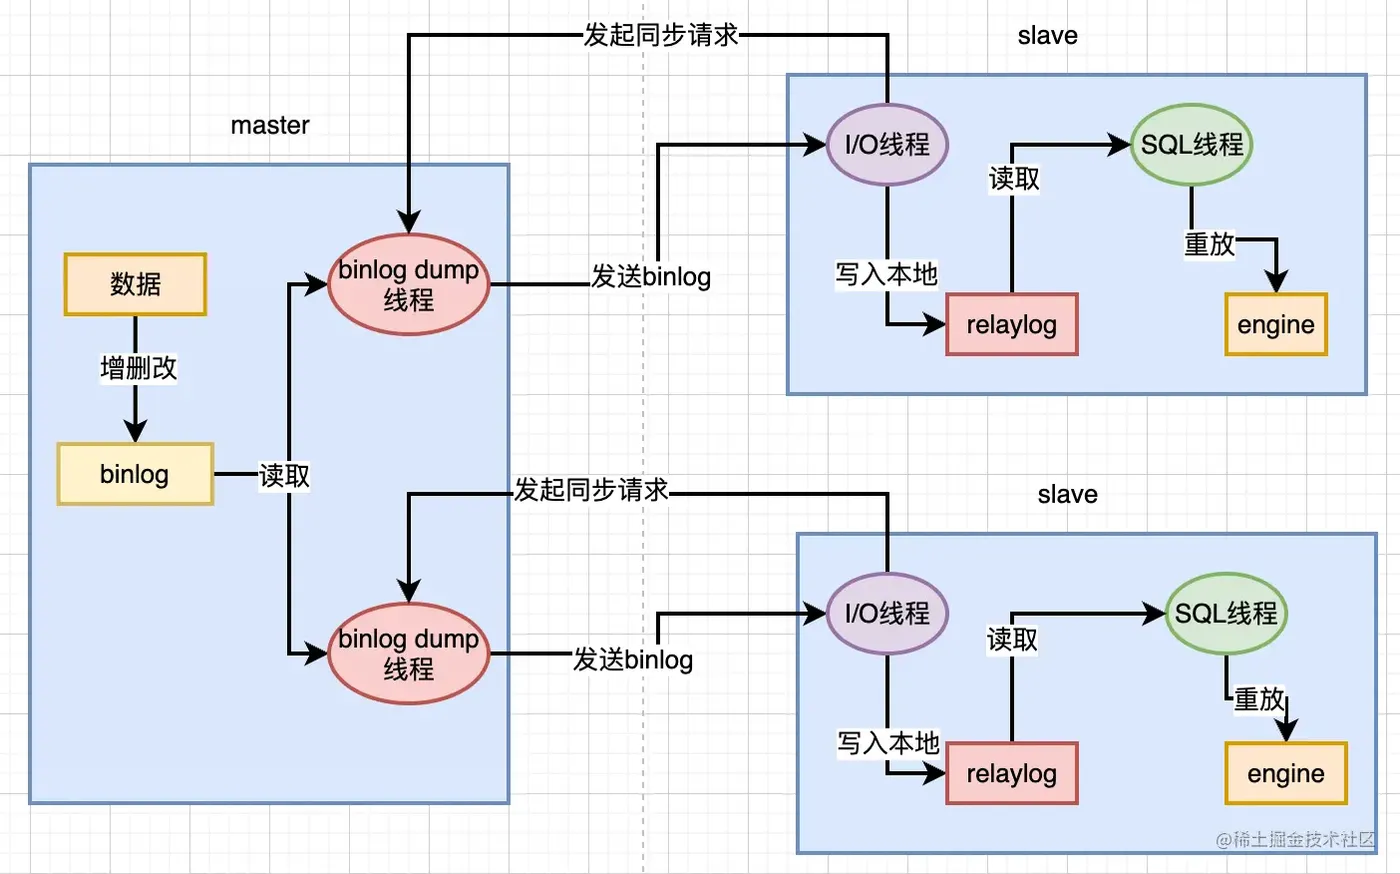
主从复制的核心流程:
- 当master节点接收到一个写请求时,这个写请求可能是增删改操作,此时会把写请求的操作都记录到binlog日志中。
- master节点会把数据赋值给slave节点,如图中的两个slave节点。这个过程首先得要每个slave节点连接到master节点上,当slave节点连接到master节点上时,master节点会为每一个slave节点分别创建一个binlog dump线程,用于向每个slave节点发送binlog日志。
- 此时,binlog dump线程会读取master节点上的binlog日志,然后将binlog日志发送给slave节点上的I/O线程。
- slave几点上的I/O线程接收到binlog日之后,会将binlog日志先写入到本地的relaylog中,relaylog中就保存了master的binlog日志。
- 最后,slave节点上的SQL线程会读取relaylog中的biinlog日志,将其解析成具体的增删改操作,把这些在master节点上进行过的操作,重新在slave节点上也重做一遍,打到数据还原的效果,这样就可以保证master节点和slave节点的数据一致性了。
2.全同步复制
全同步复制,就是当主库执行完一个事物之后,要求所有的从库也都必须执行完该事务,才可以返回处理结果给客户端;因此虽然全同步复制数据一致性得到保证了,但是主库完成一个事物需要等待所有从库也完成,性能就比较低了。
3.异步复制
异步复制,当主库提交事务后会通知binlog dump线程发送binlog日志给从库,一旦binlog dump线程将binlog日志发送给从库之后,不需要等到从库也同步完成事务,主库就会讲处理结果返回给客户端。
因为主库只管自己执行完事务,就可以将处理结果返回给客户端,而不用关系从库是否执行完事务,这就可能导致短暂的主从数据不一致的问题了,比如刚在主库插入的数据,如果马上在从库查询就可能查询不到。
当主库提交食物后,如果宕机挂掉了,此时可能binlog还没来得及同步给从库,这时候如果为了回复故障切换主从节点的话,就会出现数据丢失的问题,所以异步复制虽然性能高,但数据一致性上是比较弱的。
MySQL默认采用的是异步复制模式。
4.半同步复制
半同步复制就是在同步复制和异步中做了折中选择,我们可以结合着MySQL官网来看下是半同步和主从复制的过程。
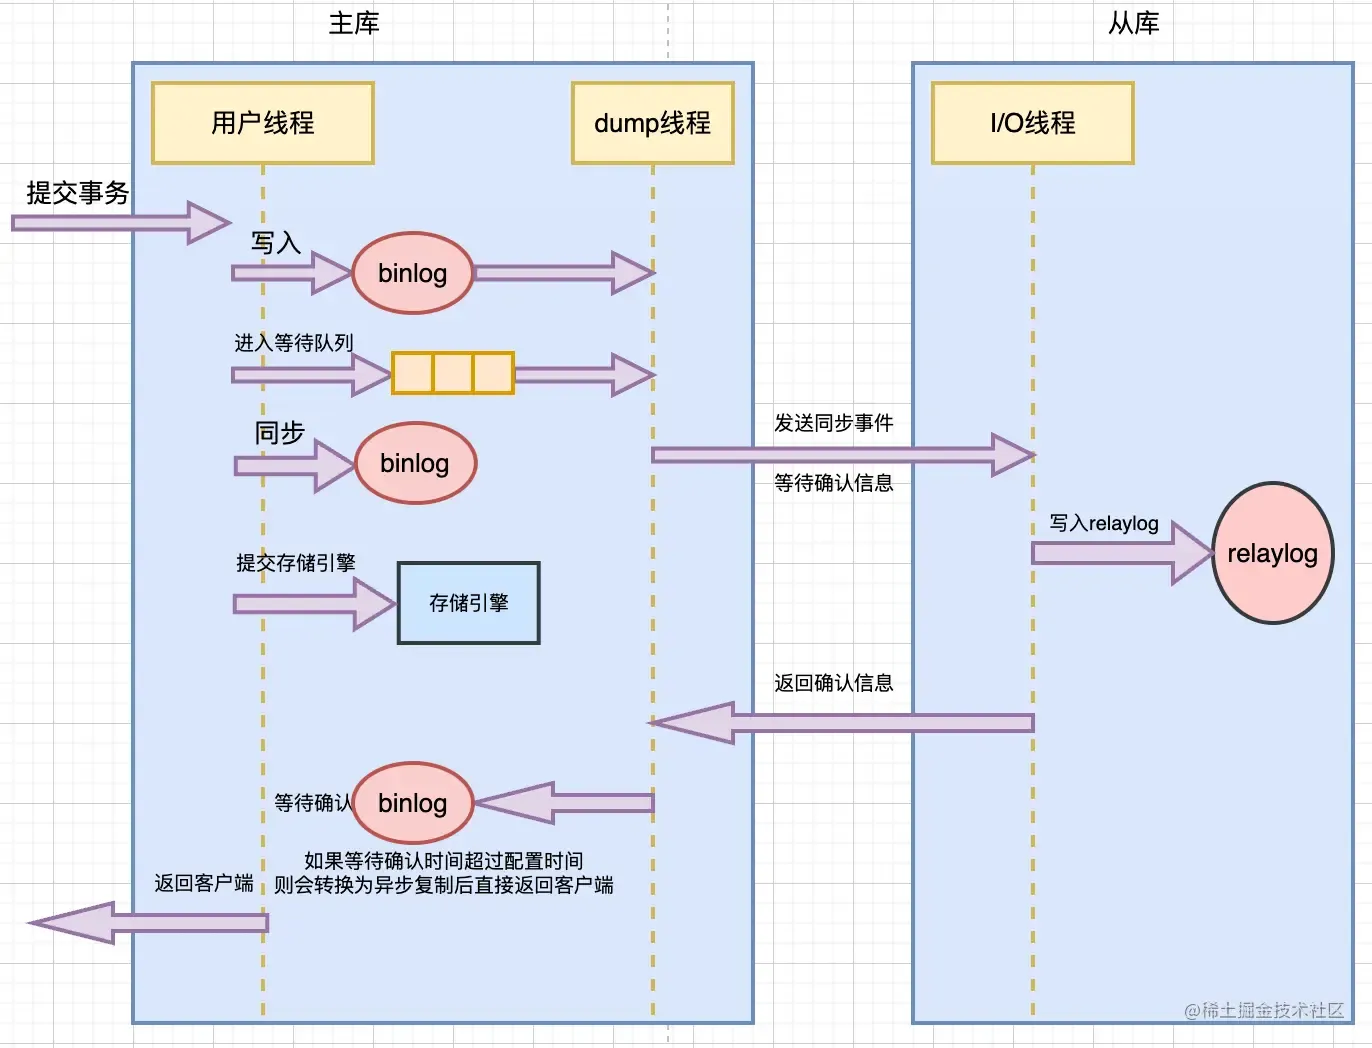
当主库提交事务后,至少还需要一个从库返回接收到binlog日志,并成功写入到relaylog的消息,这个的时候,主库才会讲处理结果返回给客户端。
相比前两种复制方式,半同步复制较好地兼顾了数据一致性以及性能损耗的问题。
同时,半同步复制也存在以下几个问题:
- 半同步复制的性能,相比异步复制而言有所下降,因为需要等到等待至少一个从库确认接收到binlog日志的响应,所以新能上是有所损耗的。
- 主库等待从库响应的最大时长我们是可以配置的,如果超过了我们配置的事件,半同步复制就会变成异步复制,那么,异步复制的问题同样也就出现了。
- 在MySQL5.7.2之前的版本中,半同步复制存在幻读问题。当主库成功提交事务并处于等待从库确认的过程中,这个时候,从库都还没来得及返回处理结果给客户端,但因为主库存储引擎内部已经提交事务了,所以,其他客户端是可以到主库中读到数据的。但是,如果下一秒主库宕机,下次请求过来只能读取从库,因为从库还没有从主库同步数据,所以从库中读取不到这条数据了,和上一次读取数据的结果相比,就造成了幻读的现象。
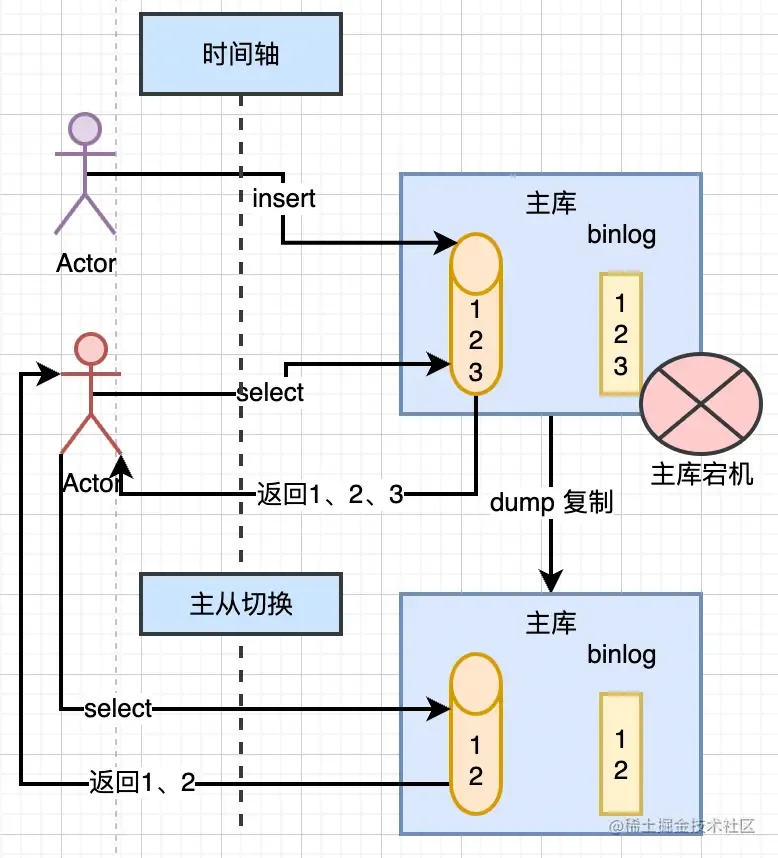
注:异步复制和半同步复制都是在提交完事务之后再将binlog发给从库,防止提交事务前把日志发出去然后回滚导致数据不一致
半同步复制和异步复制一样,也是事务提交后才发送 binlog。但区别在于,半同步复制会等至少一个从库确认收到 binlog 后,主库才会给客户端返回成功,所以能更好地保证数据一致性,减少主库宕机后数据丢失的风险。
你说一下你 SQL 怎么进行优化的吧?如果说你的表单表的一个数据量非常大的话,你怎么进行一个连表查询的优化(https://blog.csdn.net/Tim_phper/article/details/78344444)(https://www.interviewquery.com/p/how-to-optimize-sql-query-with-multiple-joins)
连表查询的优化
1.索引优化
- 给
JOIN连接字段创建索引,加快匹配速度。如 ON A.id = B.id,需在 A.id 和 B.id 上建索引。 - 覆盖索引:尽可能让索引包含查询涉及的列,减少回表查询。
2.优化查询结构(sql)
转换为子查询的方式
一般来说sql语句的执行先执行on, 再执行where语句。
我们可以采用子查询的方式,先where过滤条件让连接的表尽可能的小,在连接之前过滤数据,将多表查询拆分为多个简单查询,分别优化后再组合。
SELECT [c.name](http://c.name/), o.order_id, p.product_name
FROM Customers c
JOIN Orders o ON c.customer_id = o.customer_id
JOIN Products p ON o.product_id = p.product_id
WHERE o.order_date > '2024-01-01' AND c.city = 'New York';

子查询重写
SELECT [c.name](http://c.name/), o.order_id, p.product_name
FROM Customers c
WHERE c.city = 'New York'
AND o.order_id IN (
SELECT order_id
FROM Orders
WHERE order_date > '2024-01-01'
);
避免 SELECT *,只选择需要的列,减少数据传输。
使用 EXISTS 或 IN:在某些情况下,尤其是在处理大型数据集和多个复杂的 JOIN 条件时,使用 EXISTS 或 IN 比创建子查询更有效。这些情况可能包括:
- 相关子查询。如果子查询(EXISTS 或 IN 所在的位置)与外部查询相关,则这些子句比 JOIN 更高效。
- 稀疏数据。当处理没有与其他表对应的行的表时,这些子句的性能可能优于连接。
- 半连接。如果您只需要检查相关行是否存在,而不需要检索数据,那么 EXISTS 和 IN 会非常有用。
使用 INNER JOIN 替代 Outer JOIN
- 如果您只需要两个表中匹配的数据,请使用内连接 (INNER JOIN) 而不是外连接 (LEFT、RIGHT、FULL),以减少编写复杂查询和操作错误
- 选择 JOIN 顺序,以最小化后续 JOIN 中涉及的行数。小表驱动大表
3.数据库分库分表
4.缓存常用查询结果能节省处理时间,特别是复杂查询。
MySQL 主从同步的延迟怎么减少
分库与分表,分表之后怎么切业务,分库分表有什么缺点(实战彻底搞清分库分表(垂直分库,垂直分表,水平分库,水平分表)-腾讯云开发者社区-腾讯云)
读写分离主要应对的是数据库读并发,没有解决数据库存储问题。试想一下:如果 MySQL 一张表的数据量过大怎么办?
1.分库
分库就是将数据库的数据散落到不同的数据库中,分为水平分库和垂直分库
垂直分库就是将单一的数据库按照业务进行划分,不同的业务使用不同的数据库,进而将一个数据库的压力分担到多个数据库
举个例子:说你将数据库中的用户表、订单表和商品表分别单独拆分为用户数据库、订单数据库和商品数据库。
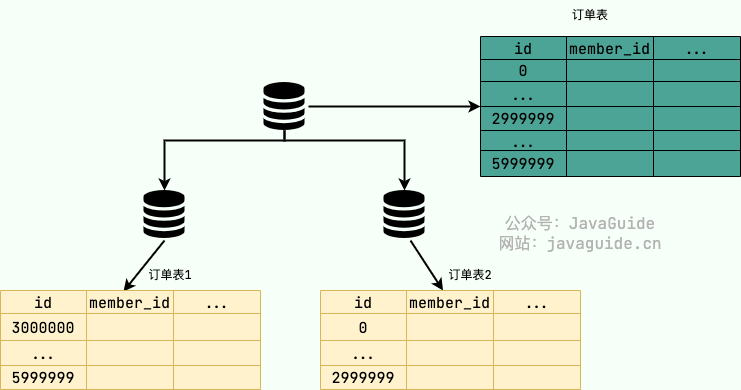
水平分库是把同一个表按照一定规则拆分到不同的数据库中,每个库可以位于不同的服务器上,这样就实现了水平扩展,解决了单表的存储和性能瓶颈的问题。
举个例子:订单表数据量太大,你对订单表进行了水平切分(水平分表),然后将切分后的 2 张订单表分别放在两个不同的数据库。
2.分表
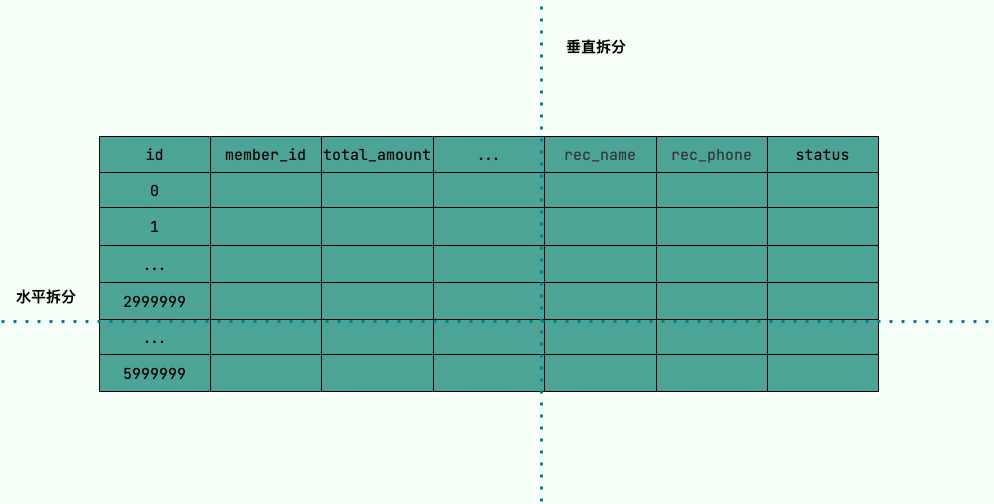
分表 就是对单表的数据进行拆分,可以是垂直拆分,也可以是水平拆分。
垂直分表 是对数据表列的拆分,把一张列比较多的表拆分为多张表,这样就可以进行冷热分离,hot列与cool列分开。
举个例子:我们可以将用户信息表中的一些列单独抽出来作为一个表。
水平分表 是对数据表行的拆分,把一张行比较多的表拆分为多张表,可以解决单一表数据量过大的问题。
举个例子:我们可以将用户信息表拆分成多个用户信息表,这样就可以避免单一表数据量过大对性能造成影响。
水平拆分只能解决单表数据量大的问题,为了提升性能,我们通常会选择将拆分后的多张表放在不同的数据库中。也就是说,水平分表通常和水平分库同时出现。
3.什么情况下需要分库分表
遇到下面几种场景可以考虑分库分表:
- 单表的数据达到千万级别以上,数据库读写速度比较缓慢。
- 数据库中的数据占用的空间越来越大,备份时间越来越长。
- 应用的并发量太大(应该优先考虑其他性能优化方法,而非分库分表)。
不过,分库分表的成本太高,如非必要尽量不要采用。而且,并不一定是单表千万级数据量就要分表,毕竟每张表包含的字段不同,它们在不错的性能下能够存放的数据量也不同,还是要具体情况具体分析。
4.数据层面拆分
按日期拆分:这种使用方式比较普遍,尤其是按照日期维度的拆分,其实在程序层面的改动很小,但是扩展性方面的收益很大。
- 日维度拆分,如test_20191021
- 月维度拆分,如test_201910
- 年维度拆分,如test_2019
按主键范围拆分:例如【1,200w】主键在一个表,【200w,400w】主键在一个表。优点是单表数据量可控。缺点是流量无法分摊,写操作集中在最后面的表。
中间表映射:表随意拆分,引入中间表记录查询的字段值,以及它对应的数据在哪个表里。优点是灵活。确定是引入中间表让流程变复杂。
hash切分:sharding_key%N。优点是数据分片均匀,流量分摊。缺点是扩容需要迁移数据,跨节点查询问题。
5.选择分表字段的原则:
- 数据分布均匀
最佳的分表字段应该是能够让数据分布均匀的字段,这样可以避免某个表的数据过多,导致查询效率降低。在用户表中,如果以地区作为分表字段,可能会导致某些地区的数据过多,而某些地区的数据过少。
- 频繁查询的字段
尽量选择查询频率最高的字段(例如主键id),然后根据表拆分方式选择字段。在一个订单表中,如果经常需要根据用户ID查询订单信息,那么以用户ID作为分表字段是一个不错的选择。
- 不可变字段
最佳的分表字段还应该是不可变的字段,这样可以避免在数据迁移时出现问题。在一个商品表中,如果选择以商品名称作为分表字段,那么当商品名称发生变化时,就需要将数据移动到不同的表中,这样会增加系统的复杂度。
6.分库分表带来的问题
- join操作
水平分表后,虽然物理上分散在多个表中,如果需要与其它表进行join查询,需要在业务代码或者数据库中间件中进行多次join查询,然后将结果合并。
- COUNT(*)操作
水平分表后,某些场景下需要将这些表当作一个表来处理,那么count(*)显得没有那么容易 了。
- order by 操作
分表后,数据分散到多个表中,排序操作无法在数据库中完成,只能由业务代码或数据中间件分别查询每个子表中的数据,然后汇总进行排序。