MySQL:事务与性能优化
索引为什么要用B+树,而不是二叉树、B树?
1.二叉查找树:
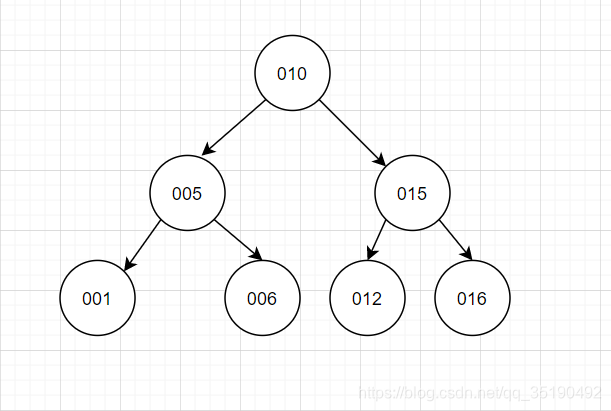
二叉树特点:每个节点最多有2个分叉,左子树和右子树数据顺序左小右大。
这个特点就是为了保证每次查找都可以这折半而减少IO次数,但是二叉树就很考验第一个根节点的取值,因为很容易在这个特点下出现我们并发想发生的情况“树不分叉了”,这就很难受很不稳定。
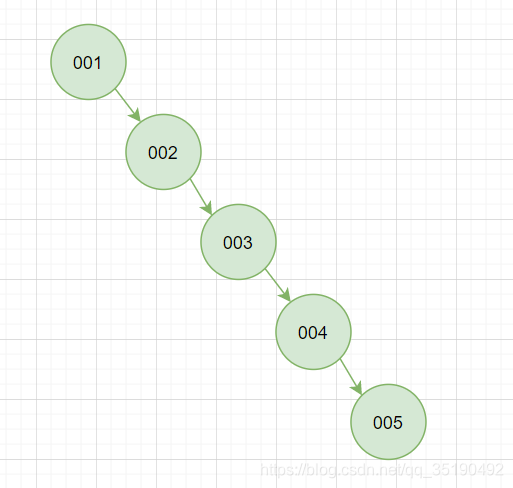
显然这种情况不稳定的我们再选择设计上必然会避免这种情况的
2.平衡二叉树
平衡二叉树是采用二分法思维,平衡二叉查找树除了具备二叉树的特点,最主要的特征是树的左右两个子树的层级最多相差1。在插入删除数据时通过左旋/右旋操作保持二叉树的平衡,不会出现左子树很高、右子树很矮的情况。
使用平衡二叉查找树查询的性能接近于二分查找法,时间复杂度是 O(log2n)。查询id=6,只需要两次IO。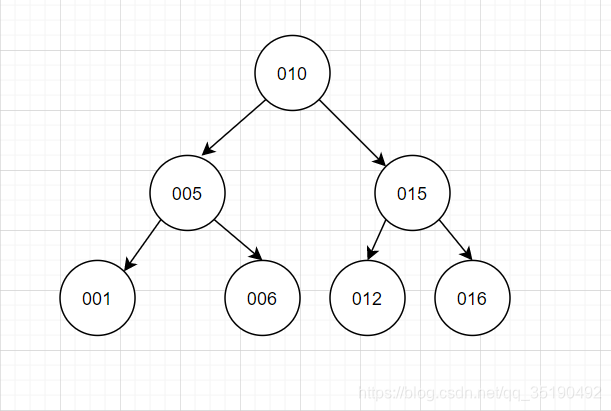
就这个特点来看,可能各位会觉得这就很好,可以达到二叉树的理想的情况了。然而依然存在一些问题:
时间复杂度和树高相关。树有多高就需要检索多少次,每个节点的读取,都对应一次磁盘 IO 操作。树的高度就等于每次查询数据时磁盘 IO 操作的次数。磁盘每次寻道时间为10ms,在表数据量大时,查询性能就会很差。(1百万的数据量,log2n约等于20次磁盘IO,时间20*10=0.2s)
平衡二叉树不支持范围查询快速查找,范围查询时需要从根节点多次遍历,查询效率不高。
3.B树:改造二叉树
MySQL的数据是存储在磁盘文件中的,查询处理数据时,需要先把磁盘中的数据加载到内存中,磁盘IO 操作非常耗时,所以我们优化的重点就是尽量减少磁盘 IO 操作。访问二叉树的每个节点就会发生一次IO,如果想要减少磁盘IO操作,就需要尽量降低树的高度。那如何降低树的高度呢?
假如key为bigint=8字节,每个节点有两个指针,每个指针为4个字节,一个节点占用的空间16个字节(8+4*2=16)。
因为在MySQL的InnoDB存储引擎一次IO会读取的一页(默认一页16K)的数据量,而二叉树一次IO有效数据量只有16字节,空间利用率极低。为了最大化利用一次IO空间,一个简单的想法是在每个节点存储多个元素,在每个节点尽可能多的存储数据。每个节点可以存储1000个索引(16k/16=1000),这样就将二叉树改造成了多叉树,通过增加树的叉树,将树从高瘦变为矮胖。构建1百万条数据,树的高度只需要2层就可以(1000*1000=1百万),也就是说只需要2次磁盘IO就可以查询到数据。磁盘IO次数变少了,查询数据的效率也就提高了。
这种数据结构我们称为B树,B树是一种多叉平衡查找树,如下图主要特点:
B树的节点中存储着多个元素,每个内节点有多个分叉。
节点中的元素包含键值和数据,节点中的键值从大到小排列。也就是说,在所有的节点都储存数据。
父节点当中的元素不会出现在子节点中。
所有的叶子结点都位于同一层,叶节点具有相同的深度,叶节点之间没有指针连接。
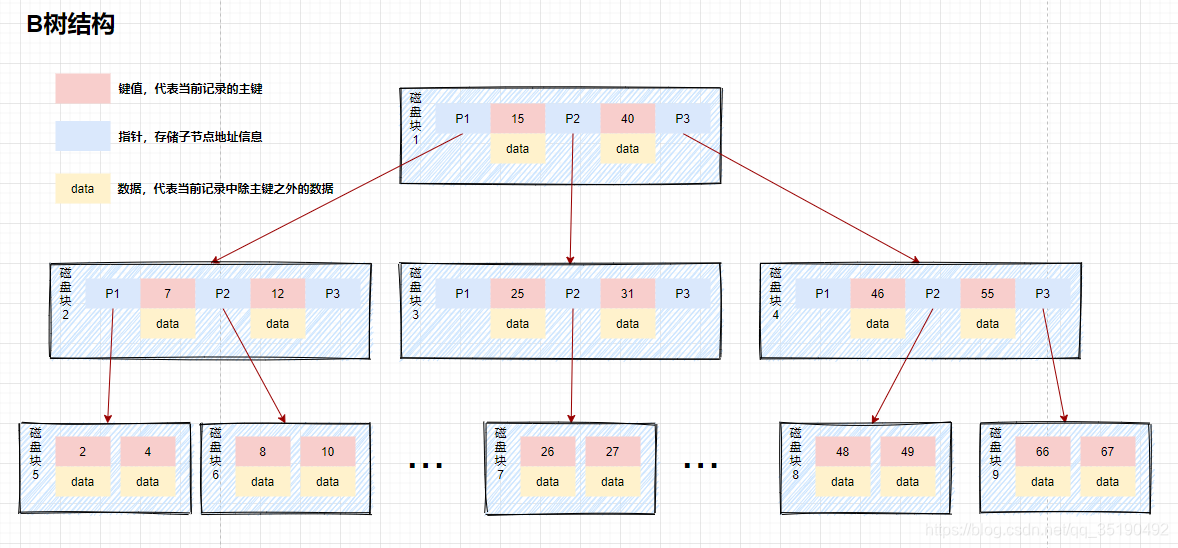
举个例子,在b树中查询数据的情况:
1 | |
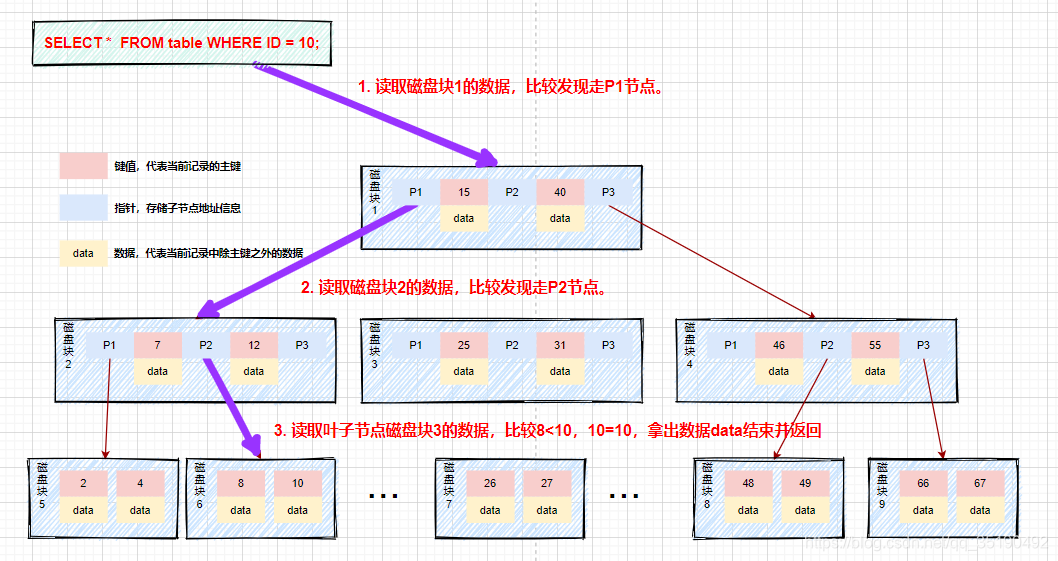
看到这里一定觉得B树就很理想了,但是前辈们会告诉你依然存在可以优化的地方:
B树不支持范围查询的快速查找,你想想这么一个情况如果我们想要查找10和35之间的数据,查找到15之后,需要回到根节点重新遍历查找,需要从根节点进行多次遍历,查询效率有待提高。
如果data存储的是行记录,行的大小随着列数的增多,所占空间会变大。这时,一个页中可存储的数据量就会变少,树相应就会变高,磁盘IO次数就会变大。
4.B+树:改造B树
B+树,作为B树的升级版,在B树基础上,MySQL在B树的基础上继续改造,使用B+树构建索引。B+树和B树最主要的区别在于非叶子节点是否存储数据的问题,这里还要注意,B+树叶子节点包括全部的数据,非叶子节点是副本而已。
- B树:非叶子节点和叶子节点都会存储数据。
- B+树:只有叶子节点才会存储数据,非叶子节点至存储键值。叶子节点之间使用双向指针连接,最底层的叶子节点形成了一个双向有序链表。
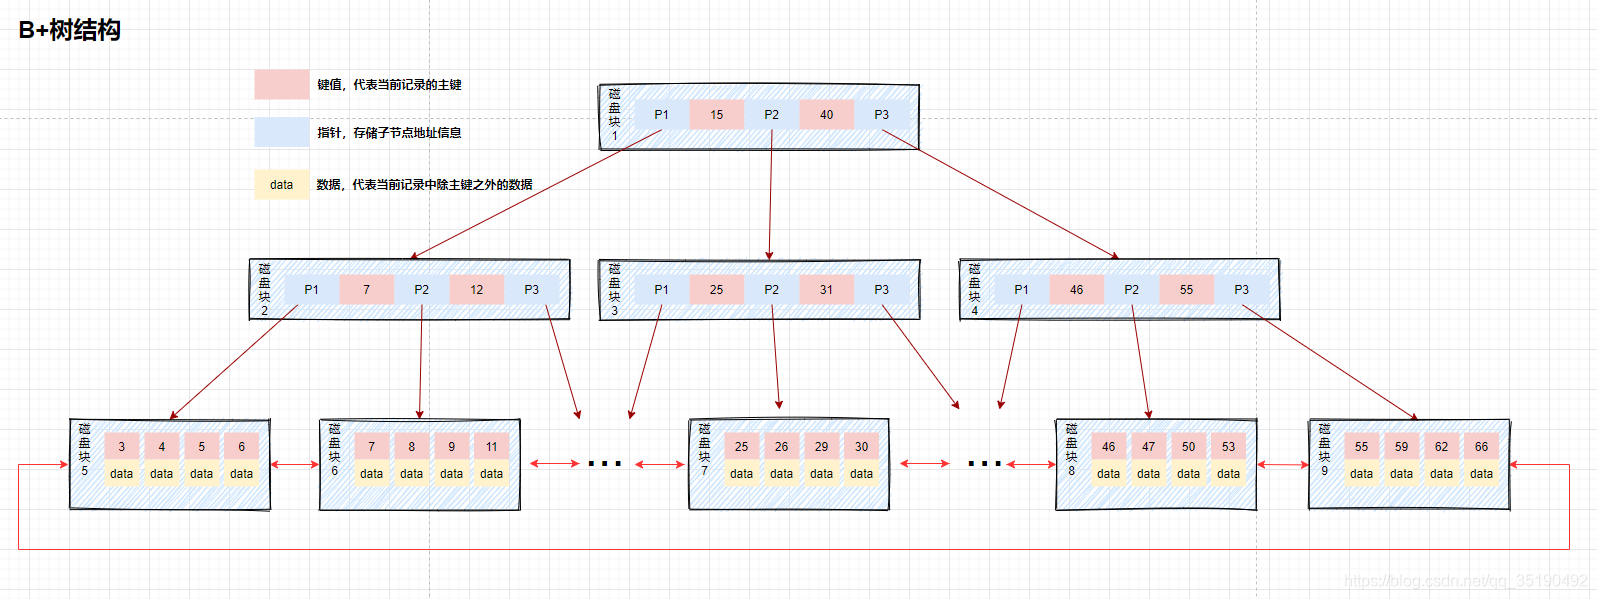
B+树的最底层叶子节点包含了所有的索引项。从图上可以看到,B+树在查找数据的时候,由于数据都存放在最底层的叶子节点上,所以每次查找都需要检索到叶子节点才能查询到数据。所以在需要查询数据的情况下每次的磁盘的IO跟树高有直接的关系,但是从另一方面来说,由于数据都被放到了叶子节点,所以放索引的磁盘块锁存放的索引数量是会跟这增加的,所以相对于B树来说,B+树的树高理论上情况下是比B树要矮的。也存在索引覆盖查询的情况,在索引中数据满足了当前查询语句所需要的全部数据,此时只需要找到索引即可立刻返回,不需要检索到最底层的叶子节点。
- 范围查询
假如我们想要查找9和26之间的数据。查找路径是磁盘块1->磁盘块2->磁盘块6->磁盘块7。
首先查找值等于9的数据,将值等于9的数据缓存到结果集。这一步和前面等值查询流程一样,发生了三次磁盘IO。
查找到15之后,底层的叶子节点是一个有序列表,我们从磁盘块6,键值9开始向后遍历筛选所有符合筛选条件的数据。
第四次磁盘IO:根据磁盘6后继指针到磁盘中寻址定位到磁盘块7,将磁盘7加载到内存中,在内存中从头遍历比较,9<25<26,9<26<=26,将data缓存到结果集。
主键具备唯一性(后面不会有<=26的数据),不需再向后查找,查询终止。将结果集返回给用户。
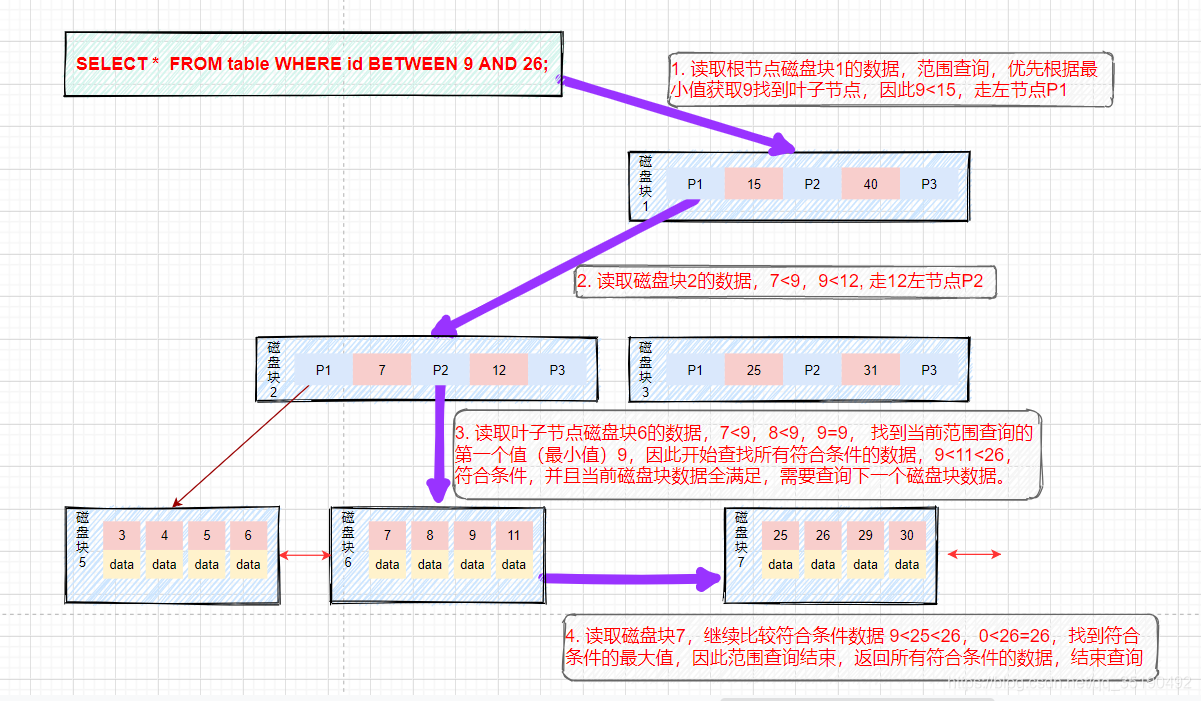
可以看到B+树可以保证等值和范围查询的快速查找,MySQL的索引就采用了B+树的数据结构。
答:“B+ 树相比 B 树有更高的查询效率,尤其适合数据库这种以范围查找、顺序扫描为主的场景。它的中间节点只存 key,不存 value,所以分支更多、树更扁平,能减少磁盘 IO 次数,性能稳定。此外,B+ 树的叶子节点是有序链表,天然支持范围查询,而 B 树没有链表结构,遍历效率不如 B+ 树,因此 MySQL 使用的是 B+ 树索引。”
MySQL中B+树结构,根据主键具体查询过程、二级索引查询过程
MySQL 的索引
MyIsam索引
以一个简单的user表为例。user表存在两个索引,id列为主键索引,age列为普通索引

MyISAM的数据文件和索引文件是分开存储的。MyISAM使用B+树构建索引树时,叶子节点中存储的键值为索引列的值,数据为索引所在行的磁盘地址。
1.主键索引
索引列中的值必须是唯一的,不允许有空值。

根据主键等值查询数据:
1 | |
先在主键树中从根节点开始检索,将根节点加载到内存,比较28<75,走左路。(1次磁盘IO)
将左子树节点加载到内存中,比较16<28<47,向下检索。(1次磁盘IO)
检索到叶节点,将节点加载到内存中遍历,比较16<28,18<28,28=28。查找到值等于30的索引项。(1次磁盘IO)
从索引项中获取磁盘地址,然后到数据文件user.MYD中获取对应整行记录。(1次磁盘IO)
将记录返给客户端。
磁盘IO次数:3次索引检索+记录数据检索。

根据主键范围查询数据:
1 | |
- 先在主键树中从根节点开始检索,将根节点加载到内存,比较28<75,走左路。(1次磁盘IO)
- 将左子树节点加载到内存中,比较16<28<47,向下检索。(1次磁盘IO)
- 检索到叶节点,将节点加载到内存中遍历比较16<28,18<28,28=28<47。查找到值等于28的索引项。
- 根据磁盘地址从数据文件中获取行记录缓存到结果集中。(1次磁盘IO)
- 我们的查询语句时范围查找,需要向后遍历底层叶子链表,直至到达最后一个不满足筛选条件。
- 向后遍历底层叶子链表,将下一个节点加载到内存中,遍历比较,28<47=47,根据磁盘地址从数据文件中获取行记录缓存到结果集中。(1次磁盘IO)
- 最后得到两条符合筛选条件,将查询结果集返给客户端。
磁盘IO次数:4次索引检索+记录数据检索。

2.辅助索引
在 MyISAM 中,辅助索引和主键索引的结构是一样的,没有任何区别,叶子节点的数据存储的都是行记录的磁盘地址。只是主键索引的键值是唯一的,而辅助索引的键值可以重复。
查询数据时,由于辅助索引的键值不唯一,可能存在多个拥有相同的记录,所以即使是等值查询,也需要按照范围查询的方式在辅助索引树中检索数据。
InnoDB索引
1.主键索引(聚簇索引)
每个InnoDB表都有一个聚簇索引 ,聚簇索引使用B+树构建,叶子节点存储的数据是整行记录。一般情况下,聚簇索引等同于主键索引,当一个表没有创建主键索引时,InnoDB会自动创建一个ROWID字段来构建聚簇索引。InnoDB创建索引的具体规则如下:
- 在表上定义主键PRIMARY KEY,InnoDB将主键索引用作聚簇索引。
- 如果表没有定义主键,InnoDB会选择第一个不为NULL的唯一索引列用作聚簇索引。
- 如果以上两个都没有,InnoDB 会使用一个6 字节长整型的隐式字段 ROWID字段构建聚簇索引。该ROWID字段会在插入新行时自动递增。
除聚簇索引之外的所有索引都称为辅助索引。在中InnoDB,辅助索引中的叶子节点存储的数据是该行的主键值都。 在检索时,InnoDB使用此主键值在聚簇索引中搜索行记录。
这里以user_innodb为例,user_innodb的id列为主键,age列为普通索引。

InnoDB的数据和索引存储在一个文件t_user_innodb.ibd中。InnoDB的数据组织方式,是聚簇索引。
主键索引的叶子节点会存储数据行,辅助索引只会存储主键值。

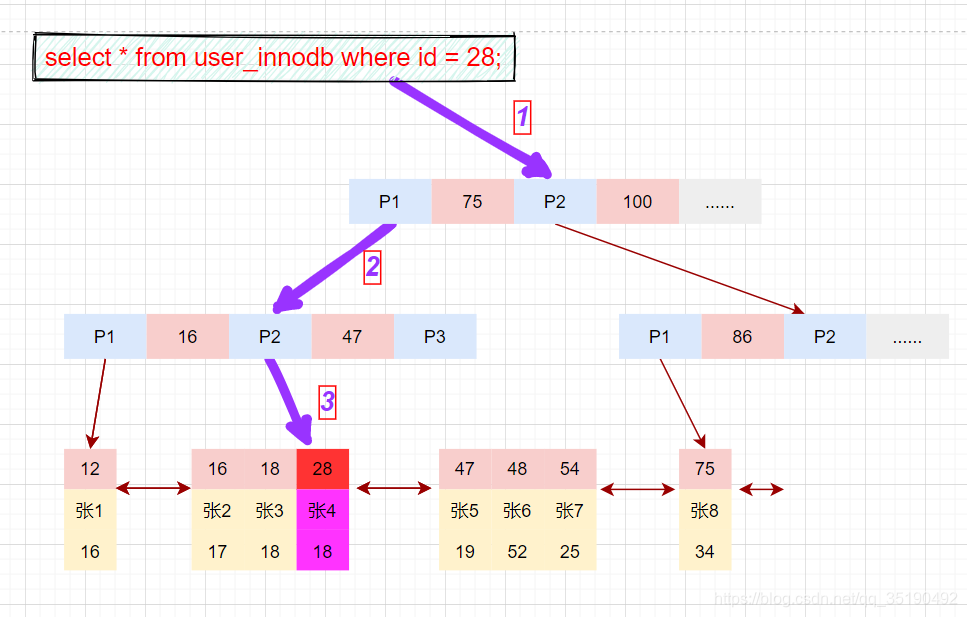
等值查询数据:
1 | |
先在主键树中从根节点开始检索,将根节点加载到内存,比较28<75,走左路。(1次磁盘IO)
将左子树节点加载到内存中,比较16<28<47,向下检索。(1次磁盘IO)
检索到叶节点,将节点加载到内存中遍历,比较16<28,18<28,28=28。查找到值等于28的索引项,直接可以获取整行数据。将改记录返回给客户端。(1次磁盘IO)
2.辅助索引
除聚簇索引之外的所有索引都称为辅助索引,InnoDB的辅助索引只会存储主键值而非磁盘地址。
以表user_innodb的age列为例,age索引的索引结果如下图。

底层叶子节点的按照(age,id)的顺序排序,先按照age列从小到大排序,age列相同时按照id列从小到大排序。
使用辅助索引需要检索两遍索引:首先检索辅助索引获得主键,然后使用主键到主索引中检索获得记录。
画图分析等值查询的情况:
1 | |

根据在辅助索引树中获取的主键id,到主键索引树检索数据的过程称为回表查询。
磁盘IO数:辅助索引3次+获取记录回表3次
3.组合索引
还是以自己创建的一个表为例:表 abc_innodb,id为主键索引,创建了一个联合索引idx_abc(a,b,c)。

组合索引的数据结构:

组合索引的查询过程:
1 | |
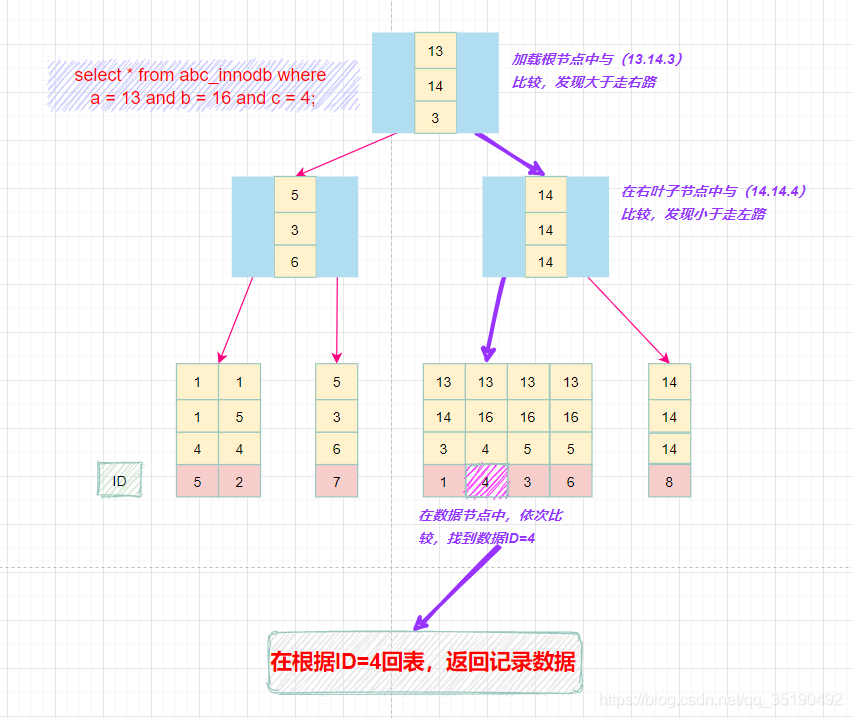
最左匹配原则:
最左前缀匹配原则和联合索引的索引存储结构和检索方式是有关系的。
在组合索引树中,最底层的叶子节点按照第一列a列从左到右递增排列,但是b列和c列是无序的,b列只有在a列值相等的情况下小范围内递增有序,而c列只能在a,b两列相等的情况下小范围内递增有序。
就像上面的查询,B+树会先比较a列来确定下一步应该搜索的方向,往左还是往右。如果a列相同再比较b列。但是如果查询条件没有a列,B+树就不知道第一步应该从哪个节点查起。
可以说创建的idx_abc(a,b,c)索引,相当于创建了(a)、(a,b)(a,b,c)三个索引。、
4.覆盖索引
覆盖索引并不是说是索引结构,覆盖索引是一种很常用的优化手段。因为在使用辅助索引的时候,我们只可以拿到主键值,相当于获取数据还需要再根据主键查询主键索引再获取到数据。但是试想下这么一种情况,在上面abc_innodb表中的组合索引查询时,如果我只需要abc字段的,那是不是意味着我们查询到组合索引的叶子节点就可以直接返回了,而不需要回表。这种情况就是覆盖索引。
避免回表
在InnoDB的存储引擎中,使用辅助索引查询的时候,因为辅助索引叶子节点保存的数据不是当前记录的数据而是当前记录的主键索引,索引如果需要获取当前记录完整数据就必然需要根据主键值从主键索引继续查询。这个过程我们成位回表。想想回表必然是会消耗性能影响性能。那如何避免呢?
使用索引覆盖,举个例子:现有User表(id(PK),name(key),sex,address,hobby…)
如果在一个场景下,select id,name,sex from user where name =’zhangsan’;这个语句在业务上频繁使用到,而user表的其他字段使用频率远低于它,在这种情况下,如果我们在建立 name 字段的索引的时候,不是使用单一索引,而是使用联合索引(name,sex)这样的话再执行这个查询语句是不是根据辅助索引查询到的结果就可以获取当前语句的完整数据。这样就可以有效地避免了回表再获取sex的数据。
这里就是一个典型的使用覆盖索引的优化策略减少回表的情况。
5.联合索引的使用
联合索引,在建立索引的时候,尽量在多个单列索引上判断下是否可以使用联合索引。联合索引的使用不仅可以节省空间,还可以更容易的使用到索引覆盖。试想一下,索引的字段越多,是不是更容易满足查询需要返回的数据呢。比如联合索引(a_b_c),是不是等于有了索引:a,a_b,a_b_c三个索引,这样是不是节省了空间,当然节省的空间并不是三倍于(a,a_b,a_b_c)三个索引,因为索引树的数据没变,但是索引data字段的数据确实真实的节省了。
联合索引的创建原则,在创建联合索引的时候因该把频繁使用的列、区分度高的列放在前面,频繁使用代表索引利用率高,区分度高代表筛选粒度大,这些都是在索引创建的需要考虑到的优化场景,也可以在常需要作为查询返回的字段上增加到联合索引中,如果在联合索引上增加一个字段而使用到了覆盖索引,那我建议这种情况下使用联合索引。
联合索引的使用
- 考虑当前是否已经存在多个可以合并的单列索引,如果有,那么将当前多个单列索引创建为一个联合索引。
- 当前索引存在频繁使用作为返回字段的列,这个时候就可以考虑当前列是否可以加入到当前已经存在索引上,使其查询语句可以使用到覆盖索引。
- 最左前缀原则:这是基础,我会确保核心查询条件位于索引的最左边,否则索引失效。
- 规避范围陷阱:我会把等值查询(=)的字段放在前面,范围查询(>、<)的字段放在最后。因为一旦遇到范围查询,索引匹配就停止了,后面的字段就浪费了。
6.全文索引(一文给你讲清楚MySql全文索引实战和原理1:什么是全文索引 在当我们进行模糊查询的时候,一般都是使用 like 关键字 - 掘金)
“全文索引主要用于解决LIKE %keyword%导致的全表扫描性能问题。
它的核心原理是倒排索引,即建立‘关键词到文档 ID’的映射关系。
做过索引优化吗,说说索引优化策略
1.高效创建索引
主键索引规范
建议使用int/bitint类型自增id作为主键,避免使用uuid等无序数据作为主键。有序主键能保证顺序io提升性能,无序主键是随机io,会导致聚簇索引的插入变成完成随机和频繁页分裂。
选择合适索引列顺序
在多列的B+树索引中,索引会按照最左列进行排序,其次是第二列,因此索引的顺序对于查询是至关重要的,将选择性更高的字段放到索引的前面,可以更快地过滤出需要的行。
2.索引覆盖避免回表
将经常查询的字段,建立联合索引
在查询数据时,MySQL 就会使用该覆盖索引进行优化,直接从索引中获取到需要的数据,避免了对数据表的全表扫描,提高了查询效率。这种索引被称为覆盖索引,可以帮助我们避免回表操作。
覆盖索引可以极大地提高性能,因为只需要扫描索引,这种方式能带来很多好处:
索引条目一般远小于数据行大小,只读取索引,极大减少数据访问量,而且索引更容易全部放入内存,对IO密集型应用性能提升很大
索引按照列顺序存储,范围查询会比随机从磁盘读取每一行数据的IO要少得多
InnoDB的辅助索引覆盖查询,可以避免对主键索引的二次查询
3.使用前缀索引
前缀索引是指对于一个列的值,只取其前几个字符建立索引。使用前缀索引的好处是可以大大减小索引的大小,提高查询效率。
举个例子,我们有一个用户表(user),包含了用户ID、用户名、邮箱等字段。假设我们需要对用户名进行索引,但是用户名过长,建立完整的索引可能会占用较多的空间,影响索引效率。这时,可以使用前缀索引来优化索引。可以使用以下 SQL 语句来创建该前缀索引:
CREATE INDEX username_prefix_idx ON user (username(10));
其中,username_prefix_idx是索引的名称,user是表名,username是需要建立索引的字段名,(10)表示该索引只对用户名的前10个字符进行建立。
需要注意的是,对于使用前缀索引的字段,查询时也需要使用该前缀才能使用索引优化。比如,以下 SQL 查询语句可以使用该前缀索引进行优化:
1 | |
而以下 SQL 查询语句无法使用该前缀索引进行优化:
1 | |
因为 %abc% 包含了用户名的后缀,无法使用前缀索引进行优化。
遇到前缀区分度不够好的情况下,比如我们国家的身份证号有18位,其中前6位是地址码,所以同一个县的人身份证号前6位一般是相同的。如果维护的是一个县的公民信息系统,对身份证号做长度为6的前缀索引区分度会很低,但索引长度选取越占用磁盘空间越大,相同数据页能放下的索引值就越少,搜索效率也就越低。方式是使用倒序存储。我们可以将身份证号倒过来存储,每次查询的时候这么写
1 | |
5.利用索引扫描做排序
在MySQL中,如果我们使用ORDER BY对查询结果进行排序,如果数据量较大,可能会导致性能下降,因为MySQL会在内存或磁盘上对所有查询结果进行排序。为了避免这种情况,我们可以利用索引扫描来进行排序。具体来说,我们可以利用覆盖索引或者索引合并的方式来实现索引扫描排序。
利用覆盖索引进行排序
我们可以建立一个包含ORDER BY字段和需要查询的字段的索引,这样MySQL可以使用索引扫描来满足ORDER BY操作,而不必再去扫描表中其他的行。
假设对上面students表需要按照age字段进行排序,可以这样建立索引:
1 | |
这样,我们在进行查询时,就可以利用age_index索引来排序了:
1 | |
利用索引合并进行排序
当我们需要对多个字段进行排序时,我们可以建立多个单列索引,MySQL会自动选择最优的索引组合来进行排序。这个过程被称为索引合并。
例如,假设我们需要按照name和age字段进行排序,我们可以这样建立索引:
1 | |
1 | |
这样,在进行查询时,MySQL会自动选择最优的索引组合来满足ORDER BY操作:
1 | |
需要注意的是,索引合并会增加查询的开销,因为MySQL需要扫描多个索引,将结果进行合并。因此,在建立索引时需要根据实际情况进行权衡,选择最优的索引策略。
mysql的隔离级别有哪些,隔离级别分别适用哪些场景?
事务的 ACID
事务具有四个特征:原子性( Atomicity )、一致性( Consistency )、隔离性( Isolation )和持续性( Durability )。这四个特性简称为 ACID 特性。
- 原子性。事务是数据库的逻辑工作单位,事务中包含的各操作要么都做,要么都不做
- 一致性。事 务执行的结果必须是使数据库从一个一致性状态变到另一个一致性状态。因此当数据库只包含成功事务提交的结果时,就说数据库处于一致性状态。如果数据库系统 运行中发生故障,有些事务尚未完成就被迫中断,这些未完成事务对数据库所做的修改有一部分已写入物理数据库,这时数据库就处于一种不正确的状态,或者说是 不一致的状态。
- 隔离性。一个事务的执行不能其它事务干扰。即一个事务内部的操作及使用的数据对其它并发事务是隔离的,并发执行的各个事务之间不能互相干扰。
- 持续性。也称永久性,指一个事务一旦提交,它对数据库中的数据的改变就应该是永久性的。接下来的其它操作或故障不应该对其执行结果有任何影响。
Mysql的四种隔离级别
1.Read Uncommitted(读取未提交内容)
在该隔离级别,所有事务都可以看到其他未提交事务的执行结果。本隔离级别很少用于实际应用,因为它的性能也不比其他级别好多少。读取未提交的数据,也被称之为脏读(Dirty Read)。
2.Read Committed(读取提交内容)
这是大多数数据库系统的默认隔离级别(但不是MySQL默认的)。它满足了隔离的简单定义:一个事务只能看见已经提交事务所做的改变。这种隔离级别 也支持所谓的不可重复读(Nonrepeatable Read),因为同一事务的其他实例在该实例处理其间可能会有新的commit,所以同一select可能返回不同结果。
3.Repeatable Read(可重读)
这是MySQL的默认事务隔离级别,它确保同一事务的多个实例在并发读取数据时,会看到同样的数据行。不过理论上,这会导致另一个棘手的问题:幻读 (Phantom Read)。简单的说,幻读指当用户读取某一范围的数据行时,另一个事务又在该范围内插入了新行,当用户再读取该范围的数据行时,会发现有新的“幻影” 行。InnoDB和Falcon存储引擎通过多版本并发控制(MVCC,Multiversion Concurrency Control)机制解决了该问题。
4.Serializable(可串行化)
这是最高的隔离级别,它通过强制事务排序,使之不可能相互冲突,从而解决幻读问题。简言之,它是在每个读的数据行上加上共享锁。在这个级别,可能导致大量的超时现象和锁竞争。
这四种隔离级别采取不同的锁类型来实现,若读取的是同一个数据的话,就容易发生问题。例如:
脏读(Drity Read):某个事务已更新一份数据,另一个事务在此时读取了同一份数据,由于某些原因,前一个RollBack了操作,则后一个事务所读取的数据就会是不正确的。
不可重复读(Non-repeatable read)指在一个事务内多次读同一数据。在这个事务还没有结束时,另一个事务也访问该数据。那么,在第一个事务中的两次读数据之间,由于第二个事务的修改导致第一个事务两次读取的数据可能不太一样。这就发生了在一个事务内两次读到的数据是不一样的情况,因此称为不可重复读。
例如:事务 1 读取某表中的数据 A=20,事务 2 也读取 A=20,事务 1 修改 A=A-1,事务 2 再次读取 A =19,此时读取的结果和第一次读取的结果不同
幻读与不可重复读类似。它发生在一个事务读取了几行数据,接着另一个并发事务插入了一些数据时。在随后的查询中,第一个事务就会发现多了一些原本不存在的记录,就好像发生了幻觉一样,所以称为幻读。
例如:事务 2 读取某个范围的数据,事务 1 在这个范围插入了新的数据,事务 2 再次读取这个范围的数据发现相比于第一次读取的结果多了新的数据
不可重复读和幻读的区别
不可重复读的重点是内容修改或者记录减少比如多次读取一条记录发现其中某些记录的值被修改;
幻读的重点在于记录新增比如多次执行同一条查询语句(DQL)时,发现查到的记录增加了。
幻读其实可以看作是不可重复读的一种特殊情况,单独把幻读区分出来的原因主要是解决幻读和不可重复读的方案不一样。
举个例子:执行 delete 和 update 操作的时候,可以直接对记录加锁,保证事务安全。而执行 insert 操作的时候,由于记录锁(Record Lock)只能锁住已经存在的记录,为了避免插入新记录,需要依赖间隙锁(Gap Lock)。也就是说执行 insert 操作的时候需要依赖 Next-Key Lock(Record Lock+Gap Lock) 进行加锁来保证不出现幻读。
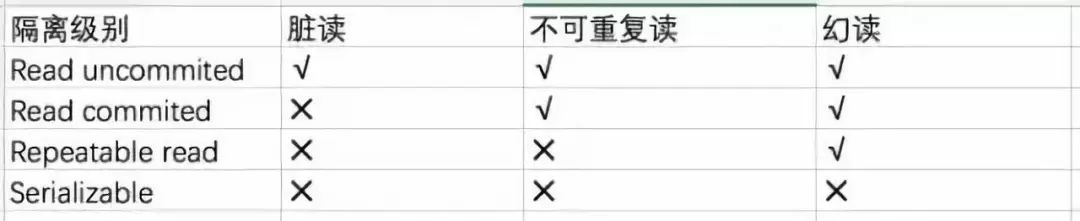
测试Mysql的隔离级别
下面,将利用MySQL的客户端程序,我们分别来测试一下这几种隔离级别。
测试数据库为demo,表为test;表结构
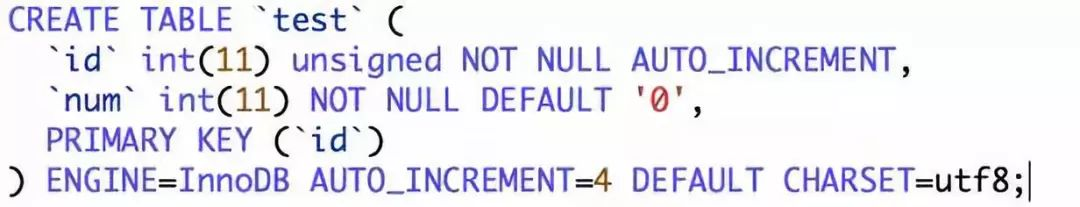
两个命令行客户端分别为A,B;不断改变A的隔离级别,在B端修改数据。
1.将A的隔离级别设置为read uncommitted(未提交读)
A:启动事务,此时数据为初始状态

B:启动事务,更新数据,但不提交
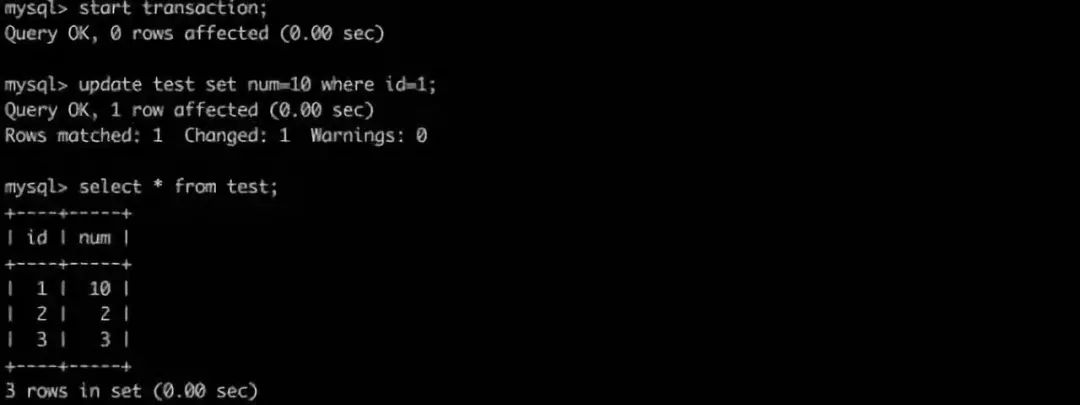
A:再次读取数据,发现数据已经被修改了,这就是所谓的“脏读”

B:回滚事务
A:再次读数据,发现数据变回初始状态

经过上面的实验可以得出结论,事务B更新了一条记录,但是没有提交,此时事务A可以查询出未提交记录。造成脏读现象。未提交读是最低的隔离级别。
2.将客户端A的事务隔离级别设置为read committed(已提交读)
A:启动事务,此时数据为初始状态

B:启动事务,更新数据,但不提交
A:再次读数据,发现数据未被修改

B:提交事务
A:再次读取数据,发现数据已发生变化,说明B提交的修改被事务中的A读到了,这就是所谓的“不可重复读”

经过上面的实验可以得出结论,已提交读隔离级别解决了脏读的问题,但是出现了不可重复读的问题,即事务A在两次查询的数据不一致,因为在两次查询之间事务B更新了一条数据。已提交读只允许读取已提交的记录,但不要求可重复读。
3.将A的隔离级别设置为repeatable read(可重复读)
A:启动事务,此时数据为初始状态

B:启动事务,更新数据,但不提交

A:再次读取数据,发现数据未被修改
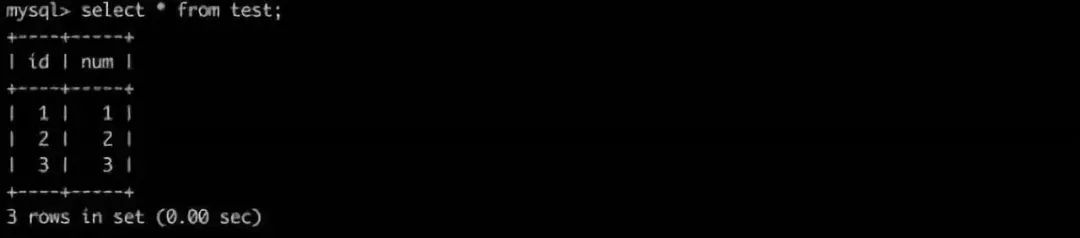
B:提交事务
A:再次读取数据,发现数据依然未发生变化,这说明这次可以重复读了
B:插入一条新的数据,并提交

A:再次读取数据,发现数据依然未发生变化,虽然可以重复读了,但是却发现读的不是最新数据,这就是所谓的“幻读”
A:提交本次事务,再次读取数据,发现读取正常了

由以上的实验可以得出结论,可重复读隔离级别只允许读取已提交记录,而且在一个事务两次读取一个记录期间,其他事务部的更新该记录。但该事务不要求与其他事务可串行化。例如,当一个事务可以找到由一个已提交事务更新的记录,但是可能产生幻读问题(注意是可能,因为数据库对隔离级别的实现有所差别)。像以上的实验,就没有出现数据幻读的问题。
隔离级别适用的场景
READ UNCOMMITTED(读取未提交内容):
- 适用场景:很少使用,一般不建议使用。主要用于测试目的或特殊需求。
READ COMMITTED(读取已提交内容):
- 适用场景:大部分情况下的默认隔离级别,适用于大多数应用。
REPEATABLE READ(可重复读):
- 适用场景:对数据的一致性要求较高的应用,例如银行、支付等。
SERIALIZABLE(串行化):
- 适用场景:对数据的一致性要求非常高,且并发性要求较低的应用。
联合索引的使用
InnoDB引擎对比其它引擎的优势?
区别
1. InnoDB支持事务,MyISAM不支持,对于InnoDB每一条SQL语言都默认封装成事务,自动提交,这样会影响速度,所以最好把多条SQL语言放在begin和commit之间,组成一个事务;
2. InnoDB支持外键,而MyISAM不支持。对一个包含外键的InnoDB表转为MYISAM会失败;
3.InnoDB是聚集索引,使用B+Tree作为索引结构,数据文件是和(主键)索引绑在一起的(表数据文件本身就是按B+Tree组织的一个索引结构),必须要有主键,通过主键索引效率很高。但是辅助索引需要两次查询,先查询到主键,然后再通过主键查询到数据。因此,主键不应该过大,因为主键太大,其他索引也都会很大。
MyISAM是非聚集索引,也是使用B+Tree作为索引结构,索引和数据文件是分离的,索引保存的是数据文件的指针。主键索引和辅助索引是独立的。
也就是说:InnoDB的B+树主键索引的叶子节点就是数据文件,辅助索引的叶子节点是主键的值;而MyISAM的B+树主键索引和辅助索引的叶子节点都是数据文件的地址指针。
4. InnoDB支持表、行(默认)级锁,而MyISAM支持表级锁
InnoDB的行锁是实现在索引上的,而不是锁在物理行记录上。潜台词是,如果访问没有命中索引,也无法使用行锁,将要退化为表锁。
- InnoDB:支持崩溃恢复。它有 Redo Log(重做日志)。即使数据库突然断电,重启后也能根据 Redo Log 把还没刷入磁盘的数据恢复回来。
- MyISAM:不支持。突然断电可能导致数据文件损坏,且极难恢复。
5、InnoDB表必须有唯一索引(如主键)(用户没有指定的话会自己找/生产一个隐藏列Row_id来充当默认主键),而Myisam可以没有
选择
1. 是否要支持事务,如果要请选择innodb,如果不需要可以考虑MyISAM;
2. 如果表中绝大多数都只是读查询,可以考虑MyISAM,如果既有读也有写,请使用InnoDB。
SQL语句执行顺序(SQL语法基础-SQL查询语句的执行顺序解析_sql语法结构顺序查询-CSDN博客)
事务在什么情况下会失效(spring 事务失效的 12 种场景_spring 截获duplicatekeyexception 不抛异常-CSDN博客)
MYSQL事务ACID(深入学习MySQL事务:ACID特性的实现原理 - 编程迷思 - 博客园)
聚簇索引和非聚簇索引的区别是什么?
1.数据存储方式:
- 聚簇索引:表数据按照索引的顺序来存储。即索引的叶子节点包含了完整的数据行。
- 非聚簇索引:索引和数据是分开存储的,索引的叶子节点存储的是指向数据行的指针。
2.主键与索引关系:
- 聚簇索引默认是主键,如果表中没有定义主键,InnoDB 会选择一个唯一的非空索引代替。如果没有这样的索引,InnoDB 会隐式定义一个主键来作为聚簇索引。InnoDB 只聚集在同一个页面中的记录。包含相邻键值的页面可能相距甚远。如果你已经设置了主键为聚簇索引,必须先删除主键,然后添加我们想要的聚簇索引,最后恢复设置主键即可。
- 非聚簇索引可以在表的任何列上创建,不限于主键。
3.数据查找效率:
- 对于主键的查询,聚簇索引查找速度更快,因为直接可以获取到数据。
- 非聚簇索引需要先通过索引找到指针,再根据指针去查找数据,多了一次查找过程。
二级索引为何存主键id不存数据的地址
InnoDB 采用的是 索引组织表(Index-Organized Table, IOT),其 主键索引(聚簇索引,Clustered Index) 直接存储整行数据,而二级索引仅存储索引列值 + 主键 ID,而不是数据的物理地址。因为数据的物理地址可能会变化,B+数可能高度会不断的变化,可能会有一些节点的分裂,合并之类的,数据可能会移动到新的位置。
mysql的索引的建立选择和依据,你去建立索引要考量的因素有哪些
(1) 适合建立索引的情况
- 高选择性字段:区分度高的列(如用户ID、手机号)
- 频繁作为查询条件的列:WHERE 子句中经常出现的列
- 排序和分组字段:ORDER BY、GROUP BY 涉及的列
- 连接查询的关联字段:JOIN 操作中的外键
- 覆盖索引场景:查询只需要通过索引就能获取全部数据
(2) 不适合建立索引的情况
- 数据量小的表(<1000行)
- 频繁更新的列(会带来额外的维护开销)
- 区分度低的列(如性别、状态标志)
- 很少用于查询的列
- 大文本字段(如 TEXT、BLOB)
为什么有了全量更新+增量更新之后还需要双写数据库呢
MYSQL多少层
mvcc,Mvcc的性能优势,性能瓶颈(MVCC详解,深入浅出简单易懂-CSDN博客)
优势
- Mvcc主要解决读写问题,Mvcc 是基于快照读,读操作不加锁,读请求不会因为写锁而被阻塞,提升了并发处理能力,当前读是指读取记录的最新版本。在读取时,为了确保其他并发事务无法修改该记录,系统会对它加锁。
劣势
- Undo log占用大量的磁盘,影响查询性能
- 每次
UPDATE都会创建一个新版本,并记录到 Undo Log,导致磁盘 IO 增加 - 当 Undo Log 过多时,查询会变慢,影响大表查询性能。
构建索引,你会怎么考虑,联合索引怎么设计?(深入理解MySQL索引设计和优化原则_mysql 采取那个索引key的原则-CSDN博客)
索引的设计我一般会从几个角度来考虑:
第一是字段的使用频率,比如是否经常出现在
WHERE、JOIN或ORDER BY中;第二是区分度高不高,比如像手机号、订单号这样的字段很适合做索引;
第三是用联合索引代替多个单列索引,并且要遵循最左前缀原则,合理控制索引的数量,避免冗余。
实际中我也会结合 SQL 慢查询日志来定位索引缺失的问题,并用
EXPLAIN分析执行计划优化查询。
联合索引设计
联合索引我会根据实际业务的查询频率来设计,一般遵循“最左前缀”原则,并优先把区分度高的字段放在前面,能最大限度提升查询效率。
比如在订单系统中,我们常查 user_id + status + 时间,我就会建联合索引 (user_id, status, create_time)。
另外我也会注意不要把更新频繁的字段放前面,防止写入性能下降。
事务的传播行为
MySQL死锁排查步骤?(查日志-分析-)
死锁是指两个或多个事务在同一资源上相互占用,并请求对方锁定的资源,从而导致循环等待。
1. 第一现场:查看死锁日志
当死锁发生时,MySQL 会自动检测并终止其中一个事务。你需要立刻查看最近一次的死锁信息:
codeSQL
1 | |
在输出结果的 LATEST DETECTED DEADLOCK 部分,你会看到:
- TRANSACTIONS:涉及死锁的两个事务的具体 SQL。
- WAITING FOR THIS LOCK TO BE GRANTED:事务正在等待的锁类型(如 X lock,gap 锁等)。
- WE ROLL BACK TRANSACTION:MySQL 牺牲掉的那个事务。
2. 分析思路
- 对比 SQL:观察两个事务的执行顺序。例如:事务 A 先锁 ID=1 后请求 ID=2,而事务 B 先锁 ID=2 后请求 ID=1。这就是典型的“交叉加锁”。
- 检查索引:如果 SQL 没走索引,InnoDB 可能会扫描全表并锁定所有扫描到的行(或间隙)。这会成倍增加死锁概率。
- 查看隔离级别:REPEATABLE READ (RR) 隔离级别下,锁的范围更广,更容易产生死锁。
3. 预防与优化策略
- 调整加锁顺序:确保所有业务逻辑对多个资源的访问顺序一致。
- 缩小锁范围:尽量使用主键或唯一索引更新,减少锁定范围。
- 减少事务耗时:事务中包含非数据库操作(如 RPC 调用)会拉长锁等待时间,增加死锁概率。
- 优化索引:避免全表扫描(会导致锁表)。
MySQL有哪些锁?, MySQL 加锁语句是什么?
1.表级锁与行级锁
MyISAM 仅仅支持表级锁(table-level locking),一锁就锁整张表,这在并发写的情况下性非常差。InnoDB 不光支持表级锁(table-level locking),还支持行级锁(row-level locking),默认为行级锁。
行级锁的粒度更小,仅对相关的记录上锁即可(对一行或者多行记录加锁),所以对于并发写入操作来说, InnoDB 的性能更高。
表级锁和行级锁对比:
表级锁: MySQL 中锁定粒度最大的一种锁(全局锁除外),是针对非索引字段加的锁,对当前操作的整张表加锁,实现简单,资源消耗也比较少,加锁快,不会出现死锁。不过,触发锁冲突的概率最高,高并发下效率极低。表级锁和存储引擎无关,MyISAM 和 InnoDB 引擎都支持表级锁。
行级锁: MySQL 中锁定粒度最小的一种锁,是 针对索引字段加的锁 ,只针对当前操作的行记录进行加锁。 行级锁能大大减少数据库操作的冲突。其加锁粒度最小,并发度高,但加锁的开销也最大,加锁慢,会出现死锁。行级锁和存储引擎有关,是在存储引擎层面实现的,行锁是加在索引上的,如果当你的查询语句不走索引的话,那么它就会升级到表锁,最终造成效率低下,所以在写SQL语句时需要特别注意。
死锁:
死锁(Deadlock)是指 两个事务相互持有对方需要的锁,导致无限等待,最终 MySQL 会主动终止其中一个事务。
1
2
3
4
5
6
7
8
9
-- 事务 A
START TRANSACTION;
UPDATE users SET name = 'Alice' WHERE id = 1; -- 持有 id=1 的行锁
UPDATE users SET name = 'Bob' WHERE id = 2; -- 等待事务 B 释放 id=2 的锁
-- 事务 B
START TRANSACTION;
UPDATE users SET name = 'Charlie' WHERE id = 2; -- 持有 id=2 的行锁
UPDATE users SET name = 'David' WHERE id = 1; -- 等待事务 A 释放 id=1 的锁 (死锁发生)MySQL 发现死锁后,回滚其中一个事务:
行级锁的注意条件
InnoDB 的行锁是针对索引字段加的锁,表级锁是针对非索引字段加的锁。当我们执行 UPDATE、DELETE 语句时,如果 WHERE条件中字段没有命中唯一索引或者索引失效的话,就会导致扫描全表对表中的所有行记录进行加锁。这个在我们日常工作开发中经常会遇到,一定要多多注意!!
InnoDb有哪几类行锁
InnoDB 行锁是通过对索引数据页上的记录加锁实现的,MySQL InnoDB 支持三种行锁定方式:
记录锁(Record Lock):属于单个行记录上的锁。
间隙锁(Gap Lock):锁定一个范围,不包括记录本身。
临键锁(Next-Key Lock):Record Lock+Gap Lock,锁定一个范围,包含记录本身,主要目的是为了解决幻读问题(MySQL 事务部分提到过)。记录锁只能锁住已经存在的记录,为了避免插入新记录,需要依赖间隙锁。,临键锁只与非唯一索引列有关,在唯一索引列(包括主键列)上不存在临键锁。
- InnoDB 中的 行锁 的实现依赖于 索引,一旦某个加锁操作没有使用到索引,那么该锁就会退化为表锁。
- 记录锁 存在于包括 主键索引 在内的 唯一索引 中,锁定单条索引记录。
- 间隙锁 存在于 非唯一索引 中,锁定开区间范围内的一段间隔,它是基于 临键锁 实现的。
- 临键锁 存在于 非唯一索引 中,该类型的每条记录的索引上都存在这种锁,它是 一种特殊的间隙锁,锁定一段 左开右闭 的索引区间。
在 InnoDB 默认的隔离级别 REPEATABLE-READ 下,行锁默认使用的是 Next-Key Lock。但是,如果操作的索引是唯一索引或主键,InnoDB 会对 Next-Key Lock 进行优化,将其降级为 Record Lock,即仅锁住索引本身,而不是范围。
间隙锁锁住的时候还可以读吗?间隙锁可能会造成死锁吗?如果锁住很大范围的间隙,怎么解决性能上的问题?怎么解决间隙锁之间的锁冲突?
Mysql的日志系统,如果进行了insert,在MySQL中三个log的写入顺序
1.redo log
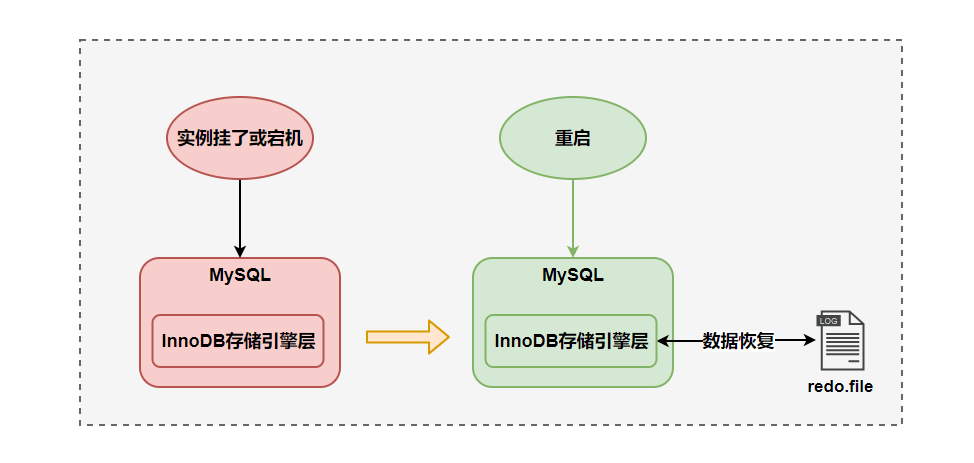
redo log(重做日志)是 InnoDB 存储引擎独有的,它让 MySQL 拥有了崩溃恢复能力。
比如 MySQL 实例挂了或宕机了,重启时,InnoDB 存储引擎会使用 redo log 恢复数据,保证数据的持久性与完整性。
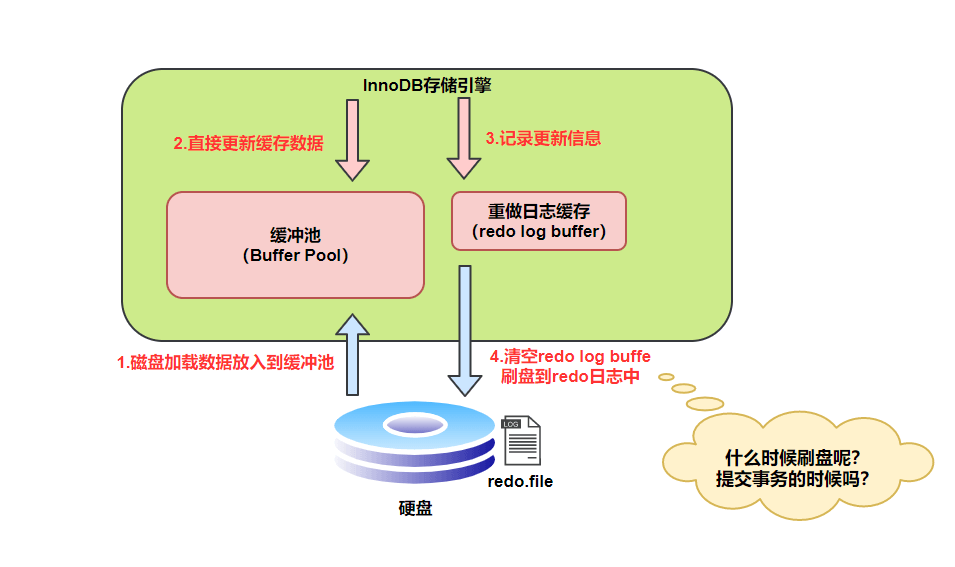
MySQL 中数据是以页为单位,你查询一条记录,会从硬盘把一页的数据加载出来,加载出来的数据叫数据页,会放入到 Buffer Pool 中。
后续的查询都是先从 Buffer Pool 中找,没有命中再去硬盘加载,减少硬盘 IO 开销,提升性能。
更新表数据的时候,也是如此,发现 Buffer Pool 里存在要更新的数据,就直接在 Buffer Pool 里更新。
然后会把“在某个数据页上做了什么修改”记录到重做日志缓存(redo log buffer)里,接着刷盘到 redo log 文件里。
刷盘的时机
InnoDB 将 redo log 刷到磁盘上有几种情况:
- 事务提交:当事务提交时,log buffer 里的 redo log 会被刷新到磁盘(可以通过
innodb_flush_log_at_trx_commit参数控制,后文会提到)。 - log buffer 空间不足时:log buffer 中缓存的 redo log 已经占满了 log buffer 总容量的大约一半左右,就需要把这些日志刷新到磁盘上。
- 事务日志缓冲区满:InnoDB 使用一个事务日志缓冲区(transaction log buffer)来暂时存储事务的重做日志条目。当缓冲区满时,会触发日志的刷新,将日志写入磁盘。
- Checkpoint(检查点):InnoDB 定期会执行检查点操作,将内存中的脏数据(已修改但尚未写入磁盘的数据)刷新到磁盘,并且会将相应的重做日志一同刷新,以确保数据的一致性。
- 后台刷新线程:InnoDB 启动了一个后台线程,负责周期性(每隔 1 秒)地将脏页(已修改但尚未写入磁盘的数据页)刷新到磁盘,并将相关的重做日志一同刷新。
- 正常关闭服务器:MySQL 关闭的时候,redo log 都会刷入到磁盘里去。
总之,InnoDB 在多种情况下会刷新重做日志,以保证数据的持久性和一致性。
我们要注意设置正确的刷盘策略innodb_flush_log_at_trx_commit 。根据 MySQL 配置的刷盘策略的不同,MySQL 宕机之后可能会存在轻微的数据丢失问题。
innodb_flush_log_at_trx_commit 的值有 3 种,也就是共有 3 种刷盘策略:
0:设置为 0 的时候,表示每次事务提交时不进行刷盘操作。这种方式性能最高,但是也最不安全,因为如果 MySQL 挂了或宕机了,可能会丢失最近 1 秒内的事务。
1:设置为 1 的时候,表示每次事务提交时都将进行刷盘操作。这种方式性能最低,但是也最安全,因为只要事务提交成功,redo log 记录就一定在磁盘里,不会有任何数据丢失。
2:设置为 2 的时候,表示每次事务提交时都只把 log buffer 里的 redo log 内容写入 page cache(文件系统缓存)。page cache 是专门用来缓存文件的,这里被缓存的文件就是 redo log 文件。这种方式的性能和安全性都介于前两者中间。
刷盘策略innodb_flush_log_at_trx_commit 的默认值为 1,设置为 1 的时候才不会丢失任何数据。为了保证事务的持久性,我们必须将其设置为 1。
另外,InnoDB 存储引擎有一个后台线程,每隔1 秒,就会把 redo log buffer 中的内容写到文件系统缓存(page cache),然后调用 fsync 刷盘。
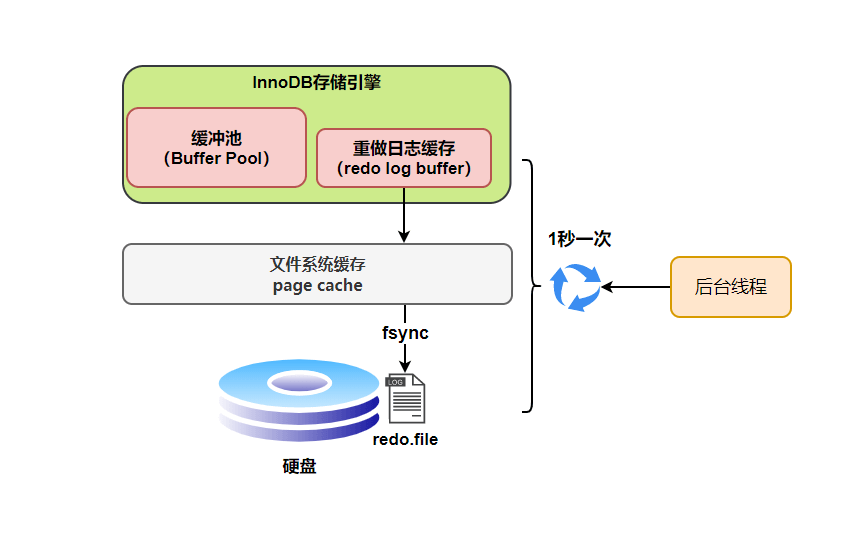
在事务执行过程 redo log 记录是会写入redo log buffer 中,这些 redo log 记录会被后台线程刷盘。

除了后台线程每秒1次的轮询操作,还有一种情况,当 redo log buffer 占用的空间即将达到 innodb_log_buffer_size 一半的时候,后台线程会主动刷盘。
下面是不同刷盘策略的流程图。
innodb_flush_log_at_trx_commit=0

为0时,如果 MySQL 挂了或宕机可能会有1秒数据的丢失。
innodb_flush_log_at_trx_commit=1
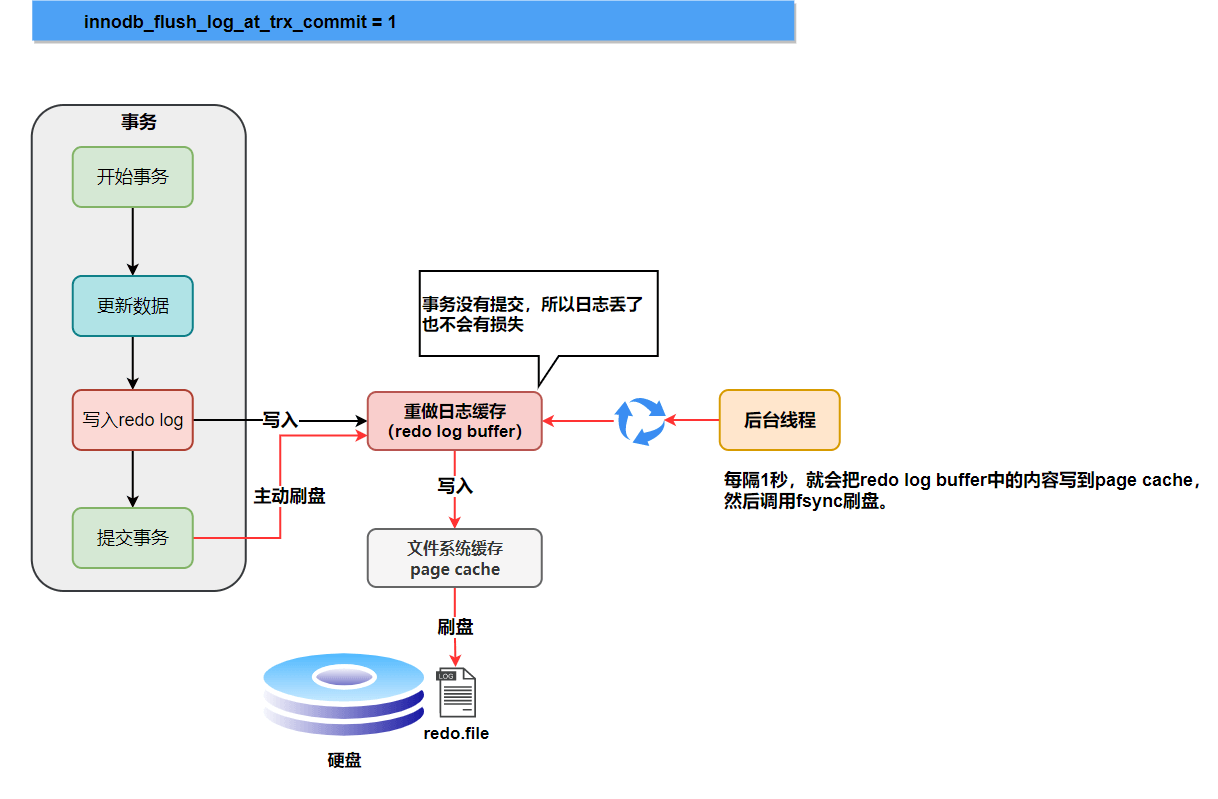
为1时, 只要事务提交成功,redo log 记录就一定在硬盘里,不会有任何数据丢失。
如果事务执行期间 MySQL 挂了或宕机,这部分日志丢了,但是事务并没有提交,所以日志丢了也不会有损失。
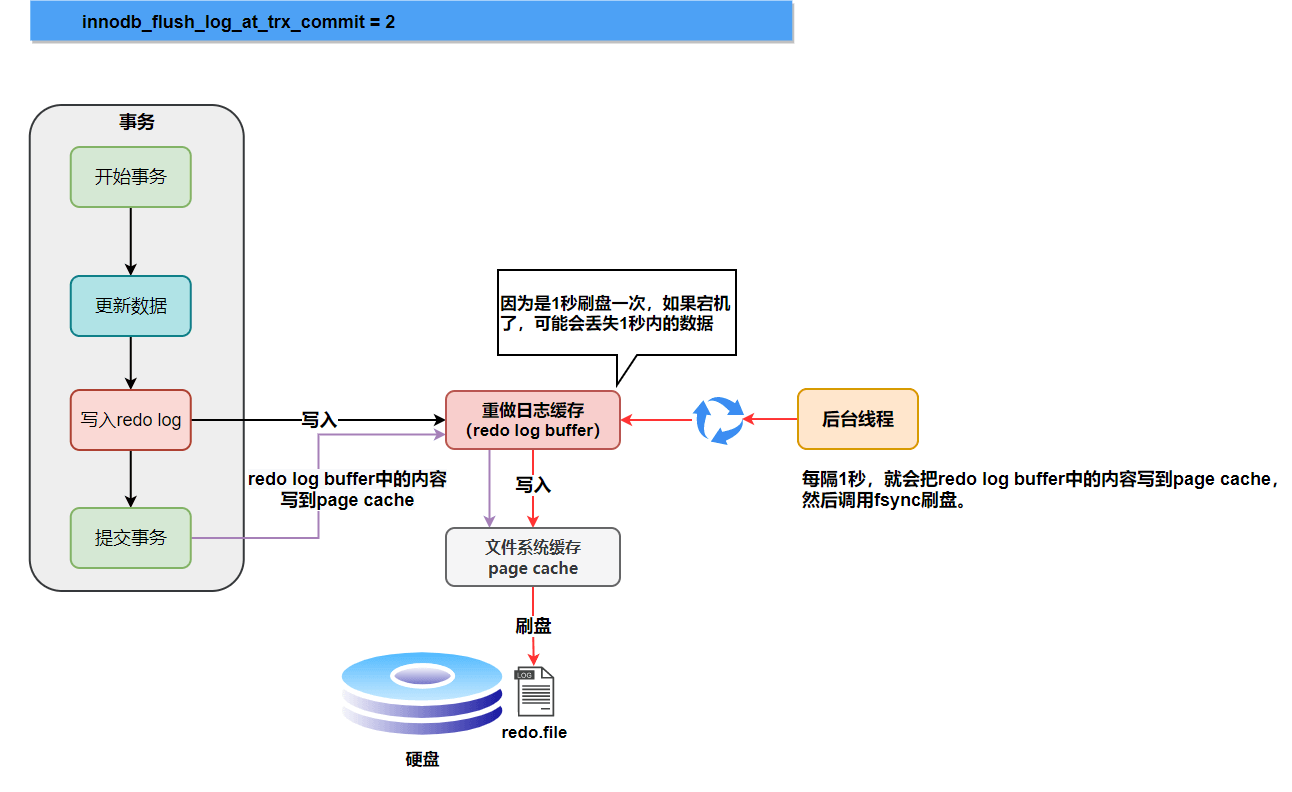
为2时, 只要事务提交成功,redo log buffer中的内容只写入文件系统缓存(page cache)。
如果仅仅只是 MySQL 挂了不会有任何数据丢失,但是宕机可能会有1秒数据的丢失。
redo log小结
现在我们来思考一个问题:只要每次把修改后的数据页直接刷盘不就好了,还有 redo log 什么事?
它们不都是刷盘么?差别在哪里?
实际上,数据页大小是16KB,刷盘比较耗时,可能就修改了数据页里的几 Byte 数据,有必要把完整的数据页刷盘吗?
而且数据页刷盘是随机写,因为一个数据页对应的位置可能在硬盘文件的随机位置,所以性能是很差。
如果是写 redo log,一行记录可能就占几十 Byte,只包含表空间号、数据页号、磁盘文件偏移
量、更新值,再加上是顺序写,所以刷盘速度很快。
所以用 redo log 形式记录修改内容,性能会远远超过刷数据页的方式,这也让数据库的并发能力更强。
2.binlog
redo log 它是物理日志,记录内容是“在某个数据页上做了什么修改”,属于 InnoDB 存储引擎。
binlog 是逻辑日志,记录内容是语句的原始逻辑,类似于“给 ID=2 这一行的 c 字段加 1”,属于MySQL Server 层。
不管用什么存储引擎,只要发生了表数据更新,都会产生 binlog 日志。
那 binlog 到底是用来干嘛的?
可以说 MySQL 数据库的数据备份、主备、主主、主从都离不开 binlog,需要依靠 binlog 来同步数据,保证数据一致性。
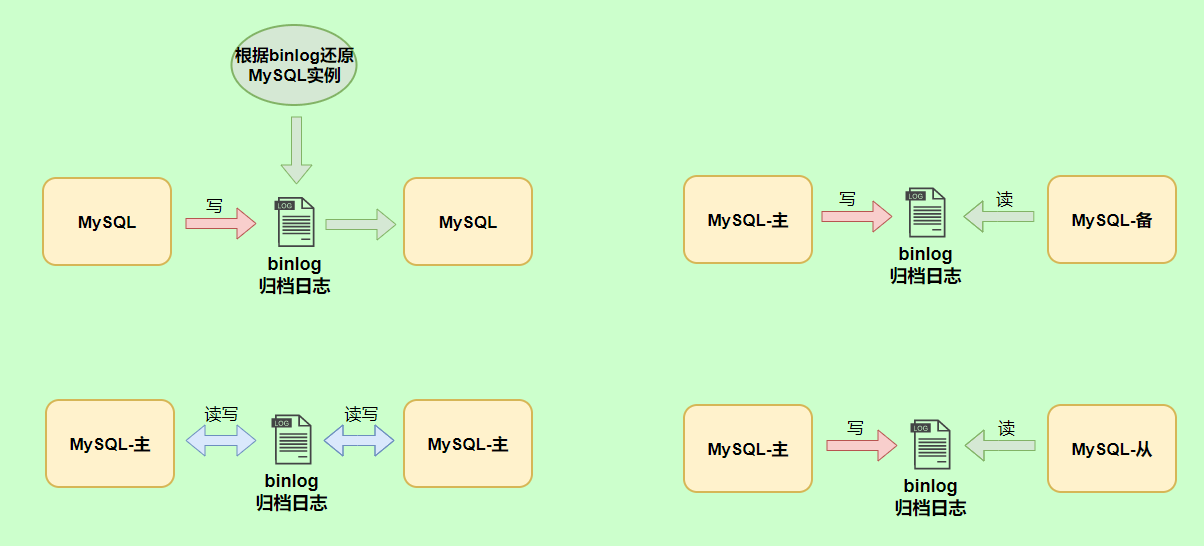
binlog 日志有三种格式,可以通过binlog_format参数指定。
- statement
- row
- mixed
指定statement,记录的内容是SQL语句原文,比如执行一条update T set update_time=now() where id=1,记录的内容如下。
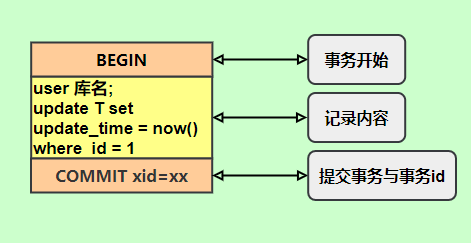
同步数据时,会执行记录的SQL语句,但是有个问题,update_time=now()这里会获取当前系统时间,直接执行会导致与原库的数据不一致。
为了解决这种问题,我们需要指定为row,记录的内容不再是简单的SQL语句了,还包含操作的具体数据,记录内容如下。
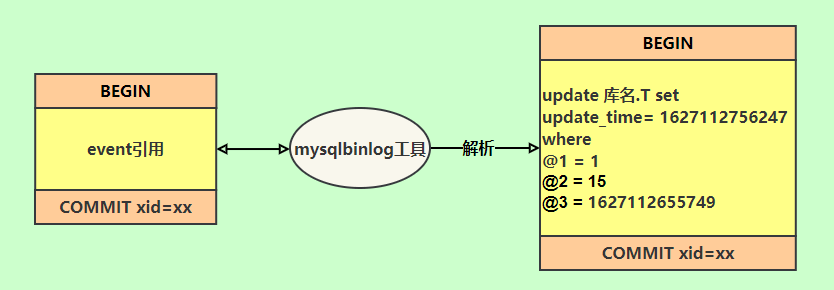
row格式记录的内容看不到详细信息,要通过mysqlbinlog工具解析出来。
update_time=now()变成了具体的时间update_time=1627112756247,条件后面的@1、@2、@3 都是该行数据第 1 个~3 个字段的原始值(假设这张表只有 3 个字段)。
这样就能保证同步数据的一致性,通常情况下都是指定为row,这样可以为数据库的恢复与同步带来更好的可靠性。
但是这种格式,需要更大的容量来记录,比较占用空间,恢复与同步时会更消耗 IO 资源,影响执行速度。
所以就有了一种折中的方案,指定为mixed,记录的内容是前两者的混合。
MySQL 会判断这条SQL语句是否可能引起数据不一致,如果是,就用row格式,否则就用statement格式
写入时机
binlog 的写入时机也非常简单,事务执行过程中,先把日志写到binlog cache,事务提交的时候,再把binlog cache写到 binlog 文件中。
因为一个事务的 binlog 不能被拆开,无论这个事务多大,也要确保一次性写入,所以系统会给每个线程分配一个块内存作为binlog cache。
我们可以通过binlog_cache_size参数控制单个线程 binlog cache 大小,如果存储内容超过了这个参数,就要暂存到磁盘(Swap)。
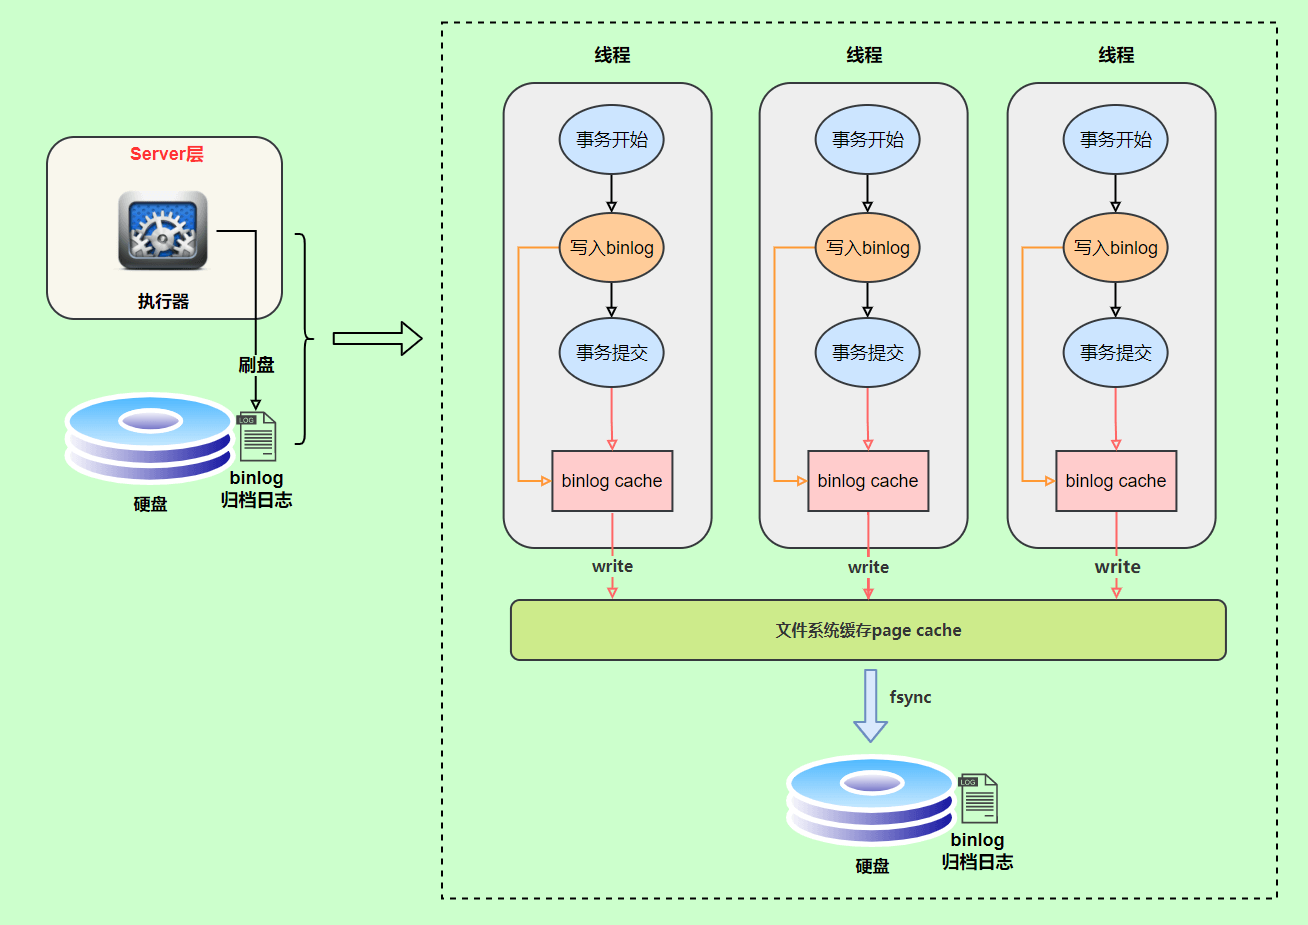
- 上图的 write,是指把日志写入到文件系统的 page cache,并没有把数据持久化到磁盘,所以速度比较快
- 上图的 fsync,才是将数据持久化到磁盘的操作
write和fsync的时机,可以由参数sync_binlog控制,默认是1。
为0的时候,表示每次提交事务都只write,由系统自行判断什么时候执行fsync。
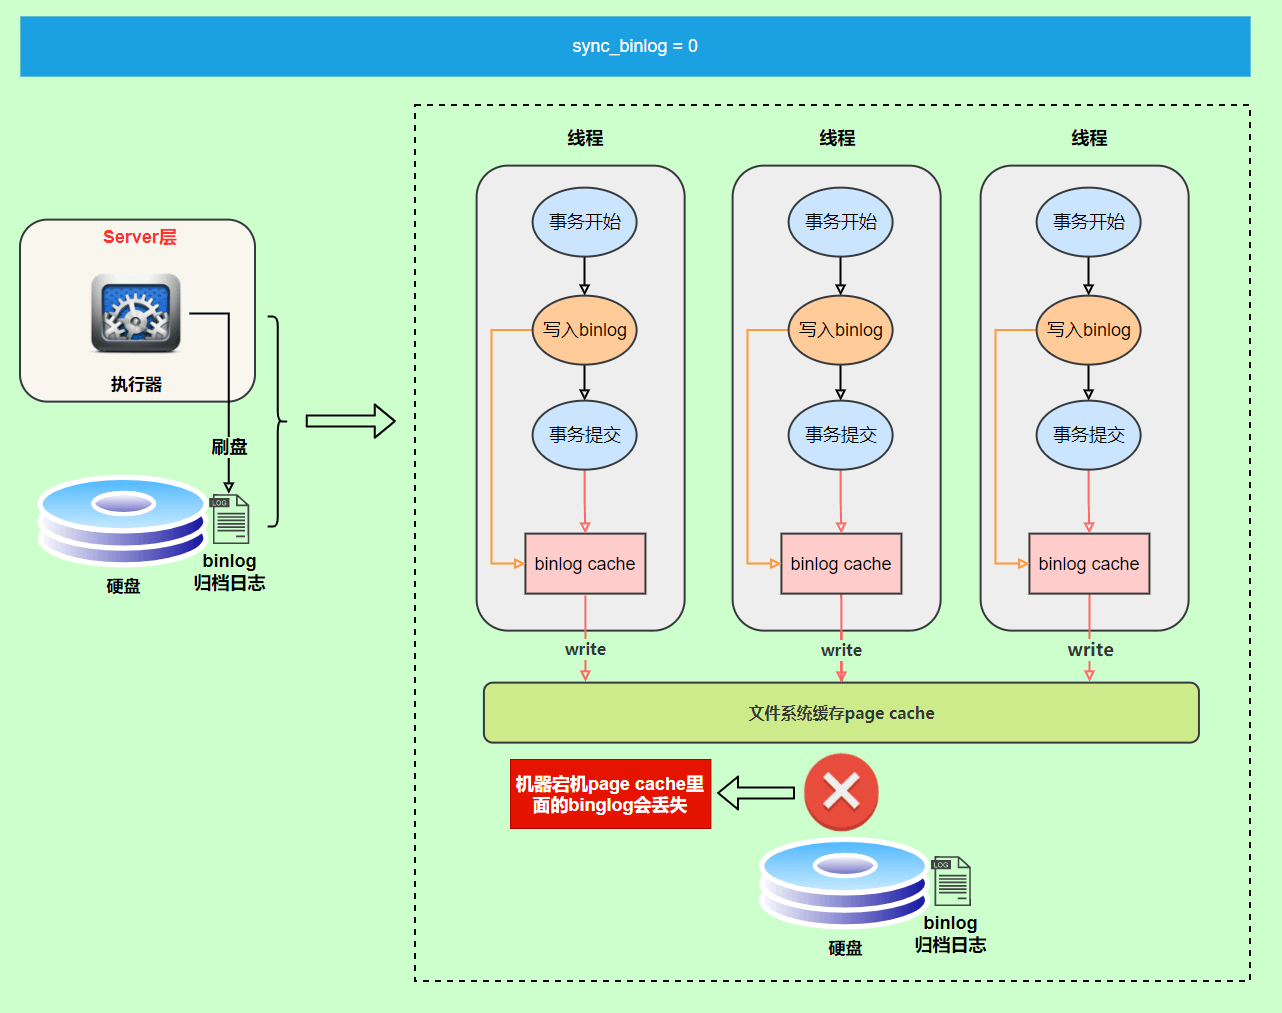
虽然性能得到提升,但是机器宕机,page cache里面的 binlog 会丢失。
为了安全起见,可以设置为1,表示每次提交事务都会执行fsync,就如同 redo log 日志刷盘流程 一样。
最后还有一种折中方式,可以设置为N(N>1),表示每次提交事务都write,但累积N个事务后才fsync。
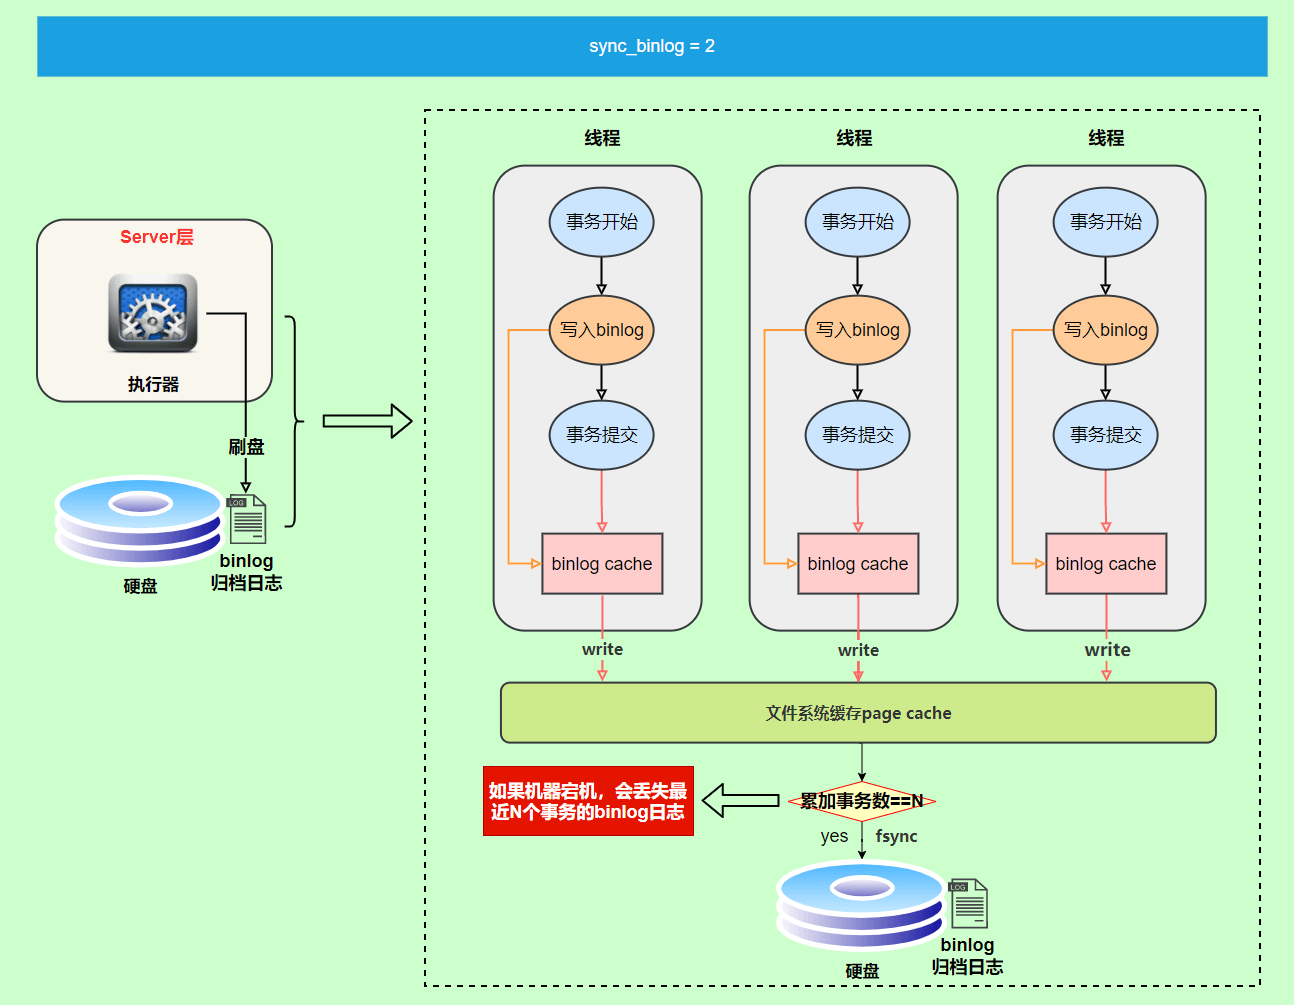
在出现 IO 瓶颈的场景里,将sync_binlog设置成一个比较大的值,可以提升性能。
同样的,如果机器宕机,会丢失最近N个事务的 binlog 日志。
3.两阶段提交
redo log(重做日志)让 InnoDB 存储引擎拥有了崩溃恢复能力。
binlog(归档日志)保证了 MySQL 集群架构的数据一致性。
虽然它们都属于持久化的保证,但是侧重点不同。
在执行更新语句过程,会记录 redo log 与 binlog 两块日志,以基本的事务为单位,redo log 在事务执行过程中可以不断写入,而 binlog 只有在提交事务时才写入,所以 redo log 与 binlog 的写入时机不一样。

回到正题,redo log 与 binlog 两份日志之间的逻辑不一致,会出现什么问题?
我们以update语句为例,假设id=2的记录,字段c值是0,把字段c值更新成1,SQL语句为update T set c=1 where id=2。
假设执行过程中写完 redo log 日志后,binlog 日志写期间发生了异常,会出现什么情况呢?
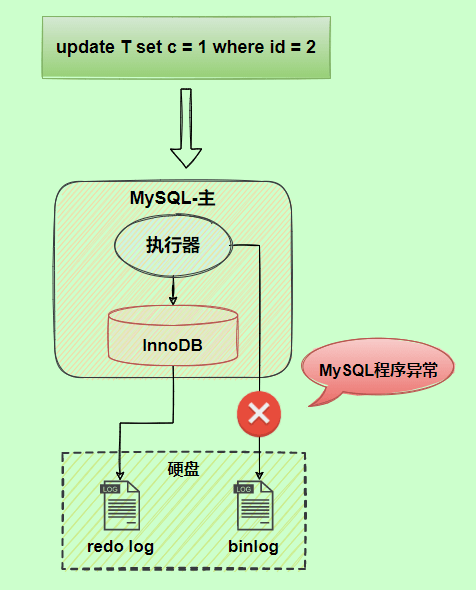
由于 binlog 没写完就异常,这时候 binlog 里面没有对应的修改记录。因此,之后用 binlog 日志恢复数据时,就会少这一次更新,恢复出来的这一行c值是0,而原库因为 redo log 日志恢复,这一行c值是1,最终数据不一致。
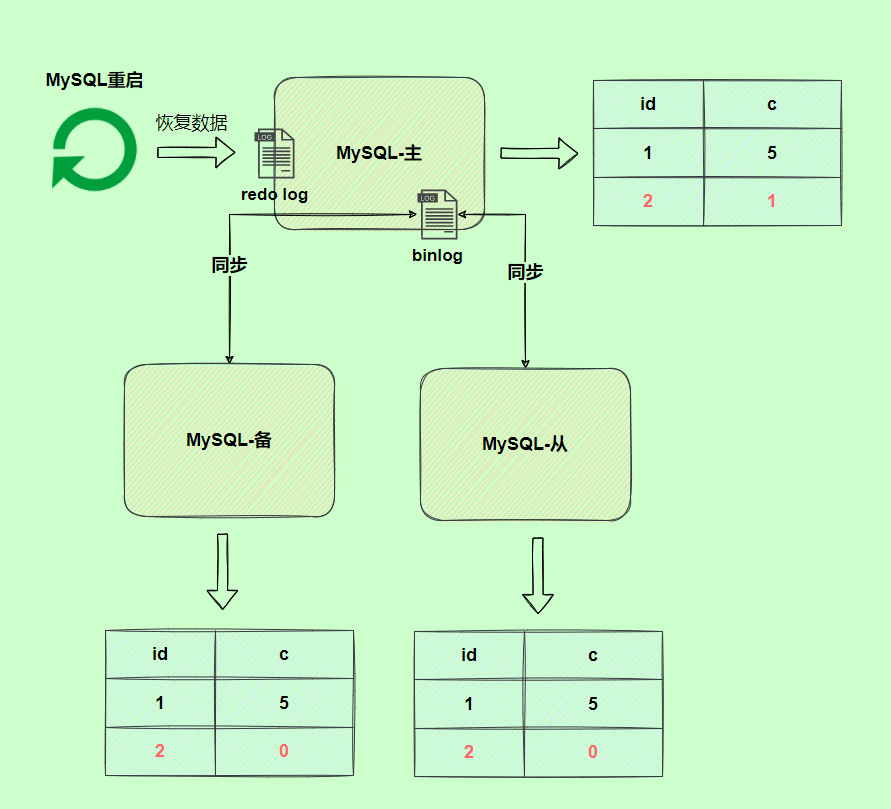
为了解决两份日志之间的逻辑一致问题,InnoDB 存储引擎使用两阶段提交方案。
原理很简单,将 redo log 的写入拆成了两个步骤prepare和commit,这就是两阶段提交。
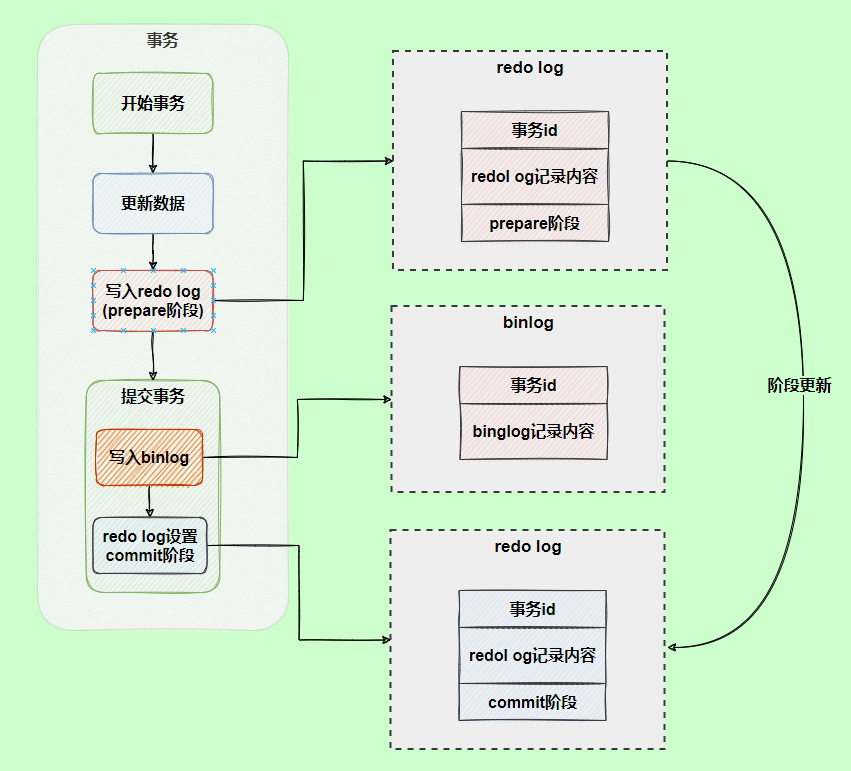
使用两阶段提交后,写入 binlog 时发生异常也不会有影响,因为 MySQL 根据 redo log 日志恢复数据时,发现 redo log 还处于prepare阶段,并且没有对应 binlog 日志,就会回滚该事务。
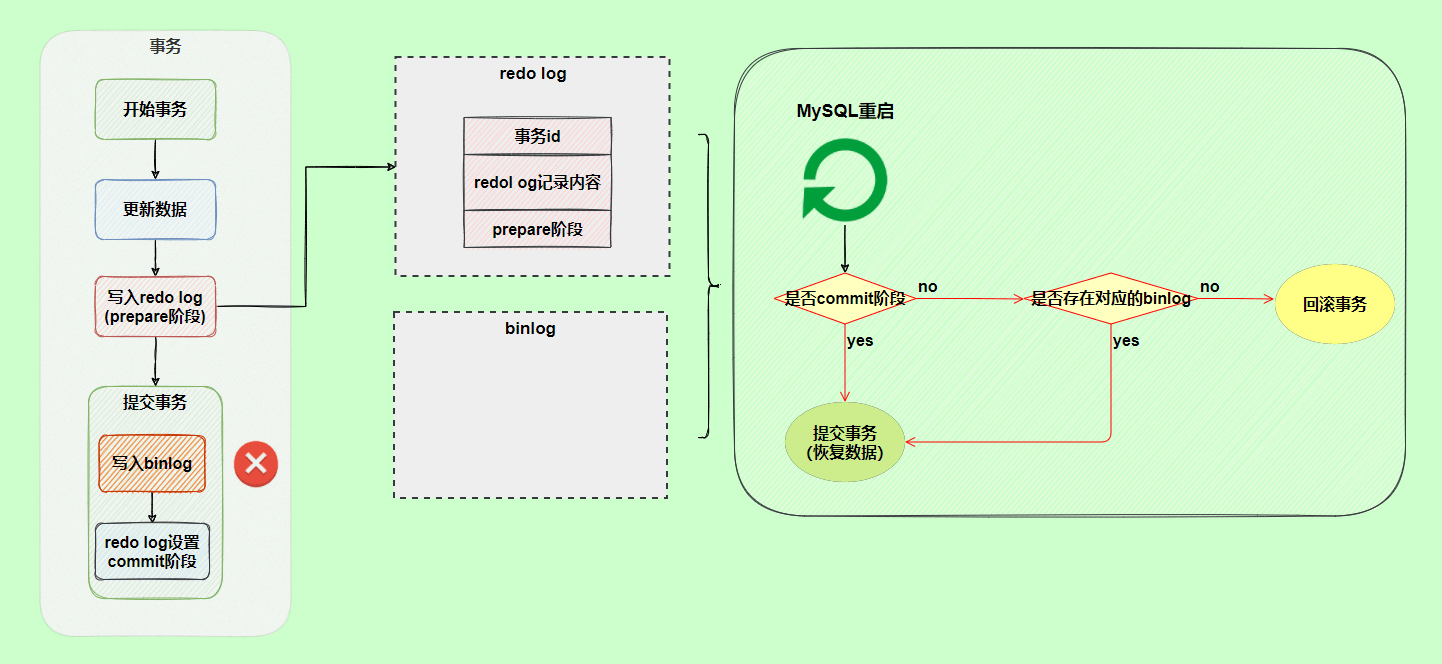
再看一个场景,redo log 设置commit阶段发生异常,那会不会回滚事务呢?
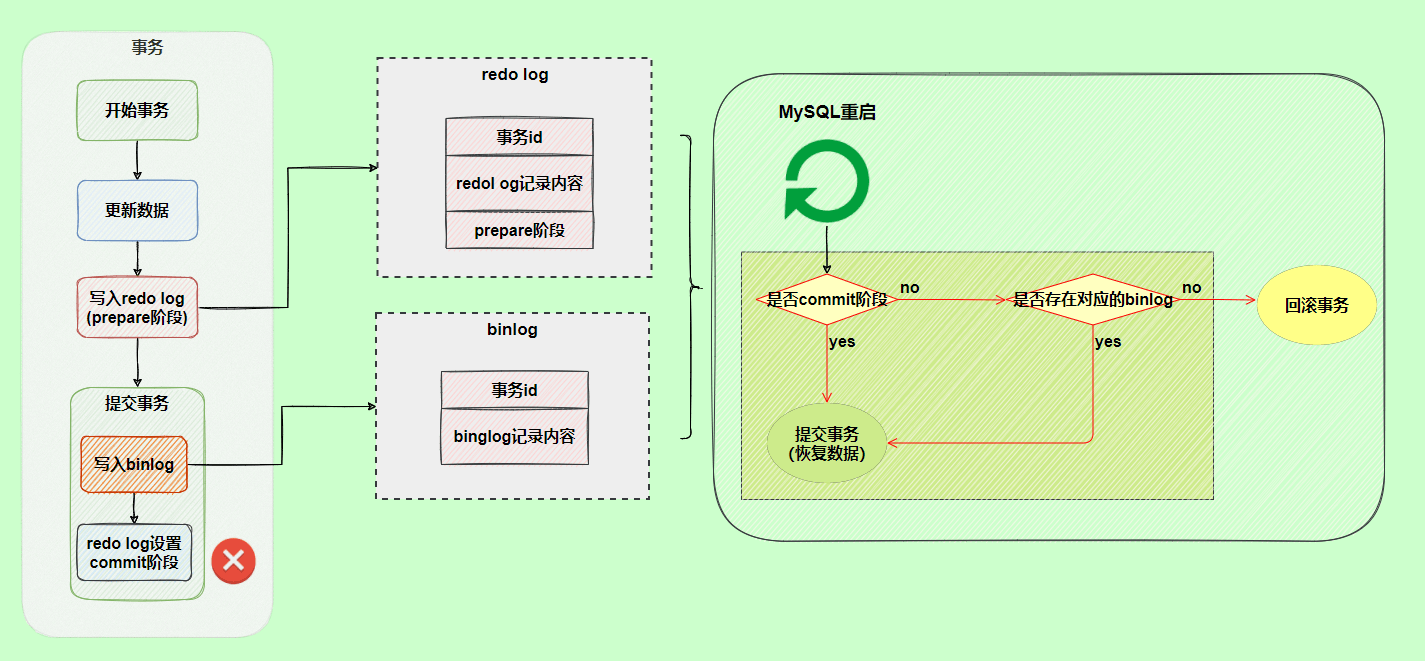
并不会回滚事务,它会执行上图框住的逻辑,虽然 redo log 是处于prepare阶段,但是能通过事务id找到对应的 binlog 日志,所以 MySQL 认为是完整的,就会提交事务恢复数据。
4.undo log
每一个事务对数据的修改都会被记录到 undo log ,当执行事务过程中出现错误或者需要执行回滚操作的话,MySQL 可以利用 undo log 将数据恢复到事务开始之前的状态。
每一个事务对数据的修改都会被记录到 undo log ,当执行事务过程中出现错误或者需要执行回滚操作的话,MySQL 可以利用 undo log 将数据恢复到事务开始之前的状态。
undo log 属于逻辑日志,记录的是 SQL 语句,比如说事务执行一条 DELETE 语句,那 undo log 就会记录一条相对应的 INSERT 语句。同时,undo log 的信息也会被记录到 redo log 中,因为 undo log 也要实现持久性保护。并且,undo-log 本身是会被删除清理的,例如 INSERT 操作,在事务提交之后就可以清除掉了;UPDATE/DELETE 操作在事务提交不会立即删除,会加入 history list,由后台线程 purge 进行清理。
数据库崩溃恢复的过程,详细点
分析阶段(Analysis Phase)
- 目标:确定哪些事务已经提交,哪些未提交。
- 执行:
- 扫描 Redo Log Header,找到最近一次
checkpoint。 - 从这个位置开始扫描 Redo Log。
- 建立活跃事务列表(active transaction list)。
- 扫描 Redo Log Header,找到最近一次
📝 Checkpoint:定期将脏页刷入磁盘,并标记 redo log 可回收点。
重做阶段(Redo Phase)
- 目标:对已提交事务的操作进行重放,保证事务持久性。
- 原理:WAL(Write-Ahead Logging):先写日志,再写数据页。
- 执行:
- 从 redo log 中找到所有 已提交事务。
- 检查这些事务的修改是否已写入磁盘(数据页)。
- 如果没写入,就重新执行日志中记录的操作(逻辑或物理重做)。
✅ 确保:“事务提交后即使宕机,数据也不会丢”
回滚阶段(Undo Phase)
- 目标:对未提交事务的操作进行回滚,保证原子性。
- 原理:
- 在事务执行过程中,InnoDB 会生成 Undo Log(保留旧值)。
- 如果事务中断(崩溃前未提交),通过 Undo Log 恢复原始值。
- 执行:
- 查找 活跃事务列表中未提交的事务。
- 依次读取对应的 Undo Log 并撤销变更。
✅ 确保:“中断事务完全不生效”
说说mysql的脏读可重复读幻读,怎么解决这些并发安全问题,mvcc的原理
mysql的数据写经历了哪些过程?
1.Mysql的基础架构
下图是 MySQL 的一个简要架构图,从下图你可以很清晰的看到用户的 SQL 语句在 MySQL 内部是如何执行的。
先简单介绍一下下图涉及的一些组件的基本作用帮助大家理解这幅图,在 1.2 节中会详细介绍到这些组件的作用。
- 连接器: 身份认证和权限相关(登录 MySQL 的时候)。
- 查询缓存: 执行查询语句的时候,会先查询缓存(MySQL 8.0 版本后移除,因为这个功能不太实用)。
- 分析器: 没有命中缓存的话,SQL 语句就会经过分析器,分析器说白了就是要先看你的 SQL 语句要干嘛,再检查你的 SQL 语句语法是否正确。
- 优化器: 按照 MySQL 认为最优的方案去执行。
- 执行器: 执行语句,然后从存储引擎返回数据。

简单来说 MySQL 主要分为 Server 层和存储引擎层:
Server 层:主要包括连接器、查询缓存、分析器、优化器、执行器等,所有跨存储引擎的功能都在这一层实现,比如存储过程、触发器、视图,函数等,还有一个通用的日志模块 binlog 日志模块。
存储引擎:主要负责数据的存储和读取,采用可以替换的插件式架构,支持 InnoDB、MyISAM、Memory 等多个存储引擎,其中 InnoDB 引擎有自有的日志模块 redolog 模块。**现在最常用的存储引擎是 InnoDB,它从 MySQL 5.5 版本开始就被当做默认存储引擎了。
2.Server层基本组件介绍
2.1连接器
连接器主要和身份认证和权限相关的功能相关,就好比一个级别很高的门卫一样。
主要负责用户登录数据库,进行用户的身份认证,包括校验账户密码,权限等操作,如果用户账户密码已通过,连接器会到权限表中查询该用户的所有权限,之后在这个连接里的权限逻辑判断都是会依赖此时读取到的权限数据,也就是说,后续只要这个连接不断开,即使管理员修改了该用户的权限,该用户也是不受影响的。
2.2查询缓存
查询缓存主要用来缓存我们所执行的 SELECT 语句以及该语句的结果集。
连接建立后,执行查询语句的时候,会先查询缓存,MySQL 会先校验这个 SQL 是否执行过,以 Key-Value 的形式缓存在内存中,Key 是查询语句,Value 是结果集。如果缓存 key 被命中,就会直接返回给客户端,如果没有命中,就会执行后续的操作,完成后也会把结果缓存起来,方便下一次调用。当然在真正执行缓存查询的时候还是会校验用户的权限,是否有该表的查询条件。
MySQL 查询不建议使用缓存,因为查询缓存失效在实际业务场景中可能会非常频繁,假如你对一个表更新的话,这个表上的所有的查询缓存都会被清空。对于不经常更新的数据来说,使用缓存还是可以的。
所以,一般在大多数情况下我们都是不推荐去使用查询缓存的。
MySQL 8.0 版本后删除了缓存的功能,官方也是认为该功能在实际的应用场景比较少,所以干脆直接删掉了
2.3分析器
MySQL 没有命中缓存,那么就会进入分析器,分析器主要是用来分析 SQL 语句是来干嘛的,分析器也会分为几步:
第一步,词法分析,一条 SQL 语句有多个字符串组成,首先要提取关键字,比如 select,提出查询的表,提出字段名,提出查询条件等等。做完这些操作后,就会进入第二步。
第二步,语法分析,主要就是判断你输入的 SQL 是否正确,是否符合 MySQL 的语法。
完成这 2 步之后,MySQL 就准备开始执行了,但是如何执行,怎么执行是最好的结果呢?这个时候就需要优化器上场了。
2.4优化器
优化器的作用就是它认为的最优的执行方案去执行(有时候可能也不是最优,这篇文章涉及对这部分知识的深入讲解),比如多个索引的时候该如何选择索引,多表查询的时候如何选择关联顺序等。
可以说,经过了优化器之后可以说这个语句具体该如何执行就已经定下
2.5执行器
当选择了执行方案后,MySQL 就准备开始执行了,首先执行前会校验该用户有没有权限,如果没有权限,就会返回错误信息,如果有权限,就会去调用引擎的接口,返回接口执行的结果。
3.语句分析
3.1查询语句
说了以上这么多,那么究竟一条 SQL 语句是如何执行的呢?其实我们的 SQL 可以分为两种,一种是查询,一种是更新(增加,修改,删除)。我们先分析下查询语句,语句如下:
1 | |
结合上面的说明,我们分析下这个语句的执行流程:
- 先检查该语句是否有权限,如果没有权限,直接返回错误信息,如果有权限,在 MySQL8.0 版本以前,会先查询缓存,以这条 SQL 语句为 key 在内存中查询是否有结果,如果有直接缓存,如果没有,执行下一步。
- 通过分析器进行词法分析,提取 SQL 语句的关键元素,比如提取上面这个语句是查询 select,提取需要查询的表名为 tb_student,需要查询所有的列,查询条件是这个表的 id=’1’。然后判断这个 SQL 语句是否有语法错误,比如关键词是否正确等等,如果检查没问题就执行下一步。
- 接下来就是优化器进行确定执行方案,上面的 SQL 语句,可以有两种执行方案:a.先查询学生表中姓名为“张三”的学生,然后判断是否年龄是 18。b.先找出学生中年龄 18 岁的学生,然后再查询姓名为“张三”的学生。那么优化器根据自己的优化算法进行选择执行效率最好的一个方案(优化器认为,有时候不一定最好)。那么确认了执行计划后就准备开始执行了。
- 进行权限校验,如果没有权限就会返回错误信息,如果有权限就会调用数据库引擎接口,返回引擎的执行结果
3.2更新语句
以上就是一条查询 SQL 的执行流程,那么接下来我们看看一条更新语句如何执行的呢?SQL 语句如下:
1 | |
我们来给张三修改下年龄,在实际数据库肯定不会设置年龄这个字段的,不然要被技术负责人打的。其实这条语句也基本上会沿着上一个查询的流程走,只不过执行更新的时候肯定要记录日志啦,这就会引入日志模块了,MySQL 自带的日志模块是 binlog(归档日志) ,所有的存储引擎都可以使用,我们常用的 InnoDB 引擎还自带了一个日志模块 redo log(重做日志),我们就以 InnoDB 模式下来探讨这个语句的执行流程。流程如下:
- 先查询到张三这一条数据,不会走查询缓存,因为更新语句会导致与该表相关的查询缓存失效。
- 然后拿到查询的语句,把 age 改为 19,然后调用引擎 API 接口,写入这一行数据,InnoDB 引擎把数据保存在内存中,同时记录 redo log,此时 redo log 进入 prepare 状态,然后告诉执行器,执行完成了,随时可以提交。
- 执行器收到通知后记录 binlog,然后调用引擎接口,提交 redo log 为提交状态。
- 更新完成。
mysql什么情况会出现死锁,是什么导致的死锁,如何解除死锁,mysql死锁怎么排查(数据库死锁:产生、解决及预防策略-CSDN博客)
mysql如何避免死锁((十)全解MySQL之死锁问题分析、事务隔离与锁机制的底层原理剖析MySQL事务隔离与锁机制是一个老生常谈的话题,但似乎 - 掘金)
MySQL 可重复读是如何实现的,ReadView 如何工作(MySQL 的可重复读到底是怎么实现的?图解 ReadView 机制 - 知乎)


mvcc,Mvcc的性能优势,性能瓶颈(MVCC详解,深入浅出简单易懂-CSDN博客)
优势
- Mvcc主要解决读写问题,Mvcc 是基于快照读,读操作不加锁,读请求不会因为写锁而被阻塞,提升了并发处理能力,当前读是指读取记录的最新版本。在读取时,为了确保其他并发事务无法修改该记录,系统会对它加锁。
劣势
- Undo log占用大量的磁盘,影响查询性能
- 每次
UPDATE都会创建一个新版本,并记录到 Undo Log,导致磁盘 IO 增加 - 当 Undo Log 过多时,查询会变慢,影响大表查询性能。
一条 update 语句,它在数据库底层的执行流程是怎么样的?越详细越好(一条Update语句的执行过程是怎样的?_牛客网)(MySQL(二)一条update更新语句的执行流程_mysql一条更新语句的执行流程-CSDN博客)
如果现在让你选择一个隔离级别,你会参考哪些条件去选择隔离级别?
- 极高一致性要求 (金融级):
- 业务场景:银行转账、支付、证券交易、库存扣减、订单创建等。
- 要求:数据绝对不能出错。不允许用户看到中间状态(脏读),不允许在一次业务操作中数据被其他事务修改(不可重复读),更不允许凭空多出或减少数据(幻读)。
- 隔离级别选择:可串行化 (Serializable)。这是最安全的级别,它强制所有事务串行执行,完全避免了所有并发问题。虽然性能最低,但在这种场景下,数据正确性压倒一切。
- 较高一致性要求 (核心业务):
- 业务场景:大部分核心的 CRUD (增删改查) 业务,如用户信息管理、订单状态流转、商品信息维护。
- 要求:需要避免脏读和不可重复读。在一个事务中,多次读取同一行数据,结果必须一致。对于幻读,根据业务容忍度,可能是可接受的,也可能是需要避免的。
- 隔离级别选择:可重复读 (Repeatable Read)。
- 这是 MySQL InnoDB 引擎的默认隔离级别。
- 它能有效防止脏读和不可重复读。
- 特别地,MySQL 的 RR 级别通过 Next-Key Lock 机制,在很大程度上解决了幻读问题,使其安全性接近于串行化,但并发性能远高于串行化。因此,对于绝大多数需要保证数据一致性的业务,MySQL 的可重复读是一个非常理想的“甜点级别”。
- 一般一致性要求 (允许短暂不一致):
- 业务场景:大部分“读多写少”的互联网应用,如新闻网站、博客、论坛的内容展示,非核心的用户信息查询。
- 要求:只要别读到“脏”数据(未提交的数据)就行。在一个事务内,如果数据被其他已提交的事务修改了,读到新数据是可以接受的。
- 隔离级别选择:读已提交 (Read Committed)。
- 这是 Oracle、PostgreSQL 等大多数数据库的默认隔离级别。
- 它能避免脏读,但允许不可重复读和幻读。
- 它的并发性能通常比可重复读要好,因为它产生的行锁和间隙锁更少,锁的持有时间也更短。
- 极低一致性要求 (性能优先):
- 业务场景:对数据一致性几乎没有要求的特殊场景,如统计报表的粗略计数、监控数据的采样等,其中性能是首要考虑因素。
- 要求:能读到就行,不关心数据是否是脏的、旧的。
- 隔离级别选择:读未提交 (Read Uncommitted)。
- 注意:这个级别在生产环境中几乎从不使用,因为它连最基本的脏读都无法避免,会带来严重的数据问题。
server层和引擎层的区别
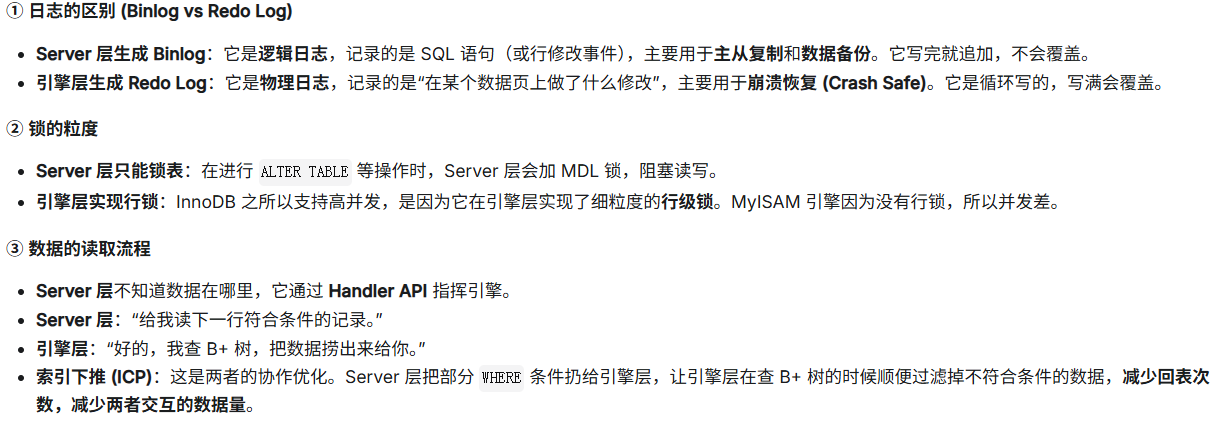
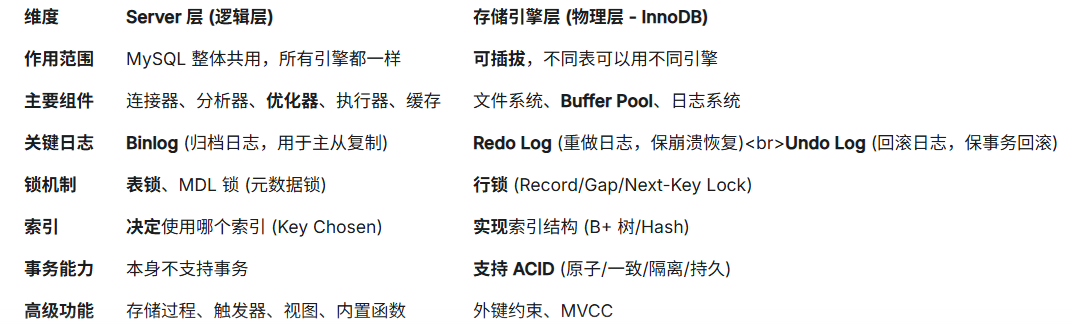
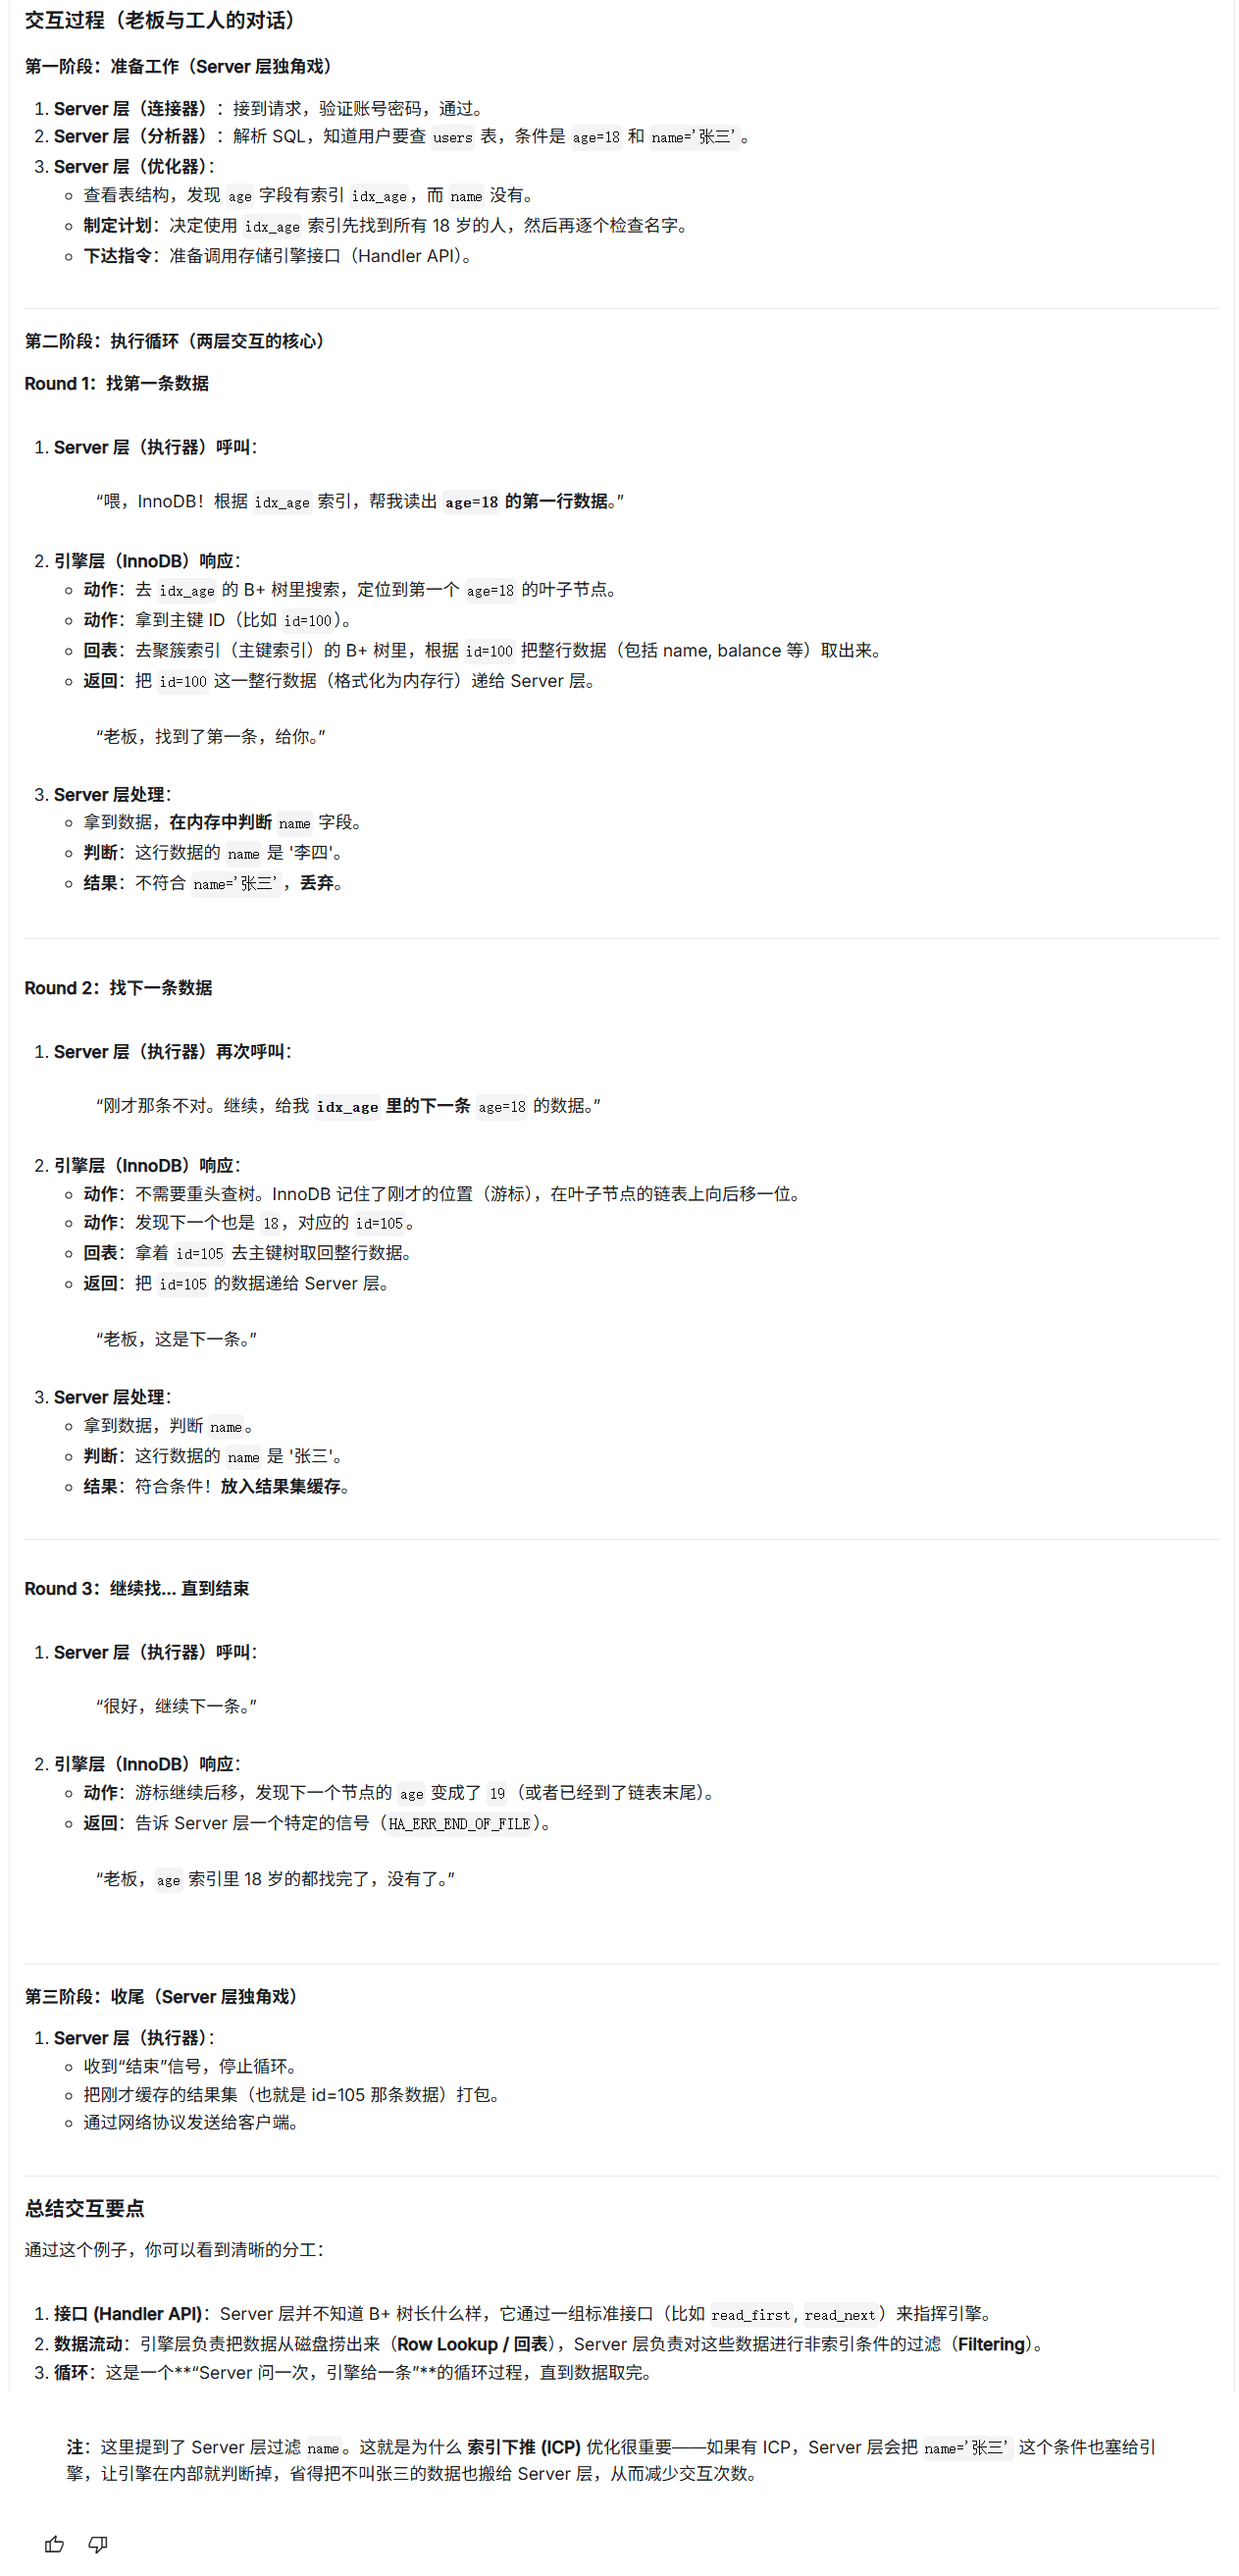
Buffer Pool有哪些区域,分别是是干什么的? Buffer Pool有什么机制能够保证不会因为一次大查询把所有的数据都替换掉
Buffer Pool 的底层虽然是基于 LRU(Least Recently Used,最近最少使用)链表管理的,但它不是一个简单的 LRU 链表。
为了解决 “预读失效” 和 “缓存污染” 的问题,InnoDB 将 LRU 链表拆分成了两个区域:
- Old 区(冷数据区)
- 位置:链表的尾部,大约占总大小的 37%(默认值,由 innodb_old_blocks_pct 控制)。
- 作用:存放刚从磁盘读取进来的数据页。
- 特点:这里的数据页也是 LRU 管理的,如果一直没被“再次访问”,就会被淘汰掉。
- Young 区(热数据区)
- 位置:链表的头部,大约占总大小的 63%。
- 作用:存放经常被访问的热点数据页。
- 特点:这里的数据页如果被访问,会被移动到链表的最头部,保证不被淘汰。
二、 为什么这么设计?(机制解析)
如果 Buffer Pool 只是一个普通的 LRU 链表(新数据直接放头部,满了淘汰尾部),会遇到两个严重问题:
问题 1:预读失效 (Read-Ahead Failure)
- 现象:MySQL 有预读机制。当你读第 1 页时,它觉得你可能马上要读第 2 页,就会顺便把第 2 页也加载进来。
- 后果:如果第 2 页加载进来直接放头部(Young 区),结果你压根没读它。那它就白白占了热点位置,还把真正的热数据挤出去了。
- 解决:新加载的数据,一律先放 Old 区头部。如果预读的数据没人用,它会很快从 Old 区尾部淘汰,不会影响 Young 区的热数据。
问题 2:缓存污染 (Buffer Pool Pollution) —— 也就是你的第二个问题
- 现象(全表扫描):你执行了一个 SELECT * FROM big_table(大查询,没有任何 where 条件)。这张表极其巨大,比 Buffer Pool 还大。
- 后果:
- 如果是普通 LRU:这几 GB 的数据会像洪水一样涌入 Buffer Pool,把所有之前的热点数据(比如用户表、订单表)全部冲刷掉。
- 导致接下来正常的业务请求全部无法命中缓存,数据库性能瞬间雪崩。
MySQL了解哪些锁?
维度一:按“锁的粒度”分(锁的范围多大?)
- 全局锁 (Global Lock)
- 作用:锁住整个数据库实例,只读不写。
- 场景:做全库逻辑备份(mysqldump)。命令:Flush tables with read lock。
- 表级锁 (Table Lock)
- 普通表锁:LOCK TABLES t READ/WRITE。开销小,冲突概率高,InnoDB 不推荐用。
- 元数据锁 (MDL, Metadata Lock):不需要手动加,系统自动加。当你对表做 DML(增删改查)时加 MDL 读锁;做 DDL(改表结构)时加 MDL 写锁。 这是为了防止你正查着数据,别人把表字段给删了。
- 意向锁 (Intention Lock):InnoDB 特有。事务在加“行锁”前,会先在“表级别”加一个意向锁。它的目的是提高别人加表锁的效率(别人一看表上有意向锁,就知道里面有行被锁了,直接阻塞,不用去遍历每一行)。
- 行级锁 (Row Lock)
- 特点:InnoDB 特有,开销大,冲突概率低,并发度最高。
- 注意:InnoDB 的行锁是加在索引上的,不是加在物理记录上的。如果 WHERE 条件没走索引,就会退化成锁全表!
维度二:按“锁的属性”分(读还是写?)
不管是表锁还是行锁,都分为这两种:
- 共享锁 (S锁 / Shared Lock / 读锁)
- 规则:读读不互斥,读写互斥。我加了 S 锁,你也能加 S 锁来读,但你不能加 X 锁去写。
- 怎么加:SELECT … LOCK IN SHARE MODE;
- 排他锁 (X锁 / Exclusive Lock / 写锁)
- 规则:写写互斥,写读互斥。我加了 X 锁,你就什么都不能干了,得等我。
- 怎么加:UPDATE, DELETE, INSERT 自动加。或者手动 SELECT … FOR UPDATE;
维度三:按“行锁的算法”分(怎么锁行?)【核心重点】
这是 InnoDB 解决幻读问题的杀手锏,面试极高频!
- 记录锁 (Record Lock)
- 只锁住这一行的索引记录。
- 场景:精准命中一条记录(如 WHERE id = 1,id 是主键)。
- 间隙锁 (Gap Lock)
- 锁住两条记录之间的间隙,不包括记录本身。
- 作用:防止别的事务在这个间隙里插入 (Insert) 新数据,这是解决幻读的关键。
- 场景:通常在可重复读 (RR) 隔离级别下工作。
- 临键锁 (Next-Key Lock)
- 等于 记录锁 + 间隙锁。即锁住记录本身,又锁住它前面的间隙(左开右闭区间 ( ])。
- 特点:这是 InnoDB 在 RR 级别下的默认行锁算法。范围查询时(如 WHERE id > 10 AND id < 20),就会加上临键锁。
维度四:按“设计思想”分(怎么看待并发冲突?)
- 悲观锁 (Pessimistic Lock)
- 思想:总觉得别人会修改数据,所以每次操作前都先上锁(上面的 S锁、X锁、行锁、表锁全是悲观锁的实现)。
- 乐观锁 (Optimistic Lock)
- 思想:觉得冲突很少发生,操作时不加锁,只在更新提交时去检查有没有人动过数据。
- 实现:MySQL 自身不提供乐观锁,这是业务层面的实现。通常是在表里加一个 version(版本号)字段。
- 语句:UPDATE table SET name = ‘A’, version = 2 WHERE id = 1 AND version = 1;(利用 CAS 思想)。
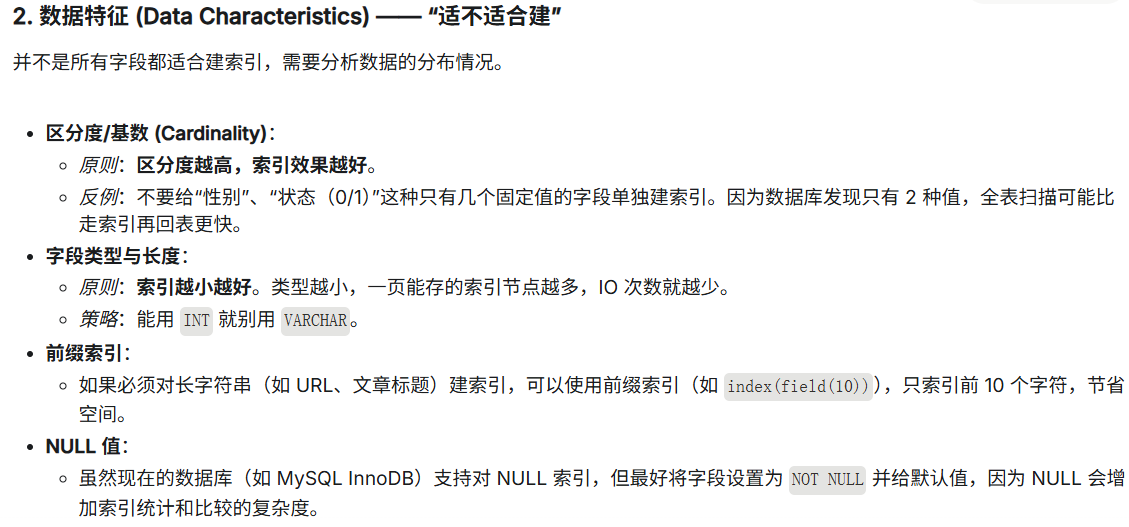
你会怎么建立索引,设计索引要考虑哪些角度
1.选择唯一性索引
唯一性索引的值是唯一的,可以更快速的通过该索引来确定某条记录。例如,学生表中学号是具有唯一性的字段。为该字段建立唯一性索引可以很快的确定某个学生的信息。如果使用姓名的话,可能存在同名现象,从而降低查询速度。
2.为经常需要排序、分组和联合操作的字段建立索引
经常需要ORDER BY、GROUP BY、DISTINCT和UNION等操作的字段,排序操作会浪费很多时间。如果为其建立索引,可以有效地避免排序操作。
3.为常作为查询条件的字段建立索引
如果某个字段经常用来做查询条件,那么该字段的查询速度会影响整个表的查询速度。因此,为这样的字段建立索引,可以提高整个表的查询速度。
4.尽量使用前缀来索引
如果索引字段的值很长,最好使用值的前缀来索引。例如,TEXT和BLOG类型的字段,进行全文检索会很浪费时间。如果只检索字段的前面的若干个字符,这样可以提高检索速度。
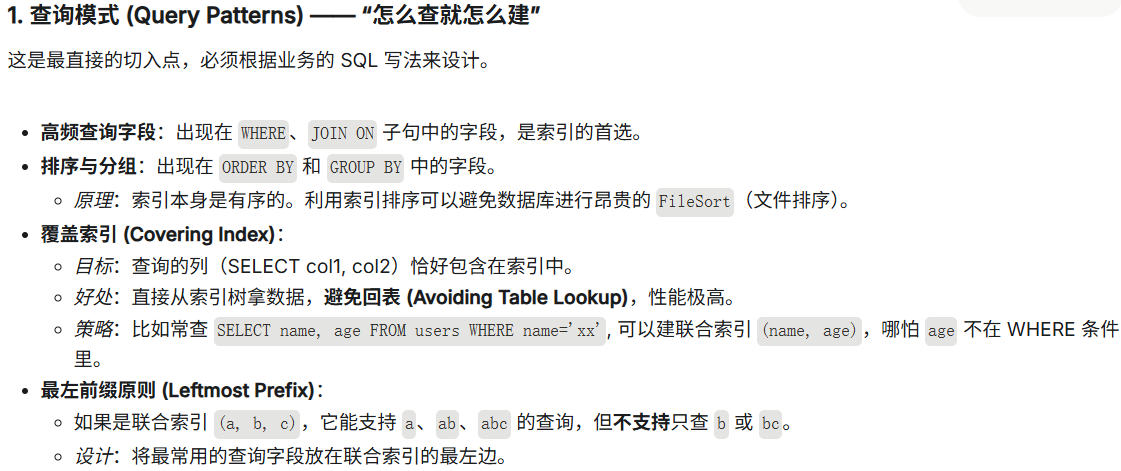
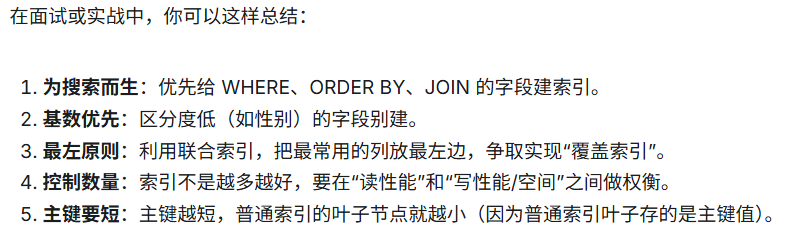
首先,我会分析业务中的高频查询 SQL,优先给 WHERE、ORDER BY、JOIN 的字段建立索引。
其次,在设计索引结构时,我会遵循**‘区分度高在前、等值在前’的原则,并尽量使用联合索引来覆盖多个查询条件,利用索引覆盖特性来减少回表 IO。
最后,我会通过 **Explain**工具验证索引是否生效,并警惕**冗余索引和长字符串索引带来的存储压力,确保读写性能的平衡。”
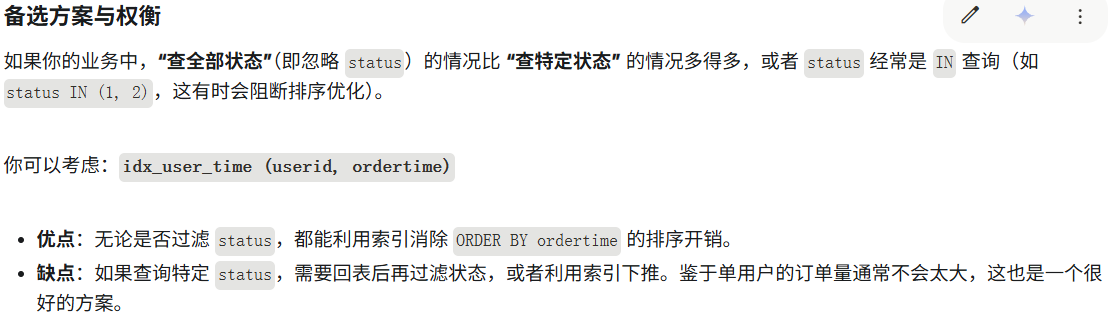
给了一个订单表 where后有userid status ordertime 怎么设计索引 为什么?
索引失效的场景,索引的优点与缺点
1.联合索引不满足最左匹配原则
**2.使用了select ***
禁止使用select * 语句可能会带来的附带好处就是:某些情况下可以走覆盖索引
3.索引列参与运算
直接来看示例:
1 | |
4.索引列参使用了函数
示例:
1 | |
5.错误的Like使用(一般前缀索引失效)
示例:
1 | |
针对like的使用非常频繁,但使用不当往往会导致不走索引。常见的like使用方式有:
方式一:like ‘%abc’;
方式二:like ‘abc%’;
方式三:like ‘%abc%’;
其中方式一和方式三,由于占位符出现在首部,导致无法走索引。这种情况不做索引的原因很容易理解,索引本身就相当于目录,从左到右逐个排序。而条件的左侧使用了占位符,导致无法按照正常的目录进行匹配,导致索引失效就很正常了。
第五种索引失效情况:模糊查询时(like语句),模糊匹配的占位符位于条件的首部。
6 类型隐式转换
示例:
1 | |
id_no字段类型为varchar,但在SQL语句中使用了int类型,导致全表扫描。
出现索引失效的原因是:varchar和int是两个种不同的类型。
解决方案就是将参数1002添加上单引号或双引号。
第六种索引失效情况:参数类型与字段类型不匹配,导致类型发生了隐式转换,索引失效
7.负向查询
负向查询指的是在查询中使用不等于(<>)或不包含(NOT IN、NOT EXISTS等)的条件,即查询不满足某些条件的记录。负向查询通常会导致数据库执行全表扫描,影响查询性能。
8.索引的优点:
① 建立索引的列可以保证行的唯一性,生成唯一的rowId
② 建立索引可以有效缩短数据的检索时间
③ 建立索引可以加快表与表之间的连接
④ 为用来排序或者是分组的字段添加索引可以加快分组和排序顺序
9.索引的缺点:
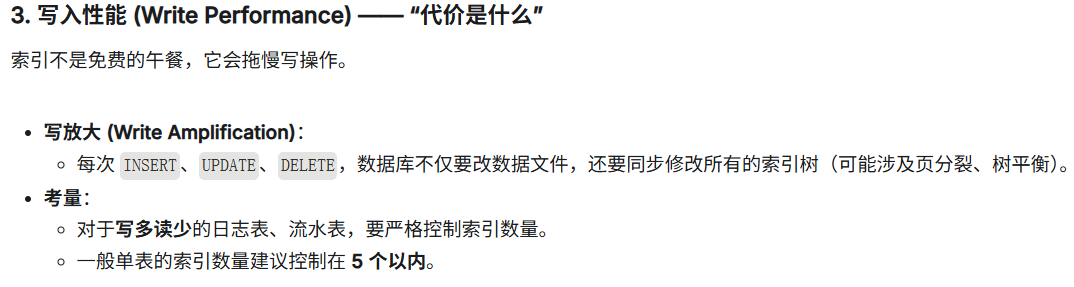
① 创建索引和维护索引需要时间成本,这个成本随着数据量的增加而加大
② 创建索引和维护索引需要空间成本,每一条索引都要占据数据库的物理存储空间,数据量越大,占用空间也越大(数据表占据的是数据库的数据空间)
③ 会降低表的增删改的效率,因为每次增删改索引需要进行动态维护,导致时间变长
10.什么情况下需要建立索引
数据量大的,经常进行查询操作的表要建立索引。
用于排序的字段可以添加索引,用于分组的字段应当视情况看是否需要添加索引。
表与表连接用于多表联合查询的约束条件的字段应当建立索引。
是否存在一条查询同时使用两个索引的情况
MySQL 是支持一条查询同时使用多个索引的情况的,但这种情况是有限制的,通常只有在特定场景下才会发生,叫做 索引合并(Index Merge)优化策略。
Index Merge 是指 MySQL 可以在一条 SQL 查询中使用 多个单列索引,将它们的结果合并后再去取数据。
MySQL 中主要有 3 种 Index Merge 类型:

1 | |
这时 MySQL 可能 使用 Index Merge Intersection 策略:
- 从
idx_name找出所有 name=’Tom’ 的主键 ID - 从
idx_age找出所有 age=18 的主键 ID - 取交集后回表查询数据

MySQL 支持在一条查询中使用多个单列索引,通过 Index Merge 策略进行合并。Index Merge 分为 Intersection 和 Union 两种形式,分别用于 AND 和 OR 的场景。不过,Index Merge 并不支持联合索引、排序优化,回表代价也比较大。通常建议使用联合索引代替 Index Merge 来获得更优性能。
sql语句的leftjoin rightjoin innerjoin区别
 =
Mybatis如何讲一个sql结果集封装成一个java对象返回
MyBatis 的核心功能之一就是将 SQL 执行结果映射为 Java 对象,主要通过 ResultMap 和 内置的类型处理器(TypeHandler) 来实现。在 MyBatis 中,映射过程大致分为以下几个步骤:
SQL 语句执行:MyBatis 从配置文件或注解中读取 SQL 语句,并通过 SqlSession 执行该语句。
结果集解析:SQL 语句执行后,数据库返回一个结果集(ResultSet),MyBatis 将其转换为一组键值对的集合。
映射到目标对象:MyBatis 根据预先定义的映射规则(通过 ResultMap 或内置规则)将结果集中的数据映射为 Java 对象。映射规则可以是自动的(基于字段名的匹配)或显式定义的(通过 ResultMap 配置)。
返回对象:映射完成后,MyBatis 将这些对象返回给调用者。
mybatis一级缓存和二级缓存(一文搞懂MyBatis的一级缓存和二级缓存MyBatis提供了缓存机制来提高查询效率,并且可分为一级缓存和二级缓存。在本 - 掘金_)
如何排查慢查询?实际操作是什么?慢查询的优化方案
1.分析慢SQL的步骤
慢查询的开启并捕获:开启慢查询日志,设置阈值,比如超过5秒钟的就是慢SQL,至少跑1天,看看生产的慢SQL情况,并将它抓取出来
explain + 慢SQL分析
2.慢查询日志(定位慢SQL)
MySQL的慢查询日志是MySQL提供的一种日志记录,它用来记录在MySQL中响应时间超过阈值的语句,具体指运行时间超过long_query_time值的SQL,则会被记录到慢查询日志中。
- long_query_time的默认值为10,意思是运行10秒以上的语句
- 由慢查询日志来查看哪些SQL超出了我们的最大忍耐时间值,比如一条SQL执行超过5秒钟,我们就算慢SQL,希望能收集超过5秒钟的SQL,结合之前explain进行全面分析
查看慢查询日志是否开以及如何开启
- 查看慢查询日志是否开启:
SHOW VARIABLES LIKE '%slow_query_log%';。 - 开启慢查询日志:
SET GLOBAL slow_query_log = 1;。使用该方法开启MySQL的慢查询日志只对当前数据库生效,如果MySQL重启后会失效。
1 | |
设置慢SQL的时间阈值
查看阈值
时间阈值是由参数long_query_time控制的,默认情况下long_query_time的值为10秒。
MySQL中查看long_query_time的时间:SHOW VARIABLES LIKE 'long_query_time%';
1 | |
设置阈值
1 | |
3.用Explain分析具体的sql语句

1 | |
4.慢查询的优化(SQL语句优化,索引优化,表优化)
最简单的衡量查询开销的三个指标:响应时间,扫描的行数,返回的行数
查询访问计划,查看type字段是否走索引,走什么样的索引,以及通过rows字段查看MYSQL的预计扫描的行数
如果发现查询需要扫描大量的数据但返回少量的行,可以使用覆盖索引避免回表
重构查询的方式
- 1.复杂的查询->多个简单查询
- 切片查询,对于大查询可以切分成小查询,每个查询功能一模一样,只完成一小部分,每次只返回一部分查询结果,例如删除数据,如果定期删除大量数据的话,一个大的语句一次性完成可能会锁住很多的数据,一些小的且重要的查询不能进行,我们可以将一个大的delete切分成多个小的查询,同时还可以减少mysql主从的延迟,也可以在每次小的删除时暂停一会,这样服务器原本一次的压力分散到一个很长的时间
- 分解关联查询,可以对每一个表进行一次单表查询,然后将结果在应用程序进行关联
分页查询优化(避免
LIMIT偏移过大),读取适当的记录LIMIT M,N,如果偏移过大,出现深分页的问题,采用覆盖索引返回主键+再根据主键关联原表获取行尽量不要超过三个表join(小表驱动大表)
在varchar字段上建立索引时,必须指定索引长度
1
2
3
没必要对全字段建立索引,根据实际文本区分度决定索引长度。
索引的长度与区分度是一对矛盾体,一般对字符串类型数据,长度为20的索引,区分度会高达90%以上,可以使用count(distinct left(列名, 索引长度))/count(*)的区分度来确定不要使用 select *,使用覆盖索引,避免回表
避免索引失效
考虑使用分库分表(大数据量)
✅ 一、判断是否慢查询的三个关键指标:
- 响应时间(execution time)
- 扫描的行数(rows examined)
- 返回的行数(rows returned)
使用 EXPLAIN 分析 SQL 的执行计划,重点关注:
type:是否使用了索引(ALL=全表扫描不推荐)rows:预计扫描的行数Extra:是否有 “Using index”、“Using where”、“Using filesort”等关键提示
✅ 二、索引优化策略
- 使用覆盖索引(select 的字段全部命中索引列,避免回表)
- 使用前缀索引:对
VARCHAR字段建索引时应指定长度,避免索引膨胀- 通过
count(distinct left(column, len)) / count(*)分析选择合适长度
- 通过
- 避免索引失效:
- 不能对函数操作字段建索引(如
WHERE left(name,3)=...) - 范围条件放在最后,如:
WHERE a=1 AND b>10会导致b后面的索引失效
- 不能对函数操作字段建索引(如
- 控制 Join 表数量:不建议超过 3 张表 Join,注意小表驱动大表
- 为频繁查询的列创建索引,避免使用不必要的索引。虽然索引对于加快查询速度非常有帮助
SELECT,但它们可能会稍微降低INSERT、UPDATE和DELETE操作的速度。
✅ 三、SQL查询方式优化
1.复杂查询拆解成多个简单查询
- 减少锁范围,提高缓存命中率
2.切片查询(大查询拆小)
- 适用于大数据量的删除、更新操作
- 避免长事务锁表,也减少主从延迟
- 可以加 sleep 实现分散负载
3.分页优化
- 避免
LIMIT offset, size偏移过大 - 推荐:
- 查询主键:
SELECT id FROM table WHERE 条件 LIMIT offset,size - 再回表:
SELECT * FROM table WHERE id IN (...)
- 查询主键:
4.分解关联查询
- 将多表查询拆成多个单表查询 + 应用层聚合(尤其适用于缓存友好的场景)
5.避免冗余或不必要的数据检索
- 避免使用 SELECT ,减少IO
- 我们可以使用
LIMIT此功能来减少返回的行数。此功能可以防止我们在只需要处理几行数据时无意中检索数千行数据。
✅ 四、表结构优化
- 合理使用分库分表,尤其是海量数据场景
所以有涉及过大文件上传吗?有思路没有?没做过没关系
SQL注入问题(一文搞懂什么是SQL注入—SQL注入详解一:什么是sql注入 SQL注入是比较常见的网络攻击方式之一,它不是利用操作 - 掘金)
有用过一些复杂的SQL吗,就多张表数据处理,比如左连接,用的时候有什么需要注意的问题,细节?
1.小表驱动大表
2.连接字段尽量有索引,避免索引失效
3.使用 EXPLAIN 分析执行计划
MySQL执行计划如何查看,explain能提供什么信息?
1.如何启动执行计划
1 | |
2.创建表
1 | |
注意:如果有join连接查询,会输出两行
1 | |

3.详细讲讲type字段
这是重要的列,显示连接使用了何种类型。从最好到最差的连接类型为 system > const > eq_reg > ref > range > index > ALL。
一般来说,得保证查询达到range级别,最好达到ref
3.1 system:表中只有一行数据。属于 const 的特例。如果物理表中就一行数据为 ALL
3.2 const (常量查询)
查询结果最多有一个匹配行。因为只有一行,所以可以被视为常量。const 查询速度非常快,因为只读一次。一般情况下把主键或唯一索引作为唯一条件的查询都是 const(等值查询)
explain select * from (select * from film where id = 1) tmp;

derived2表示来源2的结果,因为film查询时走了id=1的主键索引,所以肯定一条数据是const
1 | |
我为card_id建立了唯一索引,name没有建立索引(我感觉sql会优化,card_id是唯一索引,name就没用了)
3.3 eq_ref(唯一索引等值匹配)
- 说明:
eq_ref用于 主键(PRIMARY KEY)或唯一索引(UNIQUE KEY) 的等值查询,通常出现在多表JOIN操作中。- 对于每一行来自主表的数据,子表最多只会返回一条匹配记录。
1 | |

这时第一个表film_actor建立了联合索引(film_id,actor_id)为啥是ALL不是Index,待定(可能是表数据少?,回表把)。
第二个表**type: eq_ref** → 唯一索引匹配(eq_ref),说明 film_id 是主键,每次 film_actor.film_id 只会匹配 film 表的一行,连接效率最高
3.4 ref(普通索引等值匹配)
说明:
ref表示查询使用了非唯一索引(普通索引、非唯一的外键索引)。- 适用于非唯一索引或
JOIN操作中的索引匹配,可能会返回 多行 数据。
简单 select 查询,name是普通索引(非唯一索引)
explain select * from film where name = 'film1';1
2
3
4
5
6
7
8
9
- 
- 关联表查询,idx_film_actor_id是film_id和actor_id的联合索引,这里使用到了film_actor的左边前缀film_id部分
- ```sql
explain select * from film left join film_actor on film.id = film_actor.film_id;
film_id是个普通索引,与film表的id可能返回多行
3.5range(范围查询)
说明:
range表示基于索引范围扫描,可以使用索引高效查找数据。- 常见的范围查询有
BETWEEN、>、<、IN等。
1
explain select * from actor where id > 1;
3.6index(全索引扫描)—-没搞明白,它为什么key是idx_name走二级索引,不走聚簇
说明:
index表示 全索引扫描,相当于ALL(全表扫描),但扫描的是索引而非数据行。- 适用于索引覆盖查询(即不需要回表查询)。
示例:
explain select * from film;1
2
3
4
5
6
7
8
9
10
11
12
13
14
- 
- 我认为这个sql语句是直接查询的主键的B+树,然后取出数据
**3.7`ALL`(全表扫描,性能最差-----没搞明白,为什么不走聚簇,sql优化器问题?)**
- **说明**:
- `ALL` 表示 **全表扫描**,意味着 MySQL 需要遍历整个表的所有数据行。
- 适用于**无索引**的查询,或者查询无法利用索引。
- ```
explain select * from actor;

4.Key字段——————实际使用的索引。如果为 NULL,则没有使用索引。
5.Extra字段———没写全
5.1Using index:从只使用索引树中的信息而不需要进一步搜索读取实际的行来检索表中的列信息。(使用覆盖索引)
覆盖索引定义:mysql执行计划explain结果里的key有使用索引,如果select后面查询的字段都可以从这个索引的树中获取,这种情况一般可以说是用到了覆盖索引,extra里一般都有using index;覆盖索引一般针对的是辅助索引,整个查询结果只通过辅助索引就能拿到结果,不需要通过辅助索引树找到主键,再通过主键去主键索引树里获取其它字段值
1 | |

CHAR 和 VARCHAR 有什么区别
1.char是固定长度,varchar是可变长度
2.char类型来说,最多只能存放的字符个数为255,MySQL行默认最大65535字节,是所有列共享(相加)的,所以VARCHAR的最大值受此限制
3.CHAR适合存储很短或长度近似的字符串。
设计表结构时,一对一的关系怎么设计,一对多的关系怎么设计?,多对多的关系怎么设计?
关系数据库常见问题
对哪个框架比较熟悉。说说MyBatis的xml文件到mapper最后查到内容的过程
mysql常用关键字的执行顺序?
- FROM 子句
- JOIN 操作
- WHERE 子句
- GROUP BY 子句
- HAVING 子句
- SELECT 子句
- DISTINCT 关键字
- ORDER BY 子句
- LIMIT 子句
From语句
FROM子句是SQL语句的起点,决定了查询的数据源。此步骤会从指定的表或视图中提取数据。
JOIN 操作
如果查询中包含多个表的联接操作,MySQL会在FROM子句后执行联接操作。联接类型包括内联接(INNER JOIN)、左联接(LEFT JOIN)、右联接(RIGHT JOIN)等。
WHERE 子句
WHERE子句用于过滤行,仅保留满足条件的行。MySQL通过扫描临时结果集并应用条件过滤数据。
Group By子句
GROUP BY子句用于将结果集按一个或多个列进行分组。此步骤会生成一个新的结果集,每个分组包含一组数据行。
HAVING 子句
HAVING子句用于过滤分组后的结果集,仅保留满足条件的分组。它类似于WHERE子句,但WHERE用于行过滤,而HAVING用于分组过滤。
Mysql深分页(深度分页介绍及优化建议 | JavaGuide)(深分页怎么导致索引失效了?提供6种优化的方案!深分页问题怎么导致索引失效了?提供6种优化的方案!本篇文章来聊聊深分页场景 - 掘金)(https://juejin.cn/post/7012016858379321358)
这里需要注意的是Mysql的关键字的执行顺序,他是先select在Limit(要想通过面试,MySQL的Limit子句底层原理你不可不知_mysql limit原理-CSDN博客)
MySQL是在server层准备向客户端发送记录的时候才会去处理limit子句中的内容
如果需要查询的列在二级索引上都存在,可以使用二级索引(覆盖索引)避免回表
如果满足查询条件后主键有序并且业务上不用跳页那么可以选择游标分页
如果满足查询条件后主键有序并且业务上需要支持跳页,可以选择子查询
多表连接怎么优化,多变连接的情况下,如果要分页查询该怎么改造?,多表连接如何创建索引?联合索引是作用在哪里?
1.优化
确保正确的索引,每个关联表的连接字段上创建合适的索引是加快连接查询速度的关键
使用内连接
限制查询结果集大小,在实际应用中,通常不需要返回查询结果集中的所有列和所有行。通过限制返回结果集的大小,可以降低查询的复杂度和执行时间。可以使用LIMIT关键字限制返回的行数,减少数据传输和处理的开销。
小表驱动大表
适当使用
WHERE过滤,先WHERE过滤,再JOIN,减少数据量,提高查询效率。1
2
3
4
5-- 避免在 JOIN 之后才筛选
SELECT * FROM users u JOIN orders o ON u.id = o.user_id WHERE o.status = 'completed';
-- 推荐先筛选 orders,再 JOIN
SELECT * FROM users u JOIN (SELECT * FROM orders WHERE status = 'completed') o ON u.id = o.user_id;
2.多表连接分页查询优化
- 采用子查询
MySQL内部如何提高扫描效率?
1.索引
2.MySQL 查询缓存
3.覆盖索引避免回表
4.优化器
数据库的三大范式,你 了解吗?(数据库设计的三范式超详细详解_数据库三范式-CSDN博客)
如何定义关系型/非关系型?关系型数据库的相关规范?
关系型数据库是以 关系模型(关系代数) 为基础,通过 表格(Table)形式组织数据,表与表之间通过主键和外键建立关系,如Mysql
非关系型数据库则不基于关系模型,适用于灵活的数据结构和高并发场景,如Redis
关系型数据库遵循的规范主要有:
三大范式(3NF) —— 数据库设计的重要指导思想:
- 第一范式(1NF):每一列都是不可再分的原子值
- 第二范式(2NF):在满足1NF的基础上,每个非主属性完全依赖于主键
- 第三范式(3NF):在满足2NF的基础上,消除传递依赖
ACID 特性:保证事务的可靠执行
- A(原子性):事务要么全部完成,要么全部失败
- C(一致性):执行前后数据库状态一致
- I(隔离性):事务互不干扰
- D(持久性):事务完成后修改永久保存
索引下推(五分钟搞懂MySQL索引下推大家好,我是老三,分享一个小知识点。面试时候问到索引,常常会顺嘴问一句索引下推。给我五分钟, - 掘金)
索引下推是 MySQL 5.6 引入的一种优化机制。它允许存储引擎在遍历索引时,就利用索引中包含的字段直接过滤数据,从而减少回表(Lookups)的次数,降低 IO 开销。
联合索引提供了额外信息 →→ ICP 利用这些信息在引擎层提前过滤 →→ 过滤后需要回表的数据变少了 →→ 随机 I/O 次数减少 →→ 性能提升。
如何判断是否生效?
在 EXPLAIN 的 Extra 字段中,如果看到 Using index condition,说明触发了索引下推优化
MyBatis 的实现原理是什么?
我们可以将其实现原理分为三个核心阶段:配置加载阶段、代理绑定阶段 和 SQL执行阶段。
1. 配置加载与初始化阶段
这是 MyBatis 启动的第一步,目标是读取所有配置文件,解析成内存中的配置对象,为后续操作做好准备。
- 加载主配置文件 (mybatis-config.xml):
- 应用程序通过 SqlSessionFactoryBuilder 的 build() 方法,传入配置文件的输入流。
- SqlSessionFactoryBuilder 会创建一个 XMLConfigBuilder 解析器,来解析这个 XML 文件。
- 解析器会读取 XML 中的所有配置,如数据源(DataSource)、事务管理器(TransactionManager)、类型别名(TypeAliases)、插件(Plugins)以及Mapper 文件的路径等。
- 加载 Mapper 文件 (*.xml):
- 在解析主配置文件时,会找到所有
标签指定的 Mapper.xml 文件。 - 针对每一个 Mapper.xml 文件,会创建一个 XMLMapperBuilder 来解析它。
- XMLMapperBuilder 会解析出 Mapper 文件中的
- MappedStatement 对象是 MyBatis 中极其核心的一个对象,它包含了执行 SQL 所需的全部信息:
- SQL 语句本身:包括动态 SQL 标签。
- Statement ID:由 namespace + id 组成 (例如 com.example.mapper.UserMapper.selectById)。
- 输入参数类型 (parameterType)。
- 输出结果映射规则 (resultType 或 resultMap)。
- 在解析主配置文件时,会找到所有
- 创建 Configuration 对象和 SqlSessionFactory:
- 所有解析出来的信息(数据源、事务管理器、所有的 MappedStatement 等)都会被存放在一个全局唯一的 Configuration 对象中。这个对象就是 MyBatis 运行时的“大脑”和“配置库”。
- 最后,SqlSessionFactoryBuilder 会根据这个 Configuration 对象创建一个 SqlSessionFactory 的实例。SqlSessionFactory 是一个重量级的、线程安全的对象,通常在应用生命周期中只需要一个。它的作用就是创建 SqlSession。
2. 代理绑定与 Mapper 获取阶段
这是 MyBatis 最具“魔法”色彩的部分。我们只定义了 Mapper 接口,并没有写实现类,但却能直接调用它的方法。这背后的核心技术是 Java 动态代理。
- 获取 SqlSession:
- 应用程序通过 sqlSessionFactory.openSession() 来获取一个 SqlSession。
- SqlSession 是 MyBatis 与数据库进行一次会话的入口,它是非线程安全的,通常一个请求或一个方法对应一个 SqlSession,用完必须关闭。它内部持有一个 Executor(执行器)。
- 获取 Mapper 代理对象:
- 当调用 sqlSession.getMapper(UserMapper.class) 时,奇妙的事情发生了。
- MyBatis 会根据传入的接口类型 UserMapper.class,使用 JDK 动态代理(或 CGLIB)在内存中动态地创建一个该接口的代理实现类。
- 这个代理对象的核心是一个 InvocationHandler,在 MyBatis 中通常是 MapperProxy。
- 方法调用拦截:
- 当你在代码中调用 userMapper.selectById(1) 时,这个调用实际上是被刚才创建的那个代理对象拦截了。
- MapperProxy 的 invoke 方法会被触发。它知道你调用的是哪个接口(UserMapper)的哪个方法(selectById)以及传入的参数(1)。
3. SQL 执行与结果映射阶段
这是实际与数据库交互的阶段。代理对象会将调用信息传递给 SqlSession 内部的组件来完成。
- MapperProxy 转发:
- MapperProxy 会根据调用的方法名和接口名,拼接成 MappedStatement 的 ID(如 com.example.mapper.UserMapper.selectById)。
- 然后它会调用 SqlSession 对应的方法(如 selectOne, selectList),并将这个 ID 和参数传递过去。
- Executor 执行器执行:
- SqlSession 将请求转交给它内部的 Executor(执行器)。Executor 是 MyBatis 调度的核心,负责 SQL 的生成和查询缓存的维护。
- Executor 首先会检查一级缓存(Session 级别的缓存),如果命中则直接返回结果。
- 如果一级缓存未命中,并且配置了二级缓存(Mapper 级别的缓存),则检查二级缓存。
- 如果缓存都未命中,Executor 会创建一个 StatementHandler。
- StatementHandler 处理:
- StatementHandler 负责与 JDBC 进行真正的交互。
- 它通过 ParameterHandler 将传入的 Java 参数对象设置到 JDBC 的 PreparedStatement 中(替换 ? 占位符)。
- 然后调用 preparedStatement.execute() 来执行 SQL。
- ResultSetHandler 结果映射:
- 执行完 SQL 后,得到 JDBC 的 ResultSet 结果集。
- StatementHandler 会调用 ResultSetHandler 来处理这个结果集。
- ResultSetHandler 根据 MappedStatement 中配置的 resultType 或 resultMap 规则,将 ResultSet 中的每一行数据转换成一个 Java 对象。
- 这个转换过程大量使用了 Java 反射技术:通过反射创建目标对象实例,并调用其 setter 方法或直接为字段赋值。
- 返回结果:
- ResultSetHandler 将处理好的 Java 对象(或对象列表)返回给 Executor,Executor 再将其存入缓存并返回给 SqlSession,最终通过代理返回给调用方。
1. 初始化阶段(解析配置)
- MyBatis 启动时,会读取全局配置文件(mybatis-config.xml)和所有的 Mapper 映射文件(*Mapper.xml)。
- 将这些 XML 中的配置信息(包括 SQL 语句、参数类型、结果映射
等)解析成底层的对象(如 MappedStatement),并统一存放在一个全局的 Configuration 对象中。 - 基于这个大管家对象,构建出 SqlSessionFactory(工厂类)。
2. 代理生成阶段(动态代理)
- 在代码中,我们通常只写一个 Mapper 接口(比如 UserMapper),并没有写实现类。
- 当我们调用 sqlSession.getMapper(UserMapper.class) 时,MyBatis 会使用 JDK 动态代理,在内存中为这个接口生成一个代理对象(MapperProxy)。
3. SQL 执行阶段(拦截与路由)
- 当我们调用代理对象的方法(比如 userMapper.findById(1))时,代理对象会拦截这个调用。
- 它会根据**“接口的全限定名 + 方法名”**(如 com.xxx.UserMapper.findById),去 Configuration 对象中找到第一步解析好的那条对应 SQL(MappedStatement)。
- 接着,将请求交给底层的核心执行器 Executor。Executor 负责获取数据库连接、开启事务,并调用内部组件处理 SQL 参数(替换 #{} 为 ? 等)。
4. 结果映射阶段(反射赋值)
- 底层仍然是调用原生的 JDBC API(PreparedStatement)去数据库执行 SQL。
- 拿到数据库返回的 ResultSet 后,MyBatis 的 ResultSetHandler 组件会出场。
- 它会根据我们配置的 resultType 或 resultMap,利用反射机制,自动实例化 Java POJO 对象,并将表中的列值一一赋给对象的属性。最终将封装好的对象(或集合)返回给调用者
MyBatis和MyBatis-plus底层原理区别是什么?
“MyBatis 和 MyBatis-Plus 并不是替代关系,MP 的口号是‘只做增强不做改变’,所以 MP 的底层执行引擎依然是完全纯正的 MyBatis。
它们底层的核心区别在于 ‘SQL 的生成和注入时机’。
- 原生的 MyBatis 需要在启动时去解析 XML 文件里的 SQL 标签。而 MP 利用了 反射机制 和 SqlInjector (SQL 注入器)。在项目启动时,MP 提取 BaseMapper 里的泛型实体类信息,自动拼接出标准的 CRUD SQL 字符串,然后把这些 SQL 注册为 MappedStatement 塞进 MyBatis 的配置中。
- 其次,在动态查询上,MyBatis 依赖 XML 的
标签;而 MP 设计了一套 Wrapper 机制,在 Java 代码层面拼接条件,并在执行前动态翻译成 SQL 片段。 - 此外,MP 深度利用了 MyBatis 的 Interceptor (插件) 机制,内置了分页、乐观锁、自动填充等插件,极大降低了单表操作的开发成本,但遇到复杂的多表 JOIN,我们依然可以退回使用原生的 MyBatis XML 方式编写。”