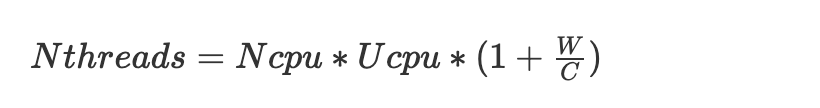并发编程

Java的线程池

Java的线程池的参数,线程池执行流程,线程池线程数量如何设置的?线程池的任务队列长度应该如何设置?
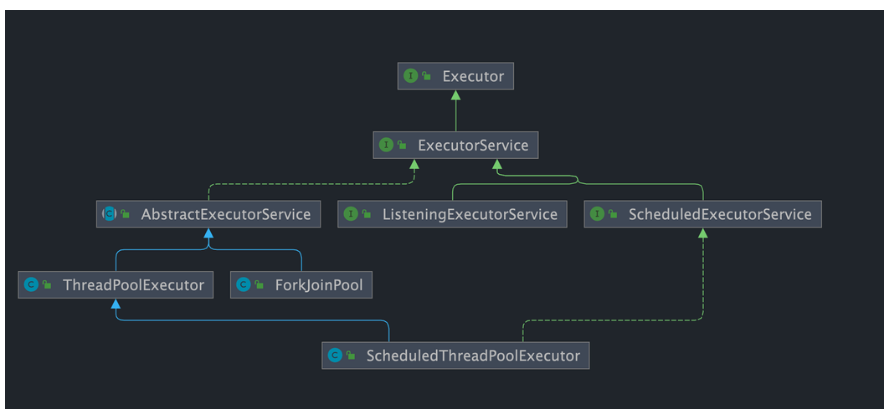
image-20260410161939338

1.Executor框架

Executor 框架是 Java5 之后引进的,在 Java 5 之后,通过 Executor 来启动线程比使用 Threadstart 方法更好,除了更易管理,效率更好(用线程池实现,节约开销)外,还有关键的一点:有助于避免 this 逃逸问题。

this 逃逸是指在构造函数返回之前其他线程就持有该对象的引用,调用尚未构造完全的对象的方法可能引发令人疑惑的错误。

Executor 框架不仅包括了线程池的管理,还提供了线程工厂、队列以及拒绝策略等,Executor 框架让并发编程变得更加简单。

Executor 框架结构主要由三大部分组成:

  • 任务(Runnable /Callable):执行任务需要实现的 Runnable 接口Callable接口Runnable 接口Callable 接口 实现类都可以被 ThreadPoolExecutorScheduledThreadPoolExecutor 执行。

  • 任务的执行(Executor),如下图所示,包括任务执行机制的核心接口 Executor ,以及继承自 Executor 接口的 ExecutorService 接口。ThreadPoolExecutorScheduledThreadPoolExecutor 这两个关键类实现了 ExecutorService 接口。

  • 异步计算的结果(Future)

Future 接口以及 Future 接口的实现类 FutureTask 类都可以代表异步计算的结果。

当我们把 Runnable接口Callable 接口 的实现类提交给 ThreadPoolExecutorScheduledThreadPoolExecutor 执行。(调用 submit() 方法时会返回一个 FutureTask 对象)

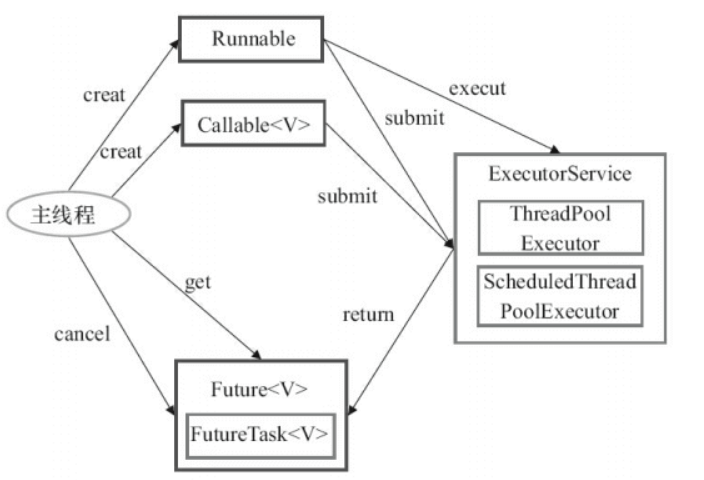
Executor 框架的使用示意图

image-20260410162034483

1.主线程首先要创建实现 Runnable 或者 Callable 接口的任务对象。

2.把创建完成的实现 Runnable/Callable接口的 对象直接交给 ExecutorService 执行: ExecutorService.execute(Runnable command))或者也可以把 Runnable 对象或Callable 对象提交给 ExecutorService 执行(ExecutorService.submit(Runnable task)ExecutorService.submit(Callable <T> task))。

3.如果执行 ExecutorService.submit(…)ExecutorService 将返回一个实现Future接口的对象(我们刚刚也提到过了执行 execute()方法和 submit()方法的区别,submit()会返回一个 FutureTask 对象)。由于 FutureTask 实现了 Runnable,我们也可以创建 FutureTask,然后直接交给 ExecutorService 执行。

4.最后,主线程可以执行 FutureTask.get()方法来等待任务执行完成。主线程也可以执行 FutureTask.cancel(boolean mayInterruptIfRunning)来取消此任务的执行

2.ThreadPoolExecutor类

2.1参数分析

ThreadPoolExecutor 类中提供的四个构造方法。我们来看最长的那个,其余三个都是在这个构造方法的基础上产生(其他几个构造方法说白点都是给定某些默认参数的构造方法比如默认制定拒绝策略是什么)。

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
/**
* 用给定的初始参数创建一个新的ThreadPoolExecutor。
*/
public ThreadPoolExecutor(int corePoolSize,//线程池的核心线程数量
int maximumPoolSize,//线程池的最大线程数
long keepAliveTime,//当线程数大于核心线程数时,多余的空闲线程存活的最长时间
TimeUnit unit,//时间单位
BlockingQueue<Runnable> workQueue,//任务队列,用来储存等待执行任务的队列
ThreadFactory threadFactory,//线程工厂,用来创建线程,一般默认即可
RejectedExecutionHandler handler//拒绝策略,当提交的任务过多而不能及时处理时,我们可以定制策略来处理任务
) {
if (corePoolSize < 0 ||
maximumPoolSize <= 0 ||
maximumPoolSize < corePoolSize ||
keepAliveTime < 0)
throw new IllegalArgumentException();
if (workQueue == null || threadFactory == null || handler == null)
throw new NullPointerException();
this.corePoolSize = corePoolSize;
this.maximumPoolSize = maximumPoolSize;
this.workQueue = workQueue;
this.keepAliveTime = unit.toNanos(keepAliveTime);
this.threadFactory = threadFactory;
this.handler = handler;
}

ThreadPoolExecutor 3 个最重要的参数:

  • corePoolSize : 任务队列未达到队列容量时,最大可以同时运行的线程数量, 线程一直存在,不会销毁
  • maximumPoolSize : 任务队列中存放的任务达到队列容量的时候,当前可以同时运行的线程数量变为最大线程数。
  • workQueue: 新任务来的时候会先判断当前运行的线程数量是否达到核心线程数,如果达到的话,新任务就会被存放在队列中。

ThreadPoolExecutor其他常见参数 :

  • keepAliveTime:线程池中的线程数量大于 corePoolSize 的时候,如果这时没有新的任务提交,核心线程外的线程不会立即销毁,而是会等待,直到等待的时间超过了 keepAliveTime才会被回收销毁。
  • unit : keepAliveTime 参数的时间单位。
  • threadFactory :executor 创建新线程的时候会用到。
  • handler :拒绝策略(后面会单独详细介绍一下)。

ThreadPoolExecutor 拒绝策略定义:

如果当前同时运行的线程数量达到最大线程数量并且队列也已经被放满了任务时,ThreadPoolExecutor 定义一些策略:

  • ThreadPoolExecutor.AbortPolicy:抛出 RejectedExecutionException来拒绝新任务的处理。

  • ThreadPoolExecutor.CallerRunsPolicy:调用执行自己的线程运行任务,也就是直接在调用execute方法的线程中运行(run)被拒绝的任务,如果执行程序已关闭,则会丢弃该任务。因此这种策略会降低对于新任务提交速度,影响程序的整体性能。如果您的应用程序可以承受此延迟并且你要求任何一个任务请求都要被执行的话,你可以选择这个策略。

  • ThreadPoolExecutor.DiscardPolicy:不处理新任务,直接丢弃掉。

  • ThreadPoolExecutor.DiscardOldestPolicy:此策略将丢弃最早的未处理的任务请求。

举个例子:Spring 通过 ThreadPoolTaskExecutor 或者我们直接通过 ThreadPoolExecutor 的构造函数创建线程池的时候,当我们不指定 RejectedExecutionHandler 拒绝策略来配置线程池的时候,默认使用的是 AbortPolicy。在这种拒绝策略下,如果队列满了,ThreadPoolExecutor 将抛出 RejectedExecutionException 异常来拒绝新来的任务 ,这代表你将丢失对这个任务的处理。如果不想丢弃任务的话,可以使用CallerRunsPolicyCallerRunsPolicy 和其他的几个策略不同,它既不会抛弃任务,也不会抛出异常,而是将任务回退给调用者,使用调用者的线程来执行任务

1
2
3
4
5
6
7
8
9
10
11
public static class CallerRunsPolicy implements RejectedExecutionHandler {

public CallerRunsPolicy() { }

public void rejectedExecution(Runnable r, ThreadPoolExecutor e) {
if (!e.isShutdown()) {
// 直接主线程执行,而不是线程池中的线程执行
r.run();
}
}
}

3.线程池创建的两种方式

方式一:通过ThreadPoolExecutor构造函数来创建(推荐)。

方式二:通过 Executor 框架的工具类 Executors 来创建。

Executors工具类提供的创建线程池的方法如下图所示:
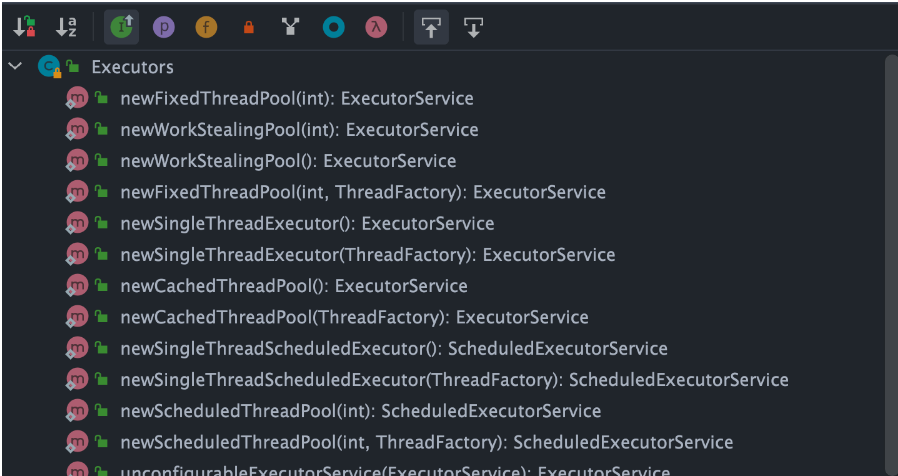
image-20260410162054946

可以看出,通过Executors工具类可以创建多种类型的线程池,包括:

  • FixedThreadPool:固定线程数量的线程池。该线程池中的线程数量始终不变。当有一个新的任务提交时,线程池中若有空闲线程,则立即执行。若没有,则新的任务会被暂存在一个任务队列中,待有线程空闲时,便处理在任务队列中的任务。
  • SingleThreadExecutor: 只有一个线程的线程池。若多余一个任务被提交到该线程池,任务会被保存在一个任务队列中,待线程空闲,按先入先出的顺序执行队列中的任务。
  • CachedThreadPool: 可根据实际情况调整线程数量的线程池。线程池的线程数量不确定,但若有空闲线程可以复用,则会优先使用可复用的线程。若所有线程均在工作,又有新的任务提交,则会创建新的线程处理任务。所有线程在当前任务执行完毕后,将返回线程池进行复用。
  • ScheduledThreadPool:给定的延迟后运行任务或者定期执行任务的线程池。

Executors 返回线程池对象的弊端如下(后文会详细介绍到):

  • FixedThreadPoolSingleThreadExecutor:使用的是无界的 LinkedBlockingQueue,任务队列最大长度为 Integer.MAX_VALUE,可能堆积大量的请求,从而导致 OOM。
  • CachedThreadPool:使用的是同步队列 SynchronousQueue, 允许创建的线程数量为 Integer.MAX_VALUE ,如果任务数量过多且执行速度较慢,可能会创建大量的线程,从而导致 OOM。
  • ScheduledThreadPoolSingleThreadScheduledExecutor:使用的无界的延迟阻塞队列DelayedWorkQueue,任务队列最大长度为 Integer.MAX_VALUE,可能堆积大量的请求,从而导致 OOM。

4.线程池常用的堵塞队列Java并发系列 — 阻塞队列(BlockingQueue)阻塞队列(BlockingQueue)是一个支持两个附加操作 - 掘金

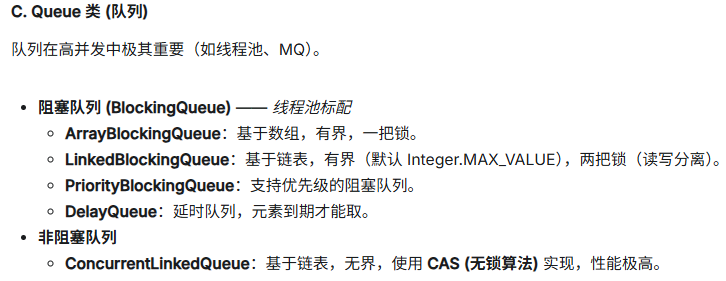
新任务来的时候会先判断当前运行的线程数量是否达到核心线程数,如果达到的话,新任务就会被存放在队列中。

不同的线程池会选用不同的阻塞队列,我们可以结合内置线程池来分析。

  • 容量为 Integer.MAX_VALUELinkedBlockingQueue(无界队列):FixedThreadPoolSingleThreadExectorFixedThreadPool最多只能创建核心线程数的线程(核心线程数和最大线程数相等),SingleThreadExector只能创建一个线程(核心线程数和最大线程数都是 1),二者的任务队列永远不会被放满。

  • SynchronousQueue(同步队列):CachedThreadPoolSynchronousQueue 没有容量,不存储元素,目的是保证对于提交的任务,如果有空闲线程,则使用空闲线程来处理;否则新建一个线程来处理任务。也就是说,CachedThreadPool 的最大线程数是 Integer.MAX_VALUE ,可以理解为线程数是可以无限扩展的,可能会创建大量线程,从而导致 OOM。

  • DelayedWorkQueue(延迟阻塞队列):ScheduledThreadPoolSingleThreadScheduledExecutorDelayedWorkQueue 的内部元素并不是按照放入的时间排序,而是会按照延迟的时间长短对任务进行排序,内部采用的是“堆”的数据结构,可以保证每次出队的任务都是当前队列中执行时间最靠前的。DelayedWorkQueue 添加元素满了之后会自动扩容原来容量的 1/2,即永远不会阻塞,最大扩容可达 Integer.MAX_VALUE,所以最多只能创建核心线程数的线程。

  • ArrayBlockingQueue(常用):基于数组的阻塞队列实现,在 ArrayBlockingQueue 内部,维护了一个定长数组,以便缓存队列中的数据对象,ArrayBlockingQueue 在生产者放入数据和消费者获取数据,都是共用同一个锁对象,由此也意味着两者无法真正并行运行。

  • LinkedBlockingQueue(常用):底层基于链表,先进先出(FIFO) 方式存储任务。默认无界(可以指定大小)。当队列缓冲区达到最大值缓存容量时,才会阻塞生产者队列,直到消费者从队列中消费掉一份数据,生产者线程会被唤醒(通知机制),反之对于消费者这端的处理也基于同样的原理。LinkedBlockingQueue 之所以能够高效的处理并发数据,还因为其对于生产者端和消费者端分别采用了独立的锁来控制数据同步,这也意味着在高并发
    的情况下生产者和消费者可以并行地操作队列中的数据,以此来提高整个队列的并发性能。生产者往队尾添加元素,消费者队头取元素
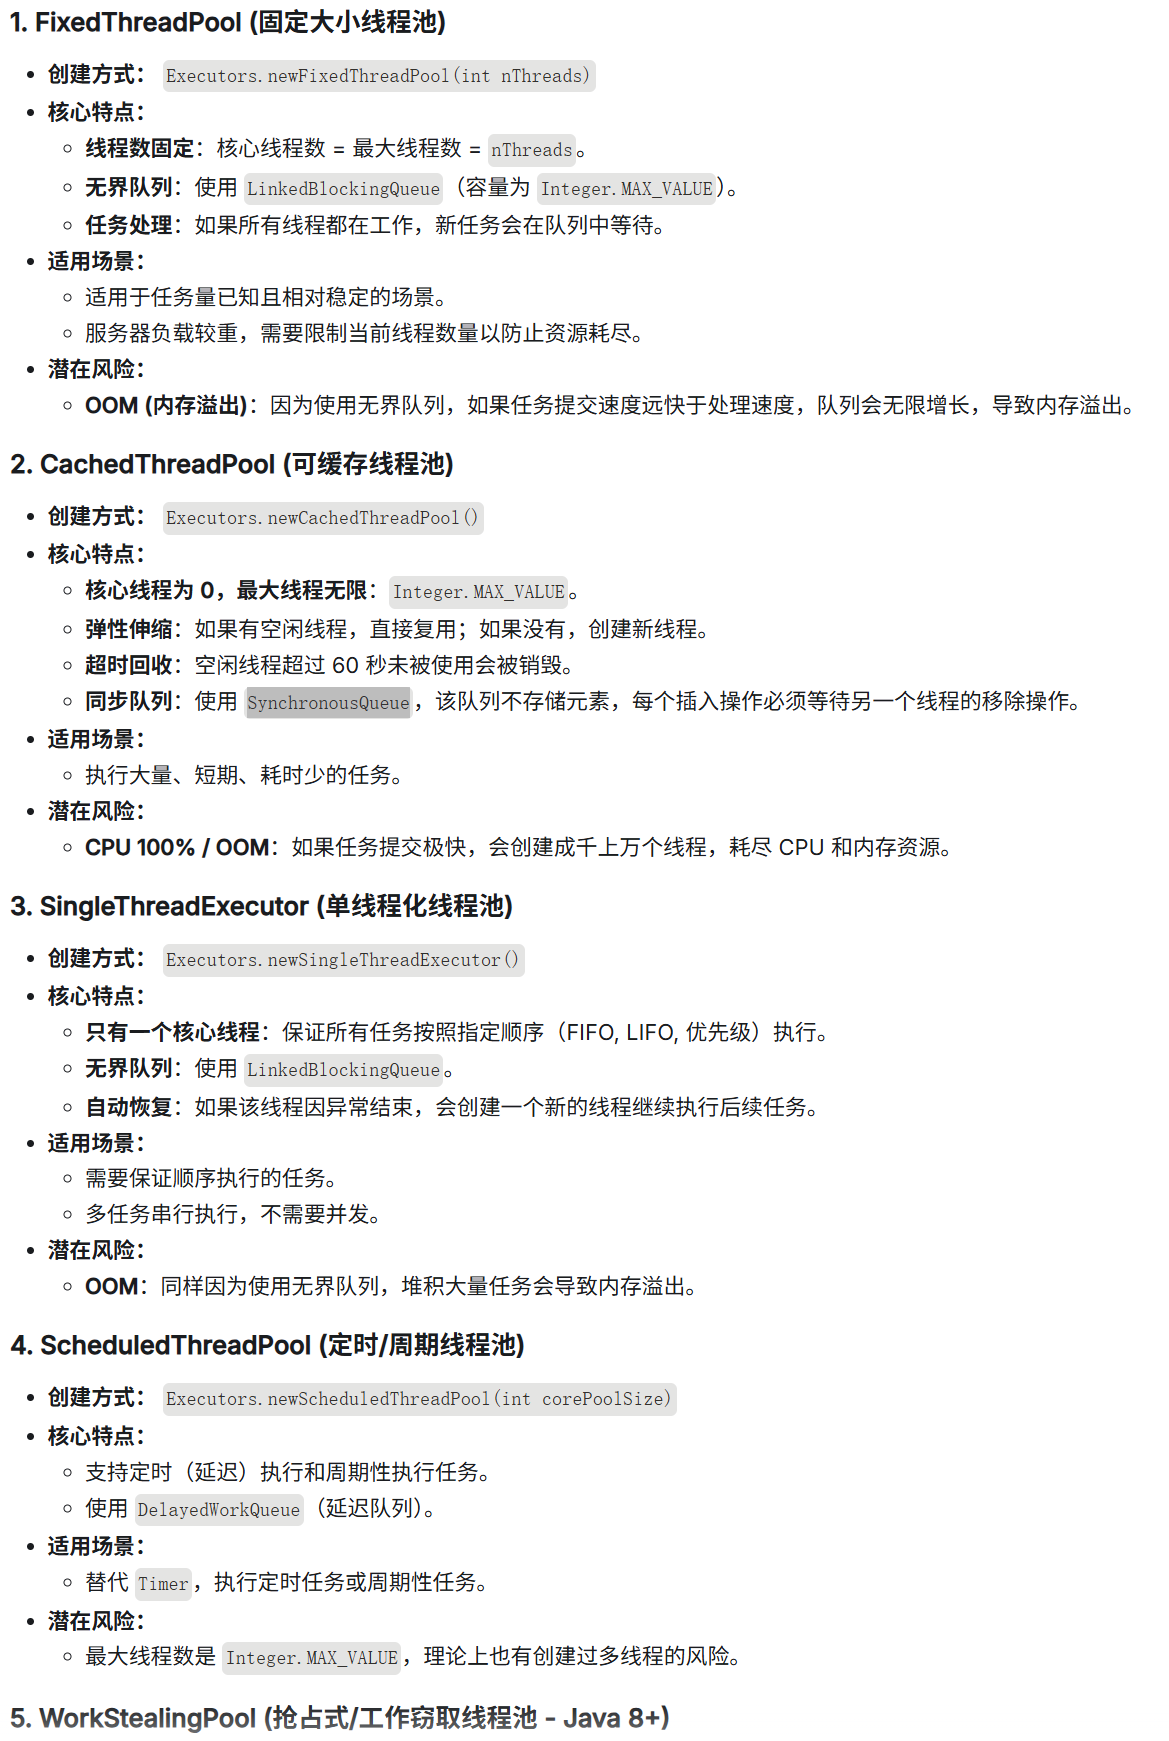
    image-20251223225602424

5.线程池的原理分析

为了搞懂线程池的原理,我们需要首先分析一下 execute方法。 在示例代码中,我们使用 executor.execute(worker)来提交一个任务到线程池中去。

这个方法非常重要,下面我们来看看它的源码:

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
// 存放线程池的运行状态 (runState) 和线程池内有效线程的数量 (workerCount)
private final AtomicInteger ctl = new AtomicInteger(ctlOf(RUNNING, 0));

private static int workerCountOf(int c) {
return c & CAPACITY;
}
//任务队列
private final BlockingQueue<Runnable> workQueue;

public void execute(Runnable command) {
// 如果任务为null,则抛出异常。
if (command == null)
throw new NullPointerException();
// ctl 中保存的线程池当前的一些状态信息
int c = ctl.get();

// 下面会涉及到 3 步 操作
// 1.首先判断当前线程池中执行的任务数量是否小于 corePoolSize
// 如果小于的话,通过addWorker(command, true)新建一个线程,并将任务(command)添加到该线程中;然后,启动该线程从而执行任务。
if (workerCountOf(c) < corePoolSize) {
if (addWorker(command, true))
return;
c = ctl.get();
}
// 2.如果当前执行的任务数量大于等于 corePoolSize 的时候就会走到这里,表明创建新的线程失败。
// 通过 isRunning 方法判断线程池状态,线程池处于 RUNNING 状态并且队列可以加入任务,该任务才会被加入进去
if (isRunning(c) && workQueue.offer(command)) {
int recheck = ctl.get();
// 再次获取线程池状态,如果线程池状态不是 RUNNING 状态就需要从任务队列中移除任务,并尝试判断线程是否全部执行完毕。同时执行拒绝策略。
if (!isRunning(recheck) && remove(command))
reject(command);
// 如果当前工作线程数量为0,新创建一个线程并执行。
else if (workerCountOf(recheck) == 0)
addWorker(null, false);
}
//3. 通过addWorker(command, false)新建一个线程,并将任务(command)添加到该线程中;然后,启动该线程从而执行任务。
// 传入 false 代表增加线程时判断当前线程数是否少于 maxPoolSize
//如果addWorker(command, false)执行失败,则通过reject()执行相应的拒绝策略的内容。
else if (!addWorker(command, false))
reject(command);
}

这里简单分析一下整个流程(对整个逻辑进行了简化,方便理解):

  1. 如果当前运行的线程数小于核心线程数,那么就会新建一个线程来执行任务。
  2. 如果当前运行的线程数等于或大于核心线程数,但是小于最大线程数,那么就把该任务放入到任务队列里等待执行。
  3. 如果向任务队列投放任务失败(任务队列已经满了),但是当前运行的线程数是小于最大线程数的,就新建一个线程来执行任务。
  4. 如果当前运行的线程数已经等同于最大线程数了,新建线程将会使当前运行的线程超出最大线程数,那么当前任务会被拒绝,拒绝策略会调用RejectedExecutionHandler.rejectedExecution()方法。
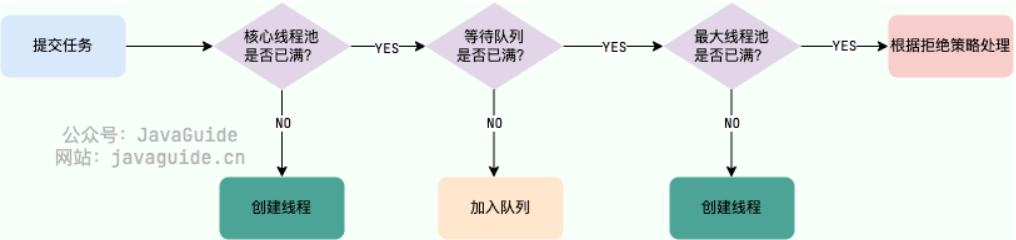
image-20260410162114504

execute 方法中,多次调用 addWorker 方法。addWorker 这个方法主要用来创建新的工作线程,如果返回 true 说明创建和启动工作线程成功,否则的话返回的就是 false。

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42
43
44
45
46
47
48
49
50
51
52
53
54
55
56
57
58
59
60
61
62
63
64
65
66
67
68
69
70
71
72
73
74
75
76
77
78
79
80
81
82
83
84
85
86
87
88
89
90
91
92
93
94
95
96
97
98
99
100
 // 全局锁,并发操作必备
private final ReentrantLock mainLock = new ReentrantLock();
// 跟踪线程池的最大大小,只有在持有全局锁mainLock的前提下才能访问此集合
private int largestPoolSize;
// 工作线程集合,存放线程池中所有的(活跃的)工作线程,只有在持有全局锁mainLock的前提下才能访问此集合
private final HashSet<Worker> workers = new HashSet<>();
//获取线程池状态
private static int runStateOf(int c) { return c & ~CAPACITY; }
//判断线程池的状态是否为 Running
private static boolean isRunning(int c) {
return c < SHUTDOWN;
}


/**
* 添加新的工作线程到线程池
* @param firstTask 要执行
* @param core参数为true的话表示使用线程池的基本大小,为false使用线程池最大大小
* @return 添加成功就返回true否则返回false
*/
private boolean addWorker(Runnable firstTask, boolean core) {
retry:
for (;;) {
//这两句用来获取线程池的状态
int c = ctl.get();
int rs = runStateOf(c);

// Check if queue empty only if necessary.
if (rs >= SHUTDOWN &&
! (rs SHUTDOWN &&
firstTask
null &&
! workQueue.isEmpty()))
return false;

for (;;) {
//获取线程池中工作的线程的数量
int wc = workerCountOf(c);
// core参数为false的话表明队列也满了,线程池大小变为 maximumPoolSize
if (wc >= CAPACITY ||
wc >= (core ? corePoolSize : maximumPoolSize))
return false;
//原子操作将workcount的数量加1
if (compareAndIncrementWorkerCount(c))
break retry;
// 如果线程的状态改变了就再次执行上述操作
c = ctl.get();
if (runStateOf(c) != rs)
continue retry;
// else CAS failed due to workerCount change; retry inner loop
}
}
// 标记工作线程是否启动成功
boolean workerStarted = false;
// 标记工作线程是否创建成功
boolean workerAdded = false;
Worker w = null;
try {

w = new Worker(firstTask);
final Thread t = w.thread;
if (t != null) {
// 加锁
final ReentrantLock mainLock = this.mainLock;
mainLock.lock();
try {
//获取线程池状态
int rs = runStateOf(ctl.get());
//rs < SHUTDOWN 如果线程池状态依然为RUNNING,并且线程的状态是存活的话,就会将工作线程添加到工作线程集合中
//(rs=SHUTDOWN && firstTask == null)如果线程池状态小于STOP,也就是RUNNING或者SHUTDOWN状态下,同时传入的任务实例firstTask为null,则需要添加到工作线程集合和启动新的Worker
// firstTask == null证明只新建线程而不执行任务
if (rs < SHUTDOWN ||
(rs SHUTDOWN && firstTask null)) {
if (t.isAlive()) // precheck that t is startable
throw new IllegalThreadStateException();
workers.add(w);
//更新当前工作线程的最大容量
int s = workers.size();
if (s > largestPoolSize)
largestPoolSize = s;
// 工作线程是否启动成功
workerAdded = true;
}
} finally {
// 释放锁
mainLock.unlock();
}
//// 如果成功添加工作线程,则调用Worker内部的线程实例t的Thread#start()方法启动真实的线程实例
if (workerAdded) {
t.start();
/// 标记线程启动成功
workerStarted = true;
}
}
} finally {
// 线程启动失败,需要从工作线程中移除对应的Worker
if (! workerStarted)
addWorkerFailed(w);
}
return workerStarted;
}

6.几种常见的对比:

6.1Runnable与Callable

Runnable自 Java 1.0 以来一直存在,但Callable仅在 Java 1.5 中引入,目的就是为了来处理Runnable不支持的用例。Runnable 接口不会返回结果或抛出检查异常,但是 Callable 接口可以。所以,如果任务不需要返回结果或抛出异常推荐使用 Runnable 接口,这样代码看起来会更加简洁。

工具类 Executors 可以实现将 Runnable 对象转换成 Callable 对象。(Executors.callable(Runnable task)Executors.callable(Runnable task, Object result))。

6.2 execute() vs submit()

execute()submit()是两种提交任务到线程池的方法,有一些区别:

  • 返回值execute() 方法用于提交不需要返回值的任务。通常用于执行 Runnable 任务,无法判断任务是否被线程池成功执行。submit() 方法用于提交需要返回值的任务。可以提交 RunnableCallable 任务。submit() 方法返回一个 Future 对象,通过这个 Future 对象可以判断任务是否执行成功,并获取任务的返回值(get()方法会阻塞当前线程直到任务完成, get(long timeout,TimeUnit unit)多了一个超时时间,如果在 timeout 时间内任务还没有执行完,就会抛出 java.util.concurrent.TimeoutException)。
  • 异常处理:在使用 submit() 方法时,可以通过 Future 对象处理任务执行过程中抛出的异常;而在使用 execute() 方法时,异常处理需要通过自定义的 ThreadFactory (在线程工厂创建线程的时候设置UncaughtExceptionHandler对象来 处理异常)或 ThreadPoolExecutorafterExecute() 方法来处理

7.几种常见的内置线程池

7.1FixedThreadPool

FixedThreadPool 被称为可重用固定线程数的线程池。通过 Executors 类中的相关源代码来看一下相关实现:

1
2
3
4
5
6
7
8
9
/**
* 创建一个可重用固定数量线程的线程池
*/
public static ExecutorService newFixedThreadPool(int nThreads, ThreadFactory threadFactory) {
return new ThreadPoolExecutor(nThreads, nThreads,
0L, TimeUnit.MILLISECONDS,
new LinkedBlockingQueue<Runnable>(),
threadFactory);
}

7.2 SingleThreadExecutor

SingleThreadExecutor 是只有一个线程的线程池。下面看看SingleThreadExecutor 的实现:

1
2
3
4
5
6
7
8
9
10
/**
*返回只有一个线程的线程池
*/
public static ExecutorService newSingleThreadExecutor(ThreadFactory threadFactory) {
return new FinalizableDelegatedExecutorService
(new ThreadPoolExecutor(1, 1,
0L, TimeUnit.MILLISECONDS,
new LinkedBlockingQueue<Runnable>(),
threadFactory));
}

7.3 CachedThreadPool

CachedThreadPool 是一个会根据需要创建新线程的线程池。下面通过源码来看看 CachedThreadPool 的实现:

1
2
3
4
5
6
7
8
9
/**
* 创建一个线程池,根据需要创建新线程,但会在先前构建的线程可用时重用它。
*/
public static ExecutorService newCachedThreadPool(ThreadFactory threadFactory) {
return new ThreadPoolExecutor(0, Integer.MAX_VALUE,
60L, TimeUnit.SECONDS,
new SynchronousQueue<Runnable>(),
threadFactory);
}

CachedThreadPoolcorePoolSize 被设置为空(0),maximumPoolSize被设置为 Integer.MAX.VALUE,即它是无界的,这也就意味着如果主线程提交任务的速度高于 maximumPool 中线程处理任务的速度时,CachedThreadPool 会不断创建新的线程。极端情况下,这样会导致耗尽 cpu 和内存资源。

8.建议不同类别的业务用不同的线程池

很多人在实际项目中都会有类似这样的问题:我的项目中多个业务需要用到线程池,是为每个线程池都定义一个还是说定义一个公共的线程池呢?

一般建议是不同的业务使用不同的线程池,配置线程池的时候根据当前业务的情况对当前线程池进行配置,因为不同的业务的并发以及对资源的使用情况都不同,重心优化系统性能瓶颈相关的业务。

试想这样一种极端情况:假如我们线程池的核心线程数为 n,父任务(扣费任务)数量为 n,父任务下面有两个子任务(扣费任务下的子任务),其中一个已经执行完成,另外一个被放在了任务队列中。由于父任务把线程池核心线程资源用完,所以子任务因为无法获取到线程资源无法正常执行,一直被阻塞在队列中。父任务等待子任务执行完成,而子任务等待父任务释放线程池资源,这也就造成了 “死锁”

9.正确配置线程池参数

很多人甚至可能都会觉得把线程池配置过大一点比较好!我觉得这明显是有问题的。就拿我们生活中非常常见的一例子来说:并不是人多就能把事情做好,增加了沟通交流成本。你本来一件事情只需要 3 个人做,你硬是拉来了 6 个人,会提升做事效率嘛?我想并不会。 线程数量过多的影响也是和我们分配多少人做事情一样,对于多线程这个场景来说主要是增加了上下文切换 成本。不清楚什么是上下文切换的话,可以看我下面的介绍。

类比于现实世界中的人类通过合作做某件事情,我们可以肯定的一点是线程池大小设置过大或者过小都会有问题,合适的才是最好。

  • 如果我们设置的线程池数量太小的话,如果同一时间有大量任务/请求需要处理,可能会导致大量的请求/任务在任务队列中排队等待执行,甚至会出现任务队列满了之后任务/请求无法处理的情况,或者大量任务堆积在任务队列导致 OOM。这样很明显是有问题的,CPU 根本没有得到充分利用。
  • 如果我们设置线程数量太大,大量线程可能会同时在争取 CPU 资源,这样会导致大量的上下文切换,从而增加线程的执行时间,影响了整体执行效率。

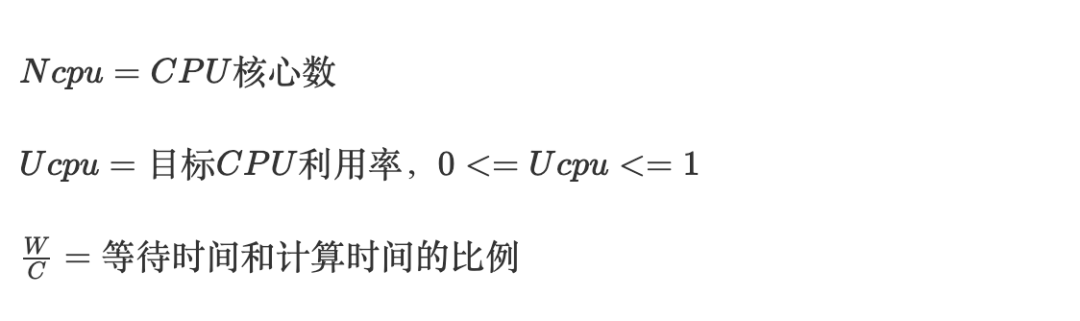
CPU 密集型任务 (N): 这种任务消耗的主要是 CPU 资源,线程数应设置为 N(CPU 核心数), 最大线程数=核心线程数,堵塞队列开小一些。由于任务主要瓶颈在于 CPU 计算能力,与核心数相等的线程数能够最大化 CPU 利用率,过多线程反而会导致竞争和上下文切换开销。

I/O 密集型任务(M * N): 这类任务大部分时间处理 I/O 交互,线程在等待 I/O 时不占用 CPU。 为了充分利用 CPU 资源,线程数可以设置为 M * N,其中 N 是 CPU 核心数,M 是一个大于 1 的倍数,建议默认设置为 2 ,具体取值取决于 I/O 等待时间和任务特点,需要通过测试和监控找到最佳平衡点,最大线程数。

线程数规划的公式
isibdx7hhl 1

如果希望程序跑到CPU的目标利用率,需要的线程数公式为:

99ehbz0421

场景一:高并发、低延迟的核心在线业务(如交易、下单)

  • 特征:用户在屏幕前苦等,响应时间是生命线。
  • 策略设置一个较短的有界队列(Bounded Queue,如 ArrayBlockingQueue)。
  • 长度:比如设置为 核心线程数的 1~2 倍
  • 原因:如果队列设置过长,任务在队列里排队 10 秒才被执行,用户早就超时刷新了。此时,与其让任务在队列里“假死”,不如快速失败(Fail-Fast)。当短队列也满了,立刻触发拒绝策略(Rejection Policy),让前端明确知道“系统繁忙,请稍后再试”,或者让上游服务进行重试。这是一种主动的‘反压(Backpressure)’机制。

场景二:异步、高吞吐的离线/后台任务(如发通知、写日志、数据迁移)

  • 特征:任务可以容忍一定的延迟,关键是别丢,最终能处理完就行。
  • 策略可以设置一个较长的有界队列。
  • 长度:可以大胆设置为核心线程数的几十甚至上百倍,但必须严格评估内存占用。
  • 原因:较长的队列能极大提升系统的吞吐量,充分利用 CPU 和 I/O 资源,避免因为线程频繁创建销毁带来的开销。但必须严防内存溢出(OOM)

线程池的类型(java中常见的六种线程池详解 - AnonyStar - 博客园),子线程除了异常怎么捕获(字节二面:线程池中线程抛了异常,该如何处理?-腾讯云开发者社区-腾讯云),线程池关闭的方式有哪些?有什么区别?

一,子线程出异常怎么捕获

在Java的ExecutorService接口中,提交任务给线程池主要有两种方式:execute(Runnable command)submit(Callable<T> task)。这两种方式在异常处理上有显著的不同:

  • execute(Runnable command): 当使用execute方法提交Runnable任务时,如果任务执行过程中抛出未检查异常(unchecked exception),这些异常将不会被线程池捕获,而是直接传播给任务执行所在的线程。由于这些异常没有在调用者线程中抛出,因此调用者通常无法直接感知到这些异常的发生。
  • submit(Callable task): 相比之下,submit方法用于提交Callable任务,它能够返回Future对象,代表异步计算的结果。如果Callable任务执行过程中抛出异常,这个异常会被封装成ExecutionException,并在调用Future.get()方法时抛出。这样,调用者就可以通过捕获ExecutionException来获取到任务执行时抛出的原始异常。

二、处理线程池中的异常

  1. 对于execute提交的任务
    • 可以在任务内部使用try-catch块来捕获并处理异常,或者使用日志框架记录异常信息。
    • 考虑使用自定义的使用Thread.setDefaultUncaughtExceptionHandler方法捕获异常来处理未捕获的异常。通过线程池的setUncaughtExceptionHandler方法设置异常处理器,可以在线程因未捕获异常而终止时,执行自定义的异常处理逻辑。
      • UncaughtExceptionHandler 是Thread类一个内部类,也是一个函数式接口。内部的uncaughtException是一个处理线程内发生的异常的方法,参数为线程对象t和异常对象e。
  1. 对于submit提交的任务
    • 调用Future.get()方法时,确保捕获并处理ExecutionException,从中获取并处理原始异常。
    • 同样,也可以使用日志框架记录异常信息,以便于问题追踪和调试。

三,线程池关闭的方法

  • 第一种方法叫作 shutdown(),它可以安全地关闭一个线程池,调用 shutdown() 方法之后线程池并不是立刻就被关闭,因为这时线程池中可能还有很多任务正在被执行,或是任务队列中有大量正在等待被执行的任务,调用 shutdown() 方法后线程池会在执行完正在执行的任务队列中等待的任务后才彻底关闭。但这并不代表 shutdown() 操作是没有任何效果的,调用 shutdown() 方法后如果还有新的任务被提交,线程池则会根据拒绝策略直接拒绝后续新提交的任务。

  • awaitTermination(),它本身并不是用来关闭线程池的,而是主要用来判断线程池状态的。比如我们给 awaitTermination 方法传入的参数是 10 秒,那么它就会陷入 10 秒钟的等待,直到发生以下三种情况之一:

    1. 等待期间(包括进入等待状态之前)线程池已关闭并且所有已提交的任务(包括正在执行的和队列中等待的)都执行完毕,相当于线程池已经“终结”了,方法便会返回 true;
    2. 等待超时时间到后,第一种线程池“终结”的情况始终未发生,方法返回 false;
    3. 等待期间线程被中断,方法会抛出 InterruptedException 异常。

    也就是说,调用 awaitTermination 方法后当前线程会尝试等待一段指定的时间,如果在等待时间内,线程池已关闭并且内部的任务都执行完毕了,也就是说线程池真正“终结”了,那么方法就返回 true,否则超时返回 fasle。

    我们则可以根据 awaitTermination() 返回的布尔值来判断下一步应该执行的操作。

  • shutdownNow():它与第一种 shutdown 方法不同之处在于名字中多了一个单词 Now,也就是表示立刻关闭的意思。在执行 shutdownNow 方法之后,首先会给所有线程池中的线程发送 interrupt 中断信号,尝试中断这些任务的执行,然后会将任务队列中正在等待的所有任务转移到一个 List 中并返回,我们可以根据返回的任务 List 来进行一些补救的操作,

synchronized和reentrantlock的区别

1.底层实现

底层实现上来说,synchronized 是 JVM 层面的锁,是 Java 关键字,通过 monitor 对象来完成(monitorenter 与 monitorexit),对象只有在同步块或同步方法中才能调用 wait / notify 方法,ReentrantLock 是从 jdk1.5 以提供的 API 层面的锁。

synchronized 的实现涉及到锁的升级,具体为无锁、偏向锁、自旋锁、向 OS 申请重量级锁,ReentrantLock 实现则是通过利用CAS(CompareAndSwap)自旋机制保证线程操作的原子性和 volatile 保证数据可见性以实现锁的功能。

2.是否可以手动释放

synchronized 不需要用户去手动释放锁,synchronized 代码执行完后系统会自动让线程释放对锁的占用。

ReentrantLock 则需要用户去手动释放锁,如果没有手动释放锁,就可能导致死锁现象。一般通过 lock() 和 unlock() 方法配合 try / finally 语句块来完成,使用释放更加灵活。

3.是否可中断
synchronized 是不可中断类型的锁,除非加锁的代码中出现异常或正常执行完成。

ReentrantLock 则可以中断,可通过 trylock(long timeout,TimeUnit unit) 设置超时方法;或者将 lockInterruptibly() 放到代码块中,调用 interrupt 方法进行中断。

4.是否为公平锁

synchronized 为非公平锁。

ReentrantLock 则即可以选公平锁也可以选非公平锁,通过构造方法 new ReentrantLock 时传入 boolean 值进行选择,为空默认 false 非公平锁,true 为公平锁。

5.锁是否可绑定条件 Condition实现线程间的合作

synchronized 不能绑定。

ReentrantLock 通过绑定 Condition 结合 await() / singal() 方法实现线程的精确唤醒,而不是像 synchronized 通过 Object 类的 wait() / notify() / notifyAll() 方法要么随机唤醒一个线程要么唤醒全部线程。

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42
43
44
45
46
47
48
49
50
51
52
53
54
55
56
57
58
59
60
61
62
63
64
65
66
67
68
69
70
71
72
73
74
75
76
77
78
79
80
81
82
83
84
85
86
87
88
89
90
91
92
93
94
95
96
97
98
99
100
101
102
103
104
105
106
107
108
109
110
111
示例:用ReentrantLock绑定三个条件实现线程A打印一次1,线程B打印两次2,线程C打印三次3
class Resource {
private int number = 1;//A:1 B:2 C:3
private Lock lock = new ReentrantLock();
private Condition c1 = lock.newCondition();
private Condition c2 = lock.newCondition();
private Condition c3 = lock.newCondition();

//1 判断
public void print1() {

lock.lock();

try {
//判断
while (number != 1) {
c1.await();//等待自动释放锁
}
//2 do sth
for (int i = 1; i < 2; i++) {
System.out.println(Thread.currentThread().getName() + "\t" + number);
}

//3 通知
number = 2;
c2.signal();
} catch (Exception e) {
e.printStackTrace();
} finally {
lock.unlock();
}
}

//1 判断
public void print2() {

lock.lock();

try {
//判断
while (number != 2) {
c2.await();
}
//2 do sth
for (int i = 1; i < 3; i++) {
System.out.println(Thread.currentThread().getName() + "\t" + number);
}

//3 通知
number = 3;
c3.signal();
} catch (Exception e) {
e.printStackTrace();
} finally {
lock.unlock();
}
}

//1 判断
public void print3() {

lock.lock();

try {
//判断
while (number != 3) {
c3.await();
}
//2 do sth
for (int i = 1; i < 4; i++) {
System.out.println(Thread.currentThread().getName() + "\t" + number);
}

//3 通知
number = 1;
c1.signal();
} catch (Exception e) {
e.printStackTrace();
} finally {
lock.unlock();
}
}
}

public static void main(String[] args) {

Resource resource = new Resource();

new Thread(()->{
for (int i = 1; i <= 2; i++) {
resource.print1();
}
},"A").start();


new Thread(()->{
for (int i = 1; i <= 2; i++) {
resource.print2();
}
},"B").start();


new Thread(()->{
for (int i = 1; i <= 2; i++) {
resource.print3();
}
},"C").start();


}

6.锁的对象

synchronzied 锁的是对象,锁是保存在对象头里面的,根据对象头数据来标识是否有线程获得锁 / 争抢锁。

ReentrantLock 锁的是线程,根据进入的线程和 int 类型的 state 标识锁的获得 / 争抢。

7.为什么推荐 ReentrantLock 而不是 Synchronized?

其实 ReentrantLock 和 Synchronized 最核心的区别就在于 Synchronized 适合于并发竞争低的情况,因为 Synchronized 的锁升级如果最终升级为重量级锁在使用的过程中是没有办法消除的,意味着每次都要和 cpu 去请求锁资源,而 ReentrantLock 主要是提供了阻塞的能力,通过在高并发下线程的挂起,来减少竞争,提高并发能力,

##reentrantlock的底层实现,初始化传入的布尔值有什么用

##syn锁唤醒的过程

假设有两个线程 A 和 B,它们都尝试进入 synchronized 修饰的临界区(方法或代码块):

▶️ 1. 线程 A 获取锁

  • 线程 A 成功获取对象 O 的 monitor。
  • 线程 A 进入临界区执行代码。

⏸ 2. 线程 B 尝试获取锁,失败

  • 对象 O 的 monitor 已被 A 占用。
  • 线程 B 被放入 O 对象的 EntryList(等待队列) 中。
  • B 状态变为 Blocked(阻塞状态)。

✅ 3. 线程 A 执行完毕,释放锁

  • A 退出 synchronized 块,JVM 调用 monitorexit 指令。
  • A 释放对象 O 的 monitor。

🔔 4. JVM 从 EntryList 中唤醒一个等待线程

  • JVM 会从 EntryList 中 选择一个线程 B(通常是 FIFO,但不保证顺序)
  • 将 B 移动到 可运行状态(Ready)
  • B 会重新尝试获取 monitor。

Java 8中Stream的并行处理原理?ForkJoinPool工作窃取机制?

第一部分:Java 8 Stream 的并行处理原理

当我们调用 collection.parallelStream() 或 stream.parallel() 时,Stream 的处理方式会发生根本性变化。其核心原理可以总结为:“拆分(Split) -> 并行执行(Execute) -> 合并(Combine)”

1. 核心抽象:Spliterator(可拆分迭代器)

普通的 Iterator 只能顺序遍历,而 Spliterator 是专为并行设计的。

  • trySplit() 方法:负责将当前的数据源切分成两部分,返回一个新的 Spliterator。如果数据不能再拆分或太小没必要拆分,则返回 null。
  • 不同数据结构的拆分效率:ArrayList 非常容易按索引劈成两半,拆分效率极高;而 LinkedList 需要遍历才能找到中间节点,拆分效率极低,因此不推荐在 LinkedList 上使用并行流。

2. 分治架构(Divide and Conquer)

并行流会将数据源通过 Spliterator 递归地拆分成多个子任务,直到子任务足够小。

  • 拆分阶段:将大任务拆分为小任务。
  • 执行阶段:将这些小任务提交给后台的线程池并行处理。
  • 合并阶段:如果是 reduce、collect 等归约操作,框架会将各个子任务的计算结果逐步合并,最终汇总成一个总结果。

3. 默认执行引擎:公共线程池(Common ForkJoinPool)

Java 8 会默认使用 ForkJoinPool.commonPool() 来执行所有的并行流任务。

  • 这个线程池是全局共享的。
  • 默认的并发线程数等于 CPU 核心数 - 1(保留一个核心给主线程)。可以通过 -Djava.util.concurrent.ForkJoinPool.common.parallelism=N 来修改。

第二部分:ForkJoinPool 与工作窃取机制(Work-Stealing)

ForkJoinPool 是 Java 7 引入的,专为CPU密集型分治任务设计的线程池。它的灵魂所在就是工作窃取机制

1. 为什么需要工作窃取?

在传统线程池中,所有线程共享一个阻塞队列。当并发量大时,所有线程都在竞争同一把锁去获取任务,导致严重的上下文切换和性能瓶颈。
此外,在分治任务中,有的子任务可能很快执行完,有的则很慢,这会导致部分线程空闲(饥饿),部分线程忙死。

2. 工作窃取的核心数据结构:双端队列(Deque)

在 ForkJoinPool 中,每个工作线程(ForkJoinWorkerThread)都有一个属于自己的双端队列(WorkQueue)。

任务的调度完全围绕这个双端队列展开,遵循以下两个核心规则:

  • 本地线程操作(LIFO - 后进先出):
    • 工作线程在处理任务时,如果任务(Fork)出新的子任务,会把子任务压入自己队列的队尾(Top/Head)
    • 工作线程自己取任务执行时,也是从**自己队列的队尾(Top/Head)**获取。
    • 为什么用 LIFO? 因为越晚创建的子任务通常越小,且数据在 CPU 缓存中更“热”(局部性原理),执行效率更高。
  • 窃取其他线程任务(FIFO - 先进先出):
    • 当一个工作线程自己的队列空了(闲下来了),它不会休息,而是随机挑选一个其他忙碌线程的队列。
    • 它会从那个被窃取线程的队首(Base/Tail)“偷”一个任务来执行。
    • 为什么用 FIFO?
      1. 队首的任务通常是比较早创建的、未被拆分的大任务,偷走一个大任务可以减少以后再次窃取的次数。
      2. 减少竞争:主人从队尾拿任务,窃取者从队首拿任务,一头一尾互不干扰,绝大多数情况下不需要加锁(通过 CAS 操作即可保证线程安全)。

3. 工作窃取的执行流程图解

假设有线程 A 和线程 B:

  1. 线程 A 拿到一个大任务,拆分成子任务 1 和 2,放到自己的队列。
  2. 线程 A 从队尾取出任务 2 继续拆分或执行。
  3. 线程 B 自己的任务执行完了,处于空闲状态。
  4. 线程 B 扫描发现线程 A 的队列里有任务。
  5. 窃取发生:线程 B 从线程 A 的队列**底部(队首)**偷走了任务 1,拿去执行。
  6. 这样 A 和 B 都在全速运行,最大化利用了 CPU。

它是如何运行的?(结合工作窃取机制)

假设我们的电脑有 4 个 CPU 核心,ForkJoinPool 创建了 4 个工作线程(W1, W2, W3, W4)。

  1. 初始提交:
    • main 线程调用 forkJoinPool.invoke(mainTask),将 mainTask(计算 0 到 1000 万)提交到池中。
    • 一个工作线程,比如 W1,从公共队列中获取了这个 mainTask 并开始执行它的 compute() 方法。
  2. 第一次拆分 (在 W1 中):
    • W1 发现任务太大(1000 万 > 1000)。
    • 它创建了 leftTask (0 - 500 万) 和 rightTask (500 万 - 1000 万)。
    • W1 调用 leftTask.fork(),将 leftTask 压入 W1 自己的工作队列的顶部
    • W1 自己继续执行 rightTask.compute()。
  3. 工作窃取发生:
    • 此时,W2 发现自己的队列是空的,它是个“空闲”的线程。
    • W2 变成一个窃取者,它随机扫描其他线程的队列。它发现了 W1 的队列里有任务。
    • W2 从 W1 队列的底部“偷”走了 leftTask (0 - 500 万) 并开始执行。
  4. 并行拆分:
    • 现在 W1 和 W2 在并行工作!
    • W1 正在处理 rightTask (500 万 - 1000 万)。它发现这个任务还是太大,于是又拆分成 (500-750万) 和 (750-1000万)。它 fork (500-750万) 任务到自己的队列,然后自己计算 (750-1000万) 的任务。
    • W2 正在处理 leftTask (0 - 500 万)。它也发现任务太大,拆分成 (0-250万) 和 (250-500万)。它 fork (0-250万) 任务到它自己的队列,然后自己计算 (250-500万) 的任务。
  5. 持续拆分与窃取:
    • 现在 W1 和 W2 的队列里都有了新任务。空闲的 W3 和 W4 马上就会过来窃取它们。
    • 这个过程会像一棵树一样迅速展开,所有 4 个线程都很快会领到任务,并不断地将任务拆分,直到任务大小小于 THRESHOLD。
  6. 到达基本情况与计算:
    • 当一个线程(比如 W3)拿到了一个大小为 1000 的小任务(例如计算 10000 到 11000),它会进入 if 分支,停止拆分,直接用 for 循环计算出这个小范围的和,然后返回结果。
  7. Join 与结果合并:
    • 当一个任务的子任务都计算完成后,join() 操作会得到结果。
    • 例如,W2 在等待 (0-250万) 的 join() 结果,这个结果可能是由 W4 计算并返回的。一旦拿到结果,W2 就会把它和自己计算的 (250-500万) 的结果相加,得到 (0-500万) 的总和。
    • 这个合并过程会沿着任务树自下而上地进行,最终,最初的 mainTask 会合并所有子任务的结果,得到最终的总和。
  8. 最终返回:
    • 当 mainTask 计算出最终结果后,invoke() 调用结束阻塞,将结果返回给 main 线程。

乐观锁和悲观锁

1.悲观锁总是假设最坏的情况,认为共享资源每次被访问的时候就会出现问题(比如共享数据被修改),所以每次在获取资源操作的时候都会上锁,这样其他线程想拿到这个资源就会阻塞直到锁被上一个持有者释放。也就是说,共享资源每次只给一个线程使用,其它线程阻塞,用完后再把资源转让给其它线程

像 Java 中synchronizedReentrantLock等独占锁就是悲观锁思想的实现。

2.乐观锁总是假设最好的情况,认为共享资源每次被访问的时候不会出现问题,线程可以不停地执行,无需加锁也无需等待,只是在提交修改的时候去验证对应的资源(也就是数据)是否被其它线程修改了(具体方法可以使用版本号机制或 CAS 算法)。

1
2
3
4
// LongAdder 在高并发场景下会比 AtomicInteger 和 AtomicLong 的性能更好
// 代价就是会消耗更多的内存空间(空间换时间)
LongAdder sum = new LongAdder();
sum.increment();

在 Java 中java.util.concurrent.atomic包下面的原子变量类(比如AtomicIntegerLongAdder)就是使用了乐观锁的一种实现方式 CAS 实现的。

高并发的场景下,乐观锁相比悲观锁来说,不存在锁竞争造成线程阻塞,也不会有死锁问题,在性能上往往会更胜一筹。但是,如果冲突频繁发生(写占比非常多的情况),会频繁失败并重试,这样同样会非常影响性能,导致 CPU 飙升。

理论上来说:

  • 悲观锁通常多用于写比较多的情况(多写场景,竞争激烈),这样可以避免频繁失败和重试影响性能,悲观锁的开销是固定的。不过,如果乐观锁解决了频繁失败和重试这个问题的话(比如LongAdder),也是可以考虑使用乐观锁的,要视实际情况而定。
  • 乐观锁通常多用于写比较少的情况(多读场景,竞争较少),这样可以避免频繁加锁影响性能。不过,乐观锁主要针对的对象是单个共享变量(参考java.util.concurrent.atomic包下面的原子变量类)。

#java有哪些锁?ReentrantLock是怎么保证线程安全的

1.synchronized 关键字:

  • 类型: 悲观锁,非公平锁,独占锁,可重入锁

  • 特点:

    • 内置锁: 由 JVM 提供,使用简单,隐式加锁和释放锁。
      互斥性: 保证同一时刻只有一个线程可以执行被 synchronized 修饰的代码块。
      可见性: 确保在释放锁之前,对共享变量的修改对其他线程可见。
      可重入性: 允许同一个线程多次获取同一个锁。
      非公平性: 线程获取锁的顺序是不确定的,可能导致某些线程长时间无法获取锁(饥饿)。
      自动释放: 无论正常执行完成还是抛出异常,锁都会自动释放。

2.Lock 接口及其实现类:

  • 类型: 悲观锁,可配置公平性,独占锁/共享锁,可重入锁
  • 特点:
    • 手动加锁/解锁: 需要显式调用 lock()unlock() 方法,灵活性更高。
    • 可中断: 可以使用 lockInterruptibly() 方法响应中断,避免线程长时间等待。
    • 可轮询: 可以使用 tryLock() 方法尝试获取锁,如果获取不到立即返回,避免阻塞。
    • 公平性选择: 可以创建公平锁,按照请求顺序获取锁,避免饥饿。

3. ReadWriteLock 接口及其实现类(ReentrantReadWriteLock)

  • 类型: 悲观锁,可配置公平性,共享锁(读锁)/独占锁(写锁),可重入锁
  • 特点:
    • 读写分离: 允许多个线程同时读取共享资源(读锁),但只允许一个线程写入共享资源(写锁)。
    • 读读共享: 多个线程可以同时持有读锁。
    • 读写互斥/写写互斥: 读锁和写锁、写锁和写锁之间互斥。
    • 提升并发性能: 适用于读多写少的场景,提高并发性能。

4. StampedLock (Java 8,乐观读锁,读的时候允许写,就是先读取,然后判断版本号,不对加悲观读锁,再读):

前面介绍的ReadWriteLock可以解决多线程同时读,但只有一个线程能写的问题。

如果我们深入分析ReadWriteLock,会发现它有个潜在的问题:如果有线程正在读,写线程需要等待读线程释放锁后才能获取写锁,即读的过程中不允许写,这是一种悲观的读锁。

要进一步提升并发执行效率,Java 8引入了新的读写锁:StampedLock

StampedLockReadWriteLock相比,改进之处在于:读的过程中也允许获取写锁后写入!这样一来,我们读的数据就可能不一致,所以,需要一点额外的代码来判断读的过程中是否有写入,这种读锁是一种乐观锁。

乐观锁的意思就是乐观地估计读的过程中大概率不会有写入,因此被称为乐观锁。反过来,悲观锁则是读的过程中拒绝有写入,也就是写入必须等待。显然乐观锁的并发效率更高,但一旦有小概率的写入导致读取的数据不一致,需要能检测出来,再读一遍就行。

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
public class Point {
private final StampedLock stampedLock = new StampedLock();

private double x;
private double y;

public void move(double deltaX, double deltaY) {
long stamp = stampedLock.writeLock(); // 获取写锁
try {
x += deltaX;
y += deltaY;
} finally {
stampedLock.unlockWrite(stamp); // 释放写锁
}
}

public double distanceFromOrigin() {
long stamp = stampedLock.tryOptimisticRead(); // 获得一个乐观读锁
// 注意下面两行代码不是原子操作
// 假设x,y = (100,200)
double currentX = x;
// 此处已读取到x=100,但x,y可能被写线程修改为(300,400)
double currentY = y;
// 此处已读取到y,如果没有写入,读取是正确的(100,200)
// 如果有写入,读取是错误的(100,400)
if (!stampedLock.validate(stamp)) { // 检查乐观读锁后是否有其他写锁发生
stamp = stampedLock.readLock(); // 获取一个悲观读锁
try {
currentX = x;
currentY = y;
} finally {
stampedLock.unlockRead(stamp); // 释放悲观读锁
}
}
return Math.sqrt(currentX * currentX + currentY * currentY);
}
}

ReadWriteLock相比,写入的加锁是完全一样的,不同的是读取。注意到首先我们通过tryOptimisticRead()获取一个乐观读锁,并返回版本号。接着进行读取,读取完成后,我们通过validate()去验证版本号,如果在读取过程中没有写入,版本号不变,验证成功,我们就可以放心地继续后续操作。如果在读取过程中有写入,版本号会发生变化,验证将失败。在失败的时候,我们再通过获取悲观读锁再次读取。由于写入的概率不高,程序在绝大部分情况下可以通过乐观读锁获取数据,极少数情况下使用悲观读锁获取数据。

可见,StampedLock把读锁细分为乐观读和悲观读,能进一步提升并发效率。但这也是有代价的:一是代码更加复杂,二是StampedLock是不可重入锁,不能在一个线程中反复获取同一个锁。

StampedLock还提供了更复杂的将悲观读锁升级为写锁的功能,它主要使用在if-then-update的场景:即先读,如果读的数据满足条件,就返回,如果读的数据不满足条件,再尝试写。

我要怎么指定顺序使用CompututableFuture? CompletableFuture 里的 all of 方法可以怎么实现

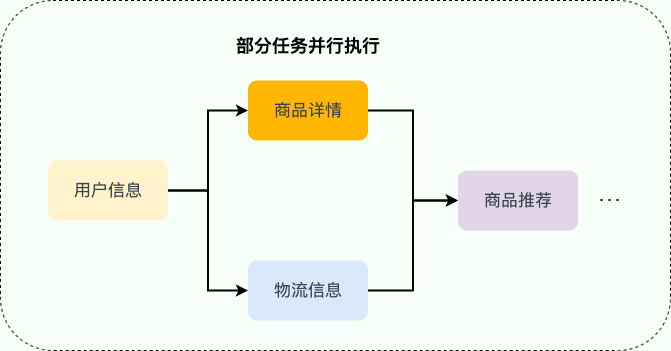
实际项目中,一个接口可能需要同时获取多种不同的数据,然后再汇总返回,这种场景还是挺常见的。举个例子:用户请求获取订单信息,可能需要同时获取用户信息、商品详情、物流信息、商品推荐等数据。

如果是串行(按顺序依次执行每个任务)执行的话,接口的响应速度会非常慢。考虑到这些任务之间有大部分都是 无前后顺序关联 的,可以 并行执行 ,就比如说调用获取商品详情的时候,可以同时调用获取物流信息。通过并行执行多个任务的方式,接口的响应速度会得到大幅优化。
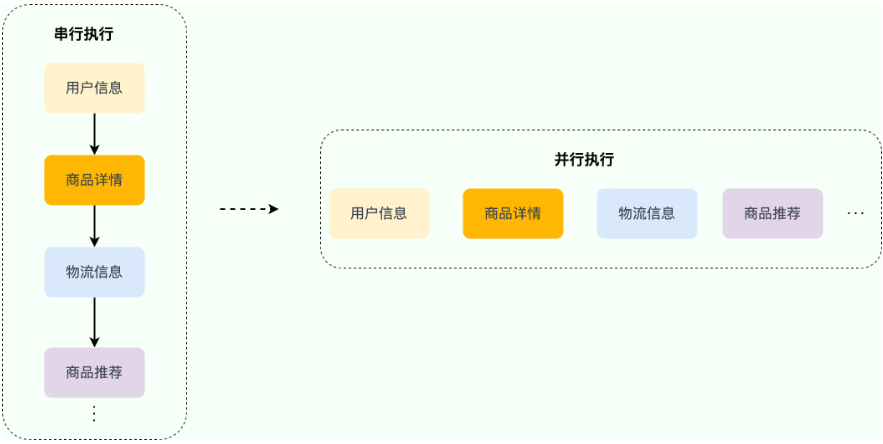
image-20260410162142920

对于存在前后调用顺序关系的任务,可以进行任务编排。

serial-to-parallel2

Future类介绍

Future 类是异步思想的典型运用,主要用在一些需要执行耗时任务的场景,避免程序一直原地等待耗时任务执行完成,执行效率太低。具体来说是这样的:当我们执行某一耗时的任务时,可以将这个耗时任务交给一个子线程去异步执行,同时我们可以干点其他事情,不用傻傻等待耗时任务执行完成。等我们的事情干完后,我们再通过 Future 类获取到耗时任务的执行结果。这样一来,程序的执行效率就明显提高了。

这其实就是多线程中经典的 Future 模式,你可以将其看作是一种设计模式,核心思想是异步调用,主要用在多线程领域,并非 Java 语言独有。

在 Java 中,Future 类只是一个泛型接口,位于 java.util.concurrent 包下,其中定义了 5 个方法,主要包括下面这 4 个功能:

  • 取消任务;
  • 判断任务是否被取消;
  • 判断任务是否已经执行完成;
  • 获取任务执行结果。
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
// V 代表了Future执行的任务返回值的类型
public interface Future<V> {
// 取消任务执行
// 成功取消返回 true,否则返回 false
boolean cancel(boolean mayInterruptIfRunning);
// 判断任务是否被取消
boolean isCancelled();
// 判断任务是否已经执行完成
boolean isDone();
// 获取任务执行结果
V get() throws InterruptedException, ExecutionException;
// 指定时间内没有返回计算结果就抛出 TimeOutException 异常
V get(long timeout, TimeUnit unit)

throws InterruptedException, ExecutionException, TimeoutExceptio

}

CompletableFuture介绍

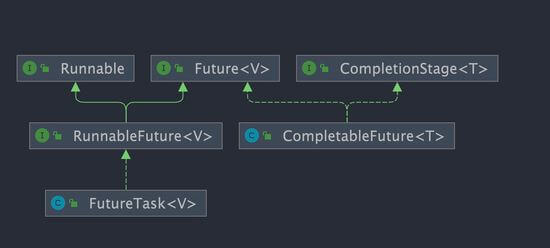
可以看到,CompletableFuture 同时实现了 FutureCompletionStage 接口。

completablefuture-class-diagram

Future 在实际使用过程中存在一些局限性比如不支持异步任务的编排组合、获取计算结果的 get() 方法为阻塞调用。

Java 8 才被引入CompletableFuture 类可以解决Future 的这些缺陷。CompletableFuture 除了提供了更为好用和强大的 Future 特性之外,还提供了函数式编程、异步任务编排组合(可以将多个异步任务串联起来,组成一个完整的链式调用)等能力。

CompletionStage 接口描述了一个异步计算的阶段。很多计算可以分成多个阶段或步骤,此时可以通过它将所有步骤组合起来,形成异步计算的流水线。

CompletionStage 接口中的方法比较多,CompletableFuture 的函数式能力就是这个接口赋予的。从这个接口的方法参数你就可以发现其大量使用了 Java8 引入的函数式编程
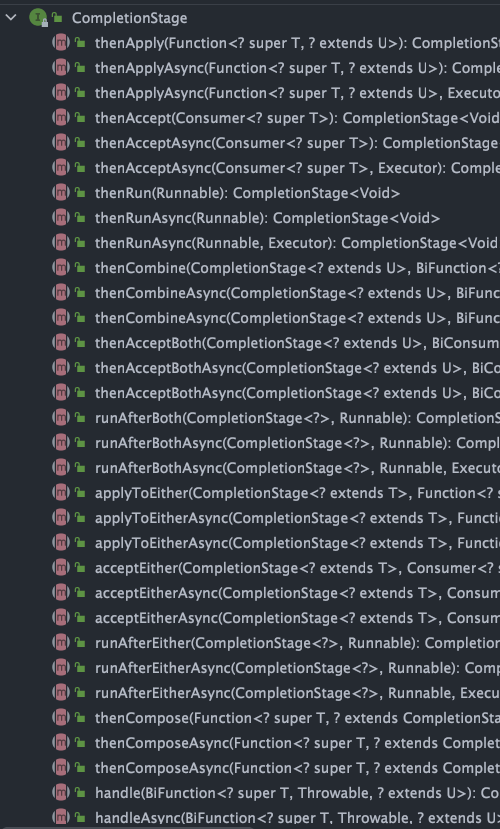
image-20210902093026059

1
2
3
4
5
6
static <U> CompletableFuture<U> supplyAsync(Supplier<U> supplier);
// 使用自定义线程池(推荐)
static <U> CompletableFuture<U> supplyAsync(Supplier<U> supplier, Executor executor);
static CompletableFuture<Void> runAsync(Runnable runnable);
// 使用自定义线程池(推荐)
static CompletableFuture<Void> runAsync(Runnable runnable, Executor executor);

处理异步计算的结果

当我们获取到异步计算的结果之后,还可以对其进行进一步的处理,比较常用的方法有下面几个:

  • thenApply()
  • thenAccept()
  • thenRun()
  • whenComplete()

thenApply() 方法接受一个 Function 实例,用它来处理结果。

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
// 沿用上一个任务的线程池
public <U> CompletableFuture<U> thenApply(
Function<? super T,? extends U> fn) {
return uniApplyStage(null, fn);
}

//使用默认的 ForkJoinPool 线程池(不推荐)
public <U> CompletableFuture<U> thenApplyAsync(
Function<? super T,? extends U> fn) {
return uniApplyStage(defaultExecutor(), fn);
}
// 使用自定义线程池(推荐)
public <U> CompletableFuture<U> thenApplyAsync(
Function<? super T,? extends U> fn, Executor executor) {
return uniApplyStage(screenExecutor(executor), fn);
}

如果你不需要从回调函数中获取返回结果,可以使用 thenAccept() 或者 thenRun()。这两个方法的区别在于 thenRun() 不能访问异步计算的结果。

1
2
3
4
5
6
7
8
9
10
11
12
public CompletableFuture<Void> thenAccept(Consumer<? super T> action) {
return uniAcceptStage(null, action);
}

public CompletableFuture<Void> thenAcceptAsync(Consumer<? super T> action) {
return uniAcceptStage(defaultExecutor(), action);
}

public CompletableFuture<Void> thenAcceptAsync(Consumer<? super T> action,
Executor executor) {
return uniAcceptStage(screenExecutor(executor), action);
}

thenRun() 的方法是的参数是 Runnable

1
2
3
4
5
6
7
8
9
10
11
12
public CompletableFuture<Void> thenRun(Runnable action) {
return uniRunStage(null, action);
}

public CompletableFuture<Void> thenRunAsync(Runnable action) {
return uniRunStage(defaultExecutor(), action);
}

public CompletableFuture<Void> thenRunAsync(Runnable action,
Executor executor) {
return uniRunStage(screenExecutor(executor), action);
}

thenAccept()thenRun() 使用示例如下:

1
2
3
4
5
CompletableFuture.completedFuture("hello!")
.thenApply(s -> s + "world!").thenApply(s -> s + "nice!").thenAccept(System.out::println);//hello!world!nice!

CompletableFuture.completedFuture("hello!")
.thenApply(s -> s + "world!").thenApply(s -> s + "nice!").thenRun(() -> System.out.println("hello!"));//hello!

whenComplete() 的方法的参数是 BiConsumer<? super T, ? super Throwable>

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
public CompletableFuture<T> whenComplete(
BiConsumer<? super T, ? super Throwable> action) {
return uniWhenCompleteStage(null, action);
}


public CompletableFuture<T> whenCompleteAsync(
BiConsumer<? super T, ? super Throwable> action) {
return uniWhenCompleteStage(defaultExecutor(), action);
}
// 使用自定义线程池(推荐)
public CompletableFuture<T> whenCompleteAsync(
BiConsumer<? super T, ? super Throwable> action, Executor executor) {
return uniWhenCompleteStage(screenExecutor(executor), action);
}

相对于 ConsumerBiConsumer 可以接收 2 个输入对象然后进行“消费”。

1
2
3
4
5
6
7
8
9
CompletableFuture<String> future = CompletableFuture.supplyAsync(() -> "hello!")
.whenComplete((res, ex) -> {
// res 代表返回的结果
// ex 的类型为 Throwable ,代表抛出的异常
System.out.println(res);
// 这里没有抛出异常所有为 null
assertNull(ex);
});
assertEquals("hello!", future.get());

异常处理(handle无论出没出现异常都会执行,exceptionally方法只有抛异常的时候才执行,返回一个备用值)

你可以通过 handle() 方法来处理任务执行过程中可能出现的抛出异常的情况。

1
2
3
4
5
6
7
8
9
10
11
12
13
14
public <U> CompletableFuture<U> handle(
BiFunction<? super T, Throwable, ? extends U> fn) {
return uniHandleStage(null, fn);
}

public <U> CompletableFuture<U> handleAsync(
BiFunction<? super T, Throwable, ? extends U> fn) {
return uniHandleStage(defaultExecutor(), fn);
}

public <U> CompletableFuture<U> handleAsync(
BiFunction<? super T, Throwable, ? extends U> fn, Executor executor) {
return uniHandleStage(screenExecutor(executor), fn);
}

你还可以通过 exceptionally() 方法来处理异常情况。

1
2
3
4
5
6
7
8
9
10
11
CompletableFuture<String> future
= CompletableFuture.supplyAsync(() -> {
if (true) {
throw new RuntimeException("Computation error!");
}
return "hello!";
}).exceptionally(ex -> {
System.out.println(ex.toString());// CompletionException
return "world!";
});
assertEquals("world!", future.get());

组合CompletableFuture

你可以使用 thenCompose() 按顺序链接两个 CompletableFuture 对象,实现异步的任务链。它的作用是将前一个任务的返回结果作为下一个任务的输入参数,从而形成一个依赖关系。

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
public <U> CompletableFuture<U> thenCompose(
Function<? super T, ? extends CompletionStage<U>> fn) {
return uniComposeStage(null, fn);
}

public <U> CompletableFuture<U> thenComposeAsync(
Function<? super T, ? extends CompletionStage<U>> fn) {
return uniComposeStage(defaultExecutor(), fn);
}

public <U> CompletableFuture<U> thenComposeAsync(
Function<? super T, ? extends CompletionStage<U>> fn,
Executor executor) {
return uniComposeStage(screenExecutor(executor), fn);
}

thenCompose() 方法会使用示例如下:

1
2
3
4
CompletableFuture<String> future
= CompletableFuture.supplyAsync(() -> "hello!")
.thenCompose(s -> CompletableFuture.supplyAsync(() -> s + "world!"));
assertEquals("hello!world!", future.get());

在实际开发中,这个方法还是非常有用的。比如说,task1 和 task2 都是异步执行的,但 task1 必须执行完成后才能开始执行 task2(task2 依赖 task1 的执行结果)。

thenCompose() 方法类似的还有 thenCombine() 方法, 它同样可以组合两个 CompletableFuture 对象。

1
2
3
4
5
6
CompletableFuture<String> completableFuture
= CompletableFuture.supplyAsync(() -> "hello!")
.thenCombine(CompletableFuture.supplyAsync(
() -> "world!"), (s1, s2) -> s1 + s2)
.thenCompose(s -> CompletableFuture.supplyAsync(() -> s + "nice!"));
assertEquals("hello!world!nice!", completableFuture.get());

thenCompose()thenCombine() 有什么区别呢?

  • thenCompose() 可以链接两个 CompletableFuture 对象,并将前一个任务的返回结果作为下一个任务的参数,它们之间存在着先后顺序。
  • thenCombine() 会在两个任务都执行完成后,把两个任务的结果合并。两个任务是并行执行的,它们之间并没有先后依赖顺序。

除了 thenCompose()thenCombine() 之外, 还有一些其他的组合 CompletableFuture 的方法用于实现不同的效果,满足不同的业务需求。

例如,如果我们想要实现 task1 和 task2 中的任意一个任务执行完后就执行 task3 的话,可以使用 acceptEither()

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
CompletableFuture<String> task = CompletableFuture.supplyAsync(() -> {
System.out.println("任务1开始执行,当前时间:" + System.currentTimeMillis());
try {
Thread.sleep(500);
} catch (InterruptedException e) {
e.printStackTrace();
}
System.out.println("任务1执行完毕,当前时间:" + System.currentTimeMillis());
return "task1";
});

CompletableFuture<String> task2 = CompletableFuture.supplyAsync(() -> {
System.out.println("任务2开始执行,当前时间:" + System.currentTimeMillis());
try {
Thread.sleep(1000);
} catch (InterruptedException e) {
e.printStackTrace();
}
System.out.println("任务2执行完毕,当前时间:" + System.currentTimeMillis());
return "task2";
});

task.acceptEitherAsync(task2, (res) -> {
System.out.println("任务3开始执行,当前时间:" + System.currentTimeMillis());
System.out.println("上一个任务的结果为:" + res);
});

// 增加一些延迟时间,确保异步任务有足够的时间完成
try {
Thread.sleep(2000);
} catch (InterruptedException e) {
e.printStackTrace();
}

任务1开始执行,当前时间:1695088058520
任务2开始执行,当前时间:1695088058521
任务1执行完毕,当前时间:1695088059023
任务3开始执行,当前时间:1695088059023
上一个任务的结果为:task1
任务2执行完毕,当前时间:1695088059523

任务组合操作acceptEitherAsync()会在异步任务 1 和异步任务 2 中的任意一个完成时触发执行任务 3,但是需要注意,这个触发时机是不确定的。如果任务 1 和任务 2 都还未完成,那么任务 3 就不能被执行。

并行运行多个CompletableFuture

你可以通过 CompletableFutureallOf()这个静态方法来并行运行多个 CompletableFuture

实际项目中,我们经常需要并行运行多个互不相关的任务,这些任务之间没有依赖关系,可以互相独立地运行。

比说我们要读取处理 6 个文件,这 6 个任务都是没有执行顺序依赖的任务,但是我们需要返回给用户的时候将这几个文件的处理的结果进行统计整理。像这种情况我们就可以使用并行运行多个 CompletableFuture 来处理。

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
CompletableFuture<Void> task1 =
CompletableFuture.supplyAsync(()->{
//自定义业务操作
});
......
CompletableFuture<Void> task6 =
CompletableFuture.supplyAsync(()->{
//自定义业务操作
});
......
CompletableFuture<Void> headerFuture=CompletableFuture.allOf(task1,.....,task6);

try {
headerFuture.join();
} catch (Exception ex) {
......
}
System.out.println("all done. ");

CompletableFuture使用建议

1.使用自定义线程池

2.尽量避免使用get()

CompletableFutureget()方法是阻塞的,尽量避免使用。如果必须要使用的话,需要添加超时时间,否则可能会导致主线程一直等待,无法执行其他任务。

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
    CompletableFuture<String> future = CompletableFuture.supplyAsync(() -> {
try {
Thread.sleep(10_000);
} catch (InterruptedException e) {
e.printStackTrace();
}
return "Hello, world!";
});

// 获取异步任务的返回值,设置超时时间为 5 秒
try {
String result = future.get(5, TimeUnit.SECONDS);
System.out.println(result);
} catch (InterruptedException | ExecutionException | TimeoutException e) {
// 处理异常
e.printStackTrace();
}
}

上面这段代码在调用 get() 时抛出了 TimeoutException 异常。这样我们就可以在异常处理中进行相应的操作,比如取消任务、重试任务、记录日志等。

ALL of方法可以怎么实现

  1. AtomicInteger 计数
  2. 信号量
  3. countDownLantch(CountDownLatch的理解和使用 - Shane_Li - 博客园)

公平锁是什么?如果是你,如何实现公平锁,用什么技术?。

公平锁:按照线程请求锁的顺序来获取锁,先到先得(FIFO)

**如何实现:**我会维护一个线程等待队列,每个线程请求锁时,先判断自己是不是队头,如果是才允许进入临界区,否则就排队等待。这样就能保证线程获取锁的顺序是先进先出,实现公平性。

CompletableFuture怎么用的和future区别

Future接口,一般都是取回Callable执行的状态用的。其中的主要方法:

  • cancel,取消Callable的执行,当Callable还没有完成时
  • get,获得Callable的返回值
  • isCanceled,判断是否取消了
  • isDone,判断是否完成

回调(Callback) 是一种编程模式,在这种模式下,一个方法作为参数传递给另一个方法,并在某个事件发生后(通常是异步操作完成时)被调用。回调常用于处理异步任务、事件驱动的编程模型或者一些需要延迟执行的任务。
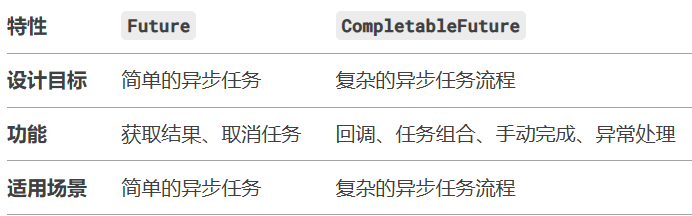
image-20250219163728813-1775809455791

Future 示例

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
import java.util.concurrent.*;
//future通过线程池提交获得的
public class FutureExample {
public static void main(String[] args) throws Exception {
ExecutorService executor = Executors.newSingleThreadExecutor();
Future<String> future = executor.submit(() -> {
Thread.sleep(1000); // 模拟耗时操作
return "Hello, Future!";
});

// 阻塞获取结果
String result = future.get();
System.out.println(result);

executor.shutdown();
}
}
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
import java.util.concurrent.CompletableFuture;

public class CompletableFutureExample {
public static void main(String[] args) {
CompletableFuture<String> future = CompletableFuture.supplyAsync(() -> {
try {
Thread.sleep(1000); // 模拟耗时操作
} catch (InterruptedException e) {
e.printStackTrace();
}
return "Hello, CompletableFuture!";
});

// 非阻塞回调
future.thenAccept(result -> System.out.println(result));

// 主线程继续执行其他任务
System.out.println("Main thread continues...");

// 防止主线程退出
try {
Thread.sleep(2000);
} catch (InterruptedException e) {
e.printStackTrace();
}
}
}

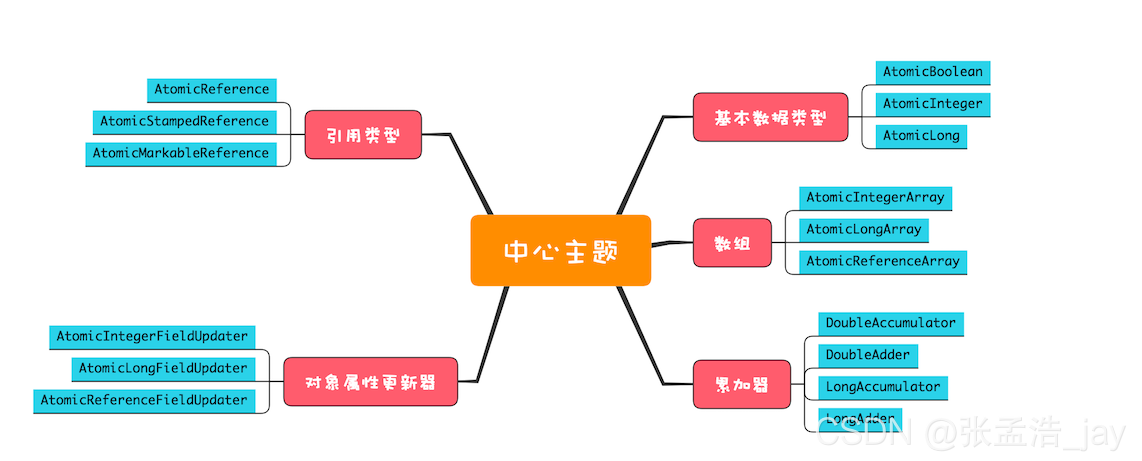
Atomic原子类

fc9a4a7f6dbc1149eceb1f57606708a9

1.基本类型

AtomicInteger、AtomicBoolean、AtomicLong

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
getAndIncrement() // 原子化 i++
getAndDecrement() // 原子化的 i--
incrementAndGet() // 原子化的 ++i
decrementAndGet() // 原子化的 --i
// 当前值 +=delta,返回 += 前的值
getAndAdd(delta)
// 当前值 +=delta,返回 += 后的值
addAndGet(delta)
//CAS 操作,返回是否成功
compareAndSet(expect, update)
// 以下四个方法
// 新值可以通过传入 func 函数来计算
getAndUpdate(func)
updateAndGet(func)
getAndAccumulate(x,func)
accumulateAndGet(x,func)

2.对象引用类型

AtomicReference
AtomicReference利用CAS来更新引用,旧值为原来的引用对象,新值为新的引用对象。 是更新引用,而不是更新对象。

看下面的源码就知道了,其实传入的对象就是AtomicReference的一个属性名字叫value的取值,通过CAS来更改value的取值,通过AtomicReference.get()来获取最新的值。其实就是调用的unsafe.compareAndSwapObject()方法;
AtomicStampedReference

AtomicReference有一个缺点,不能解决ABA问题。
ABA问题就是多个线程前后修改值,导致线程CAS前后值没有变化,但是中间却发生了修改。

AtomicStampedReference通过引入时间戳来解决了ABA问题。每次要更新值的时候,需要额外传入oldStamp和newStamp。将对象和stamp包装成了一个Pair对象。

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
User user = new User("jaychou",24);
AtomicStampedReference<User> userAtomicStampedReference = new AtomicStampedReference<>(user,1);

while (true){
User user1 = new User("jay",222);
int oldStamp1 = userAtomicStampedReference.getStamp();
int[] stamp = new int[1];
User oldUser = userAtomicStampedReference.get(stamp);
boolean flag = userAtomicStampedReference.compareAndSet(oldUser,user1,stamp[0],stamp[0]+1);
if (flag){
break;
}
}

int[] s = new int[1];
System.out.println(userAtomicStampedReference.get(s));
System.out.println(s[0]);

3.Atomic数组

Atomic数组主要有AtomicIntegerArray、AtomicLongArray、AtomicReferenceArray.

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
AtomicIntegerArray integerArray = new AtomicIntegerArray(10);//10为数组长度
while (true){
boolean flag = integerArray.compareAndSet(0,integerArray.get(0),2);
if (flag){
System.out.println(integerArray.get(0)+"---"+flag);
break;
}
}

AtomicReferenceArray<User> referenceArray = new AtomicReferenceArray<>(10);
while (true){
boolean flag2 = referenceArray.compareAndSet(0,referenceArray.get(0),new User("jaychou",22));
if (flag2){
System.out.println(referenceArray.get(0)+"---"+flag2);
break;
}
}

4.对象属性原子更新器

有三类:AtomicIntegerFieldUpdater(修改对象中的)、AtomicLongFieldUpdater、AtomicReferenceFieldUpdater

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
User user = new User("jaychou",22);

//初始化参数分别为:对应对应的类,属性对应的类,属性的名字
AtomicReferenceFieldUpdater fieldUpdater = AtomicReferenceFieldUpdater.newUpdater(User.class,String.class,"name");
//初始化参数分别为:对应对应的类,属性的名字。属性对应的类可以忽略,因为类名中已经记录了
AtomicIntegerFieldUpdater integerFieldUpdater = AtomicIntegerFieldUpdater.newUpdater(User.class,"age");

fieldUpdater.compareAndSet(user,user.name,"666");
integerFieldUpdater.compareAndSet(user,user.age,1000);

System.out.println(user);


class User{
int age;
volatile String name;

public User(String name,int age){
this.name = name;
this.age = age;
}

@Override
public String toString() {
return "User{" +
"age=" + age +
", name='" + name + '\'' +
'}';
}
}

非公平锁和公平锁,ReentrantLock怎么实现公平和非公平,性能差异?

公平锁保证锁的获取按照线程请求的顺序进行,而非公平锁则允许线程抢占锁。虽然公平锁可以避免线程饥饿

公平

  1. 当线程尝试获取锁时,ReentrantLock 会检查是否有其他线程在等待队列中。如果有,当前线程会被加入到等待队列的末尾。
  2. 锁的释放时,系统会唤醒等待队列中的第一个线程,从而保证锁的获取顺序是公平的。

非公平

  1. 线程直接尝试获取锁,如果锁是可用的,立即获取,不需要查看等待队列中的其他线程。
  2. 由于线程不按顺序排队,某些线程可能抢占其他线程的锁,从而提升了性能,但可能导致某些线程长期等待。

锁的类型
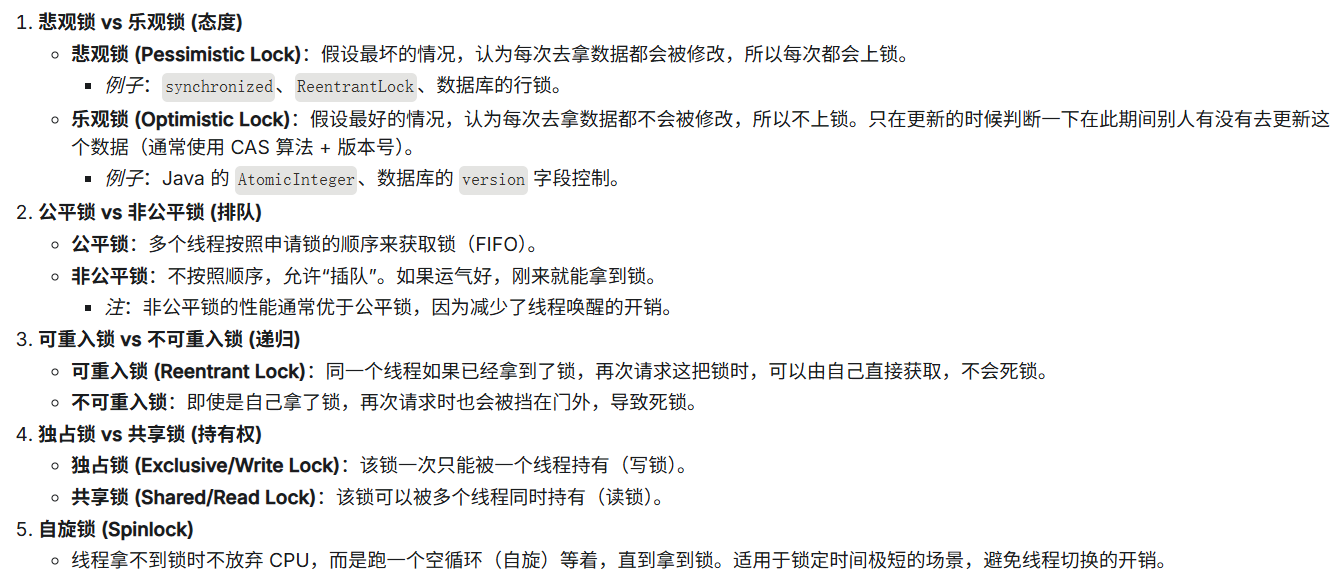
image-20260104185309699-1775809467661

AQS(1.5w字+30图带你彻底掌握 AQS!_图解aqs-CSDN博客

1.什么是AQS

AQS是一个用来构建锁和同步器的框架,使用AQS能简单且高效地构造出应用广泛的大量的同步器,比如我们提到的ReentrantLock,Semaphore,其他的诸如ReentrantReadWriteLock,SynchronousQueue,FutureTask等等皆是基于AQS的。当然,我们自己也能利用AQS非常轻松容易地构造出符合我们自己需求的同步器。

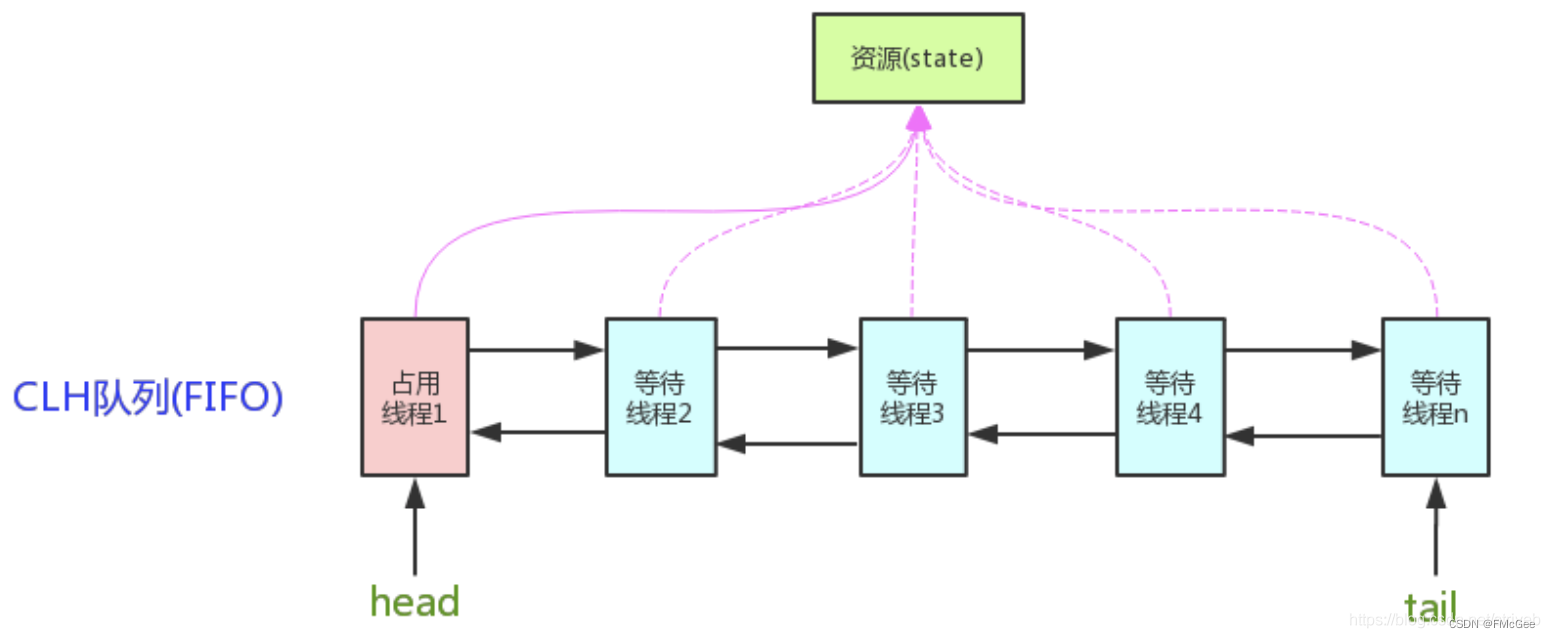
2.核心思想

AQS核心思想是,如果被请求的共享资源空闲,则将当前请求资源的线程设置为有效的工作线程,并且将共享资源设置为锁定状态。如果被请求的共享资源被占用,那么就需要一套线程阻塞等待以及被唤醒时锁分配的机制,这个机制AQS是用CLH队列锁实现的,即将暂时获取不到锁的线程加入到队列中。 CLH(Craig,Landin,and Hagersten)队列是一个虚拟的双向队列(虚拟的双向队列即不存在队列实例,仅存在结点之间的关联关系)。AQS是将每条请求共享资源的线程封装成一个CLH锁队列的一个结点(Node)来实现锁的分配。 AQS使用一个int成员变量来表示同步状态,通过内置的FIFO队列来完成获取资源线程的排队工作。AQS使用CAS对该同步状态进行原子操作实现对其值的修改。 (图一为节点关系图)

1
private volatile int state;//共享变量,使用volatile修饰保证线程可见性

37d2f170b75948f3ee1d255aff5fed3e

3.AQS 源码分析

3.1AQS的数据结构

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
/**
* Head of the wait queue, lazily initialized. Except for
* initialization, it is modified only via method setHead. Note:
* If head exists, its waitStatus is guaranteed not to be
* CANCELLED.
*/
private transient volatile Node head;

/**
* Tail of the wait queue, lazily initialized. Modified only via
* method enq to add new wait node.
*/
private transient volatile Node tail;

/**
* The synchronization state.
*/
private volatile int state;

1
2
3
4
5
6
7
8
9
10
11
12
13
14
在这里插入代码片
class Node{
//节点等待状态
volatile int waitStatus;
// 双向链表当前节点前节点
volatile Node prev;
// 下一个节点
volatile Node next;
// 当前节点存放的线程
volatile Thread thread;
// condition条件等待的下一个节点
Node nextWaiter;
}

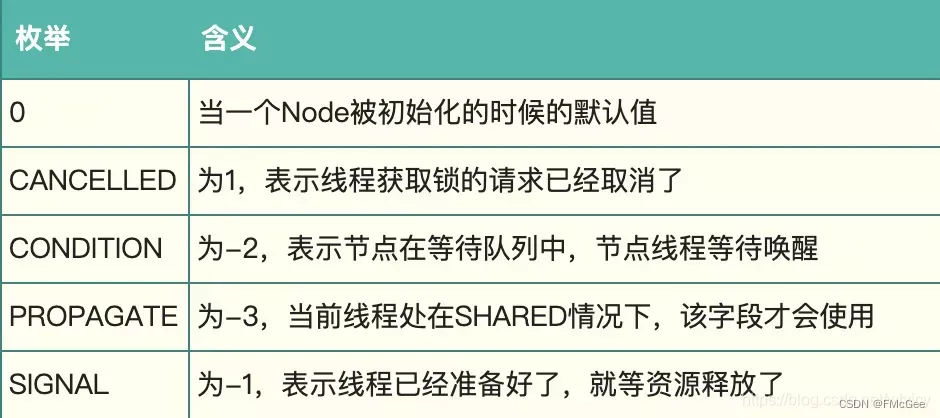
waitStatus 只有特定的几个常量,相应的值解释如下:
785ca26c055b5be2761374af6a0c7bc5

3.2lock源码分析

首先我们看一下lock()方法源代码,直接进入非公平锁的lock方法:

1
2
3
4
5
6
7
8
9
10
final void lock() {
//1、判断当前state 状态, 没有锁则当前线程抢占锁
if (compareAndSetState(0, 1))
// 独占锁
setExclusiveOwnerThread(Thread.currentThread());
else
// 2、锁被人占了,尝试获取锁,关键方法了
acquire(1);
}

进入 AQS的acquire() 方法:

1
2
3
4
5
6
public final void acquire(int arg) {
if (!tryAcquire(arg) &&
acquireQueued(addWaiter(Node.EXCLUSIVE), arg))
selfInterrupt();
}

lock方法主要由tryAquire()尝试获取锁,addWaiter(Node.EXCLUSIVE) 加入等待队列,acquireQueued(node,arg)等待队列尝试获取锁。示意图如下:
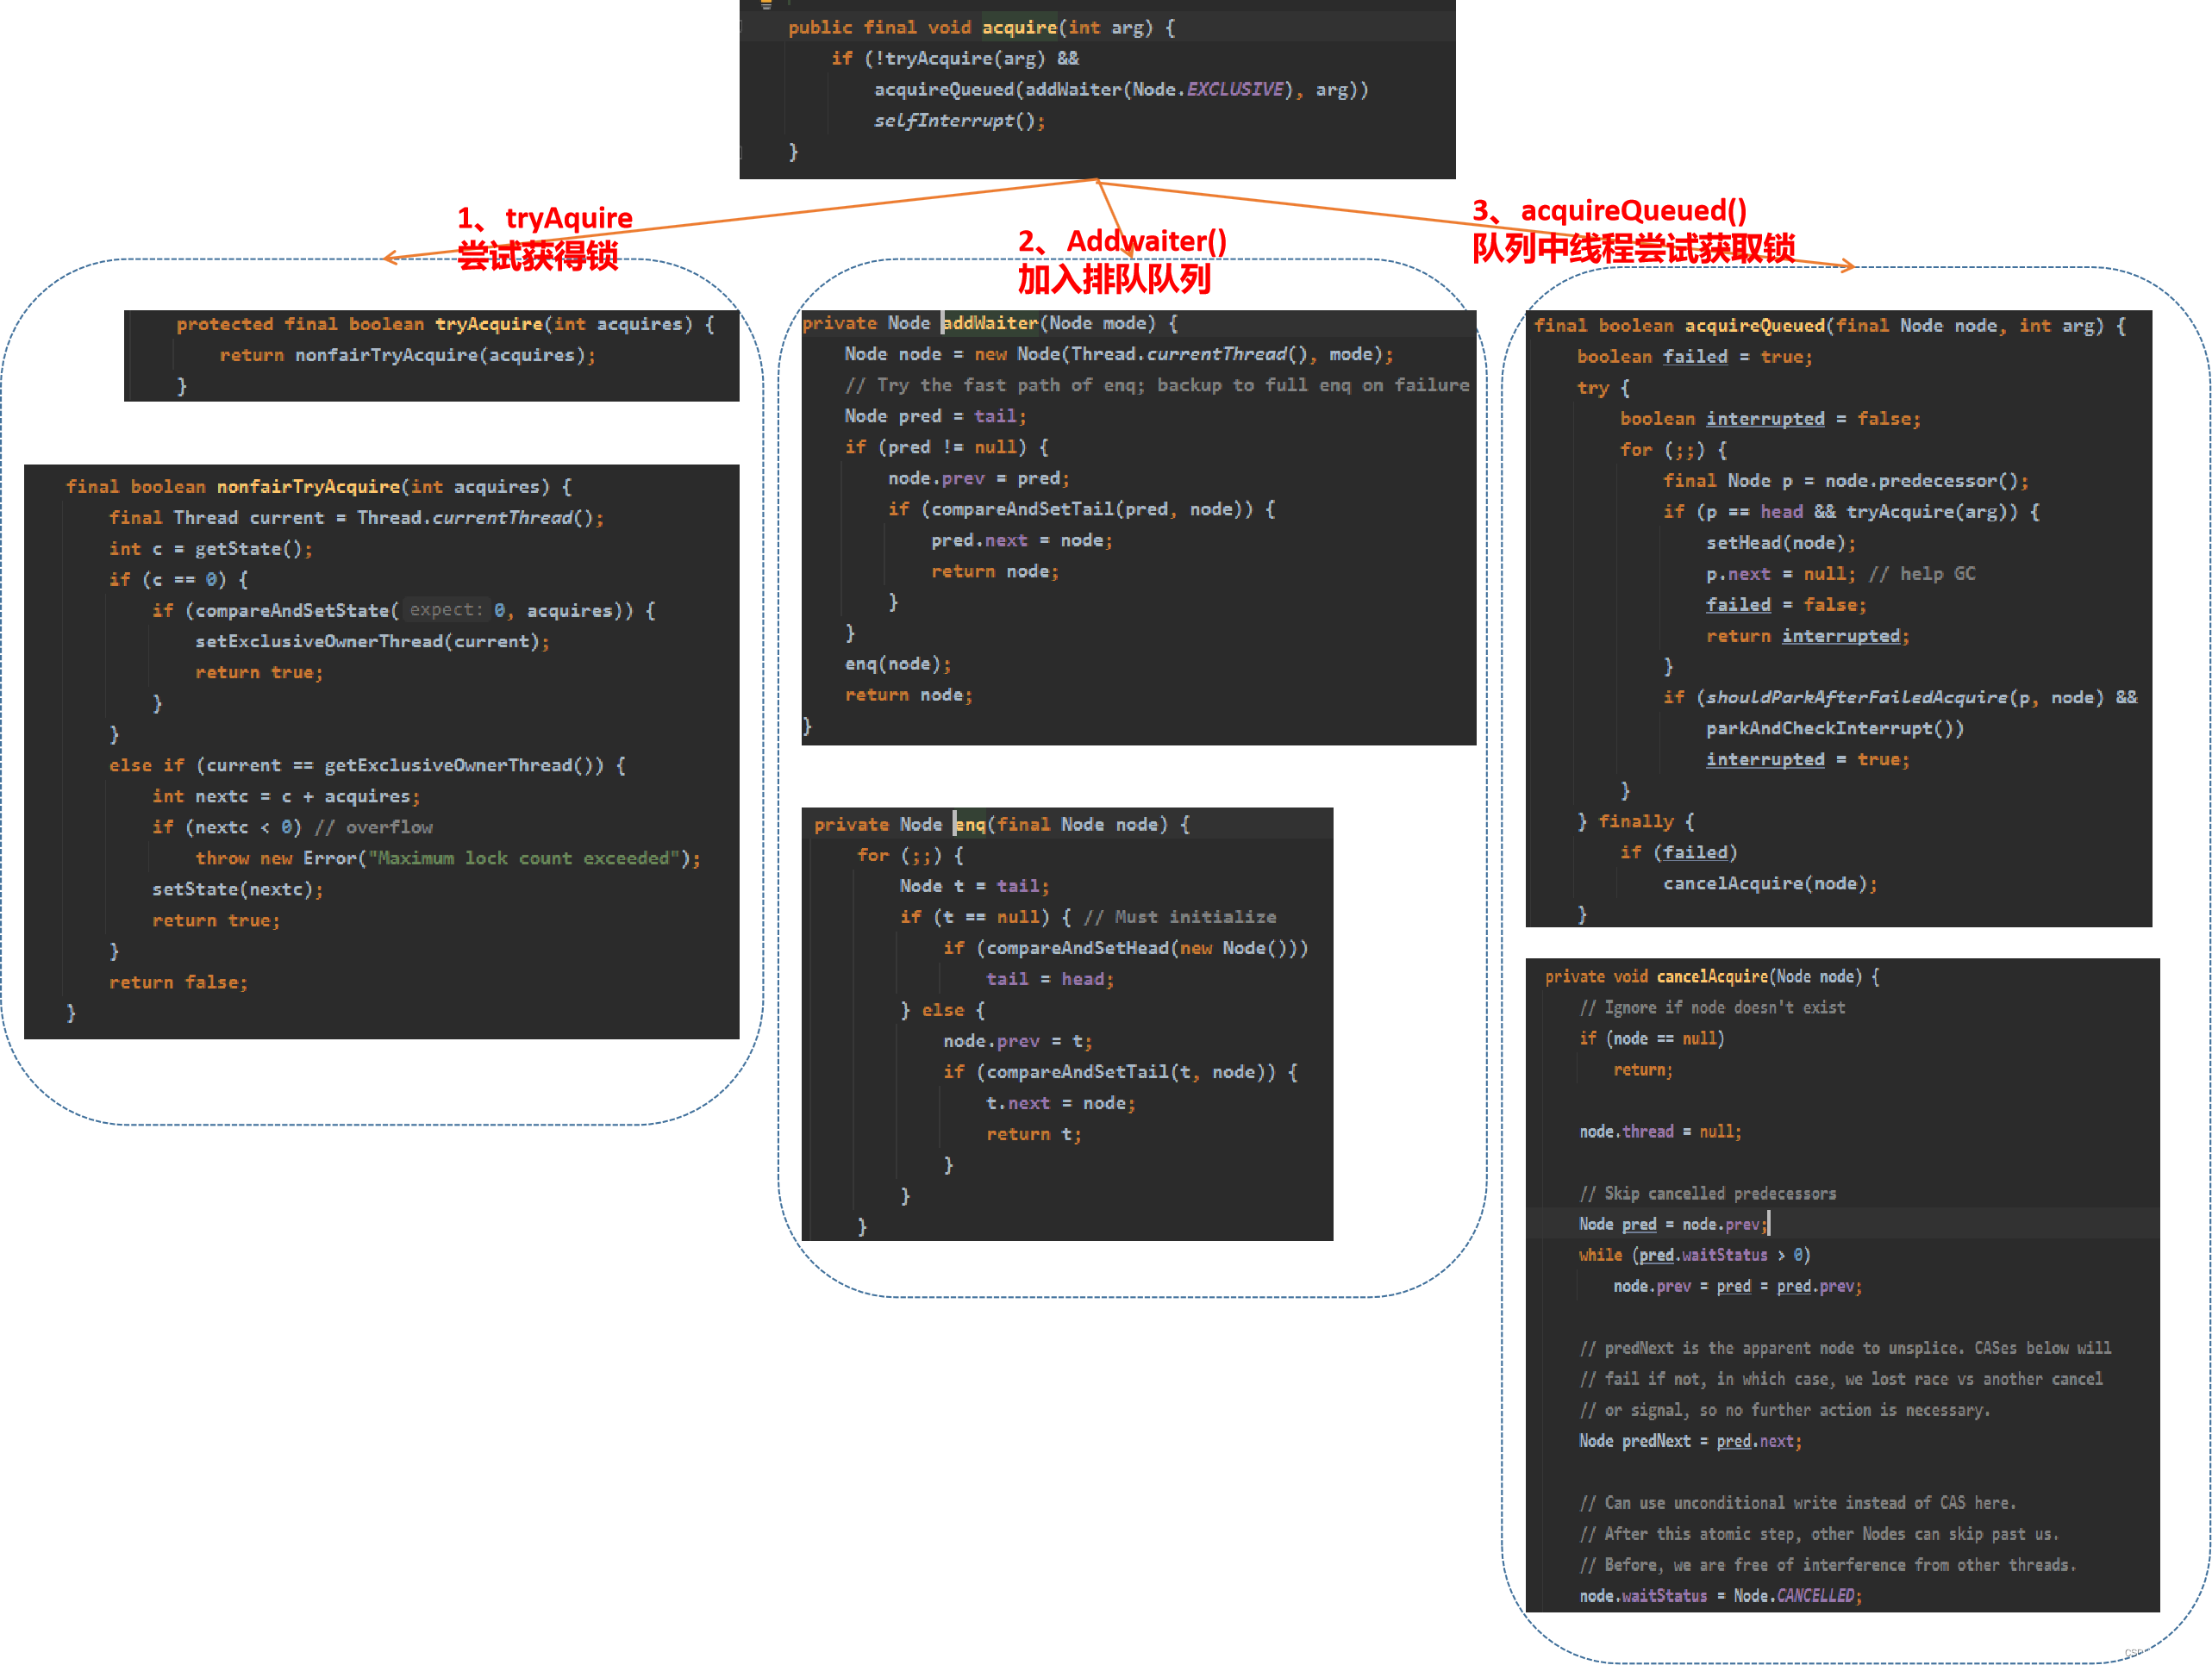
421c2cf8f78f36c4d3fc9f2cc559bb32

4.tryAcquire方法

  • 既然是非公平锁,那么我们一进来就想着去抢锁,不管三七二一,直接试试能不能抢到,抢不到再进队列。
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
final boolean nonfairTryAcquire(int acquires) {
//1、获取当前线程
final Thread current = Thread.currentThread();
// 2、获取当前锁的状态,0 表示没有被线程占有,>0 表示锁被别的线程占有
int c = getState();
// 3、如果锁没有被线程占有
if (c == 0) {
// 3.1、 使用CAS去获取锁, 为什么用case呢,防止在获取c之后 c的状态被修改了,保证原子性
if (compareAndSetState(0, acquires)) {
// 3.2、设置独占锁
setExclusiveOwnerThread(current);
// 3.3、当前线程获取到锁后,直接发挥true
return true;
}
}
// 4、判断当前占有锁的线程是不是自己
else if (current == getExclusiveOwnerThread()) {
// 4.1 可重入锁,加+1
int nextc = c + acquires;
if (nextc < 0) // overflow
throw new Error("Maximum lock count exceeded");
// 4.2 设置锁的状态
setState(nextc);
return true;
}
return false;
}

5.addWaiter() 方法的解析

  • private Node addWaiter(Node mode),当前线程没有货得锁的情况下,进入CLH队列尾部,主要通过CAS入队。
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
private Node addWaiter(Node mode) {
// 1、初始化当前线程节点,虚拟节点
Node node = new Node(Thread.currentThread(), mode);
// Try the fast path of enq; backup to full enq on failure
// 2、获取尾节点,初始进入节点是null
Node pred = tail;
// 3、如果尾节点不为null,怎将当前线程节点放到队列尾部,并返回当前节点
if (pred != null) {
node.prev = pred;
if (compareAndSetTail(pred, node)) {
pred.next = node;
return node;
}
}
// 如果尾节点为null(其实是链表没有初始化),怎进入enq方法
enq(node);
return node;
}

// 这个方法可以认为是初始化链表
private Node enq(final Node node) {
// 1、入队 : 为什么要用循环呢?
for (;;) {
// 获取尾节点
Node t = tail;
// 2、尾节点为null
if (t == null) { // Must initialize
// 2.1 初始话头结点和尾节点
if (compareAndSetHead(new Node()))
tail = head;
}
// 3、将当前节点加入链表尾部
else {
node.prev = t;
if (compareAndSetTail(t, node)) {
t.next = node;
return t;
}
}
}
}

有人想明白为什么enq要用for(;;)吗? 咋一看最多只要循环2次啊! 答疑来了,这是对于单线程来说确实是这样的,但是对于多线程来说,有可能在第2部完成之后就被别的线程先执行入链表了,这时候第3步cas之后发现不成功了,怎么办?只能再一次循环去尝试加入链表,直到成功为止

6.acquireQueued()方法详解

  • addWaiter 方法我们已经将没有获取锁的线程放在了等待链表中,但是这些线程并没有处于等待状态。acquireQueued的作用就是将线程设置为等待状态。
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42
43
44
45
46
47
48
49
50
51
52
53
54
55
56
57
58
59
60
61
 final boolean acquireQueued(final Node node, int arg) {
// 失败标识
boolean failed = true;
try {
// 中断标识
boolean interrupted = false;
for (;;) {
// 获取当前节点的前一个节点
final Node p = node.predecessor();
// 1、如果前节点是头结点,那么去尝试获取锁
if (p == head && tryAcquire(arg)) {
// 重置头结点
setHead(node);
p.next = null; // help GC
// 获得锁
failed = false;
// 返回false,节点获得锁,,,然后现在只有自己一个线程了这个时候就会自己唤醒自己
// 使用的是acquire中的selfInterrupt();
return interrupted;
}
// 2、如果线程没有获得锁,且节点waitStatus=0,shouldParkAfterFailedAcquire并将节点的waitStatus赋值为-1
//parkAndCheckInterrupt将线程park,进入等待模式,
if (shouldParkAfterFailedAcquire(p, node) &&
parkAndCheckInterrupt())
interrupted = true;
}
} finally {
if (failed) //出现异常才会failed为true,为什么呢,因为shouldParkAfterFailedAcquire是会吧前驱线程取消掉,然后设置前驱节点的状
//态为<0,如果设置不成功自旋获取,成功的话,park堵塞,然后如果被唤醒,获取锁,总弄获取成功,成功failed=false
cancelAcquire(node);
}
}

private static boolean shouldParkAfterFailedAcquire(Node pred, Node node) {
int ws = pred.waitStatus;
if (ws == Node.SIGNAL)
/*
* This node has already set status asking a release
* to signal it, so it can safely park.
*/
return true;
if (ws > 0) {
/*
* Predecessor was cancelled. Skip over predecessors and
* indicate retry.
*/
do {
node.prev = pred = pred.prev;
} while (pred.waitStatus > 0);
pred.next = node;
} else {
/*
* waitStatus must be 0 or PROPAGATE. Indicate that we
* need a signal, but don't park yet. Caller will need to
* retry to make sure it cannot acquire before parking.
*/
compareAndSetWaitStatus(pred, ws, Node.SIGNAL);
}
return false;
}

我用白话给大家串起来讲一下吧! 我们以reentrantLock的非公平锁结合我们案例4来讲解。
当线程A 到lock()方法时,通过compareAndSetState(0,1)获得锁,并且获得独占锁。当B,C线程去争抢锁时,运行到acquire(1),C线程运行tryAcquire(1),接着运行nonfairTryAcquire(1)方法,未获取锁,最后返回false,运行addWaiter(),运行enq(node),初始化head节点,同时C进入队列;再进入acquireQueued(node,1)方法,初始化waitStatus= -1,自旋并park()进入等待。
接着B线程开始去抢锁,B线程运行tryAcquire(1),运行nonfairTryAcquire(1)方法,未获得锁最后返回false,运行addWaiter(),直接添加到队尾,同时B进入队列;在进入acquireQueued(node,1)方法,初始化waitStatus= -1,自旋并park()进入等待。
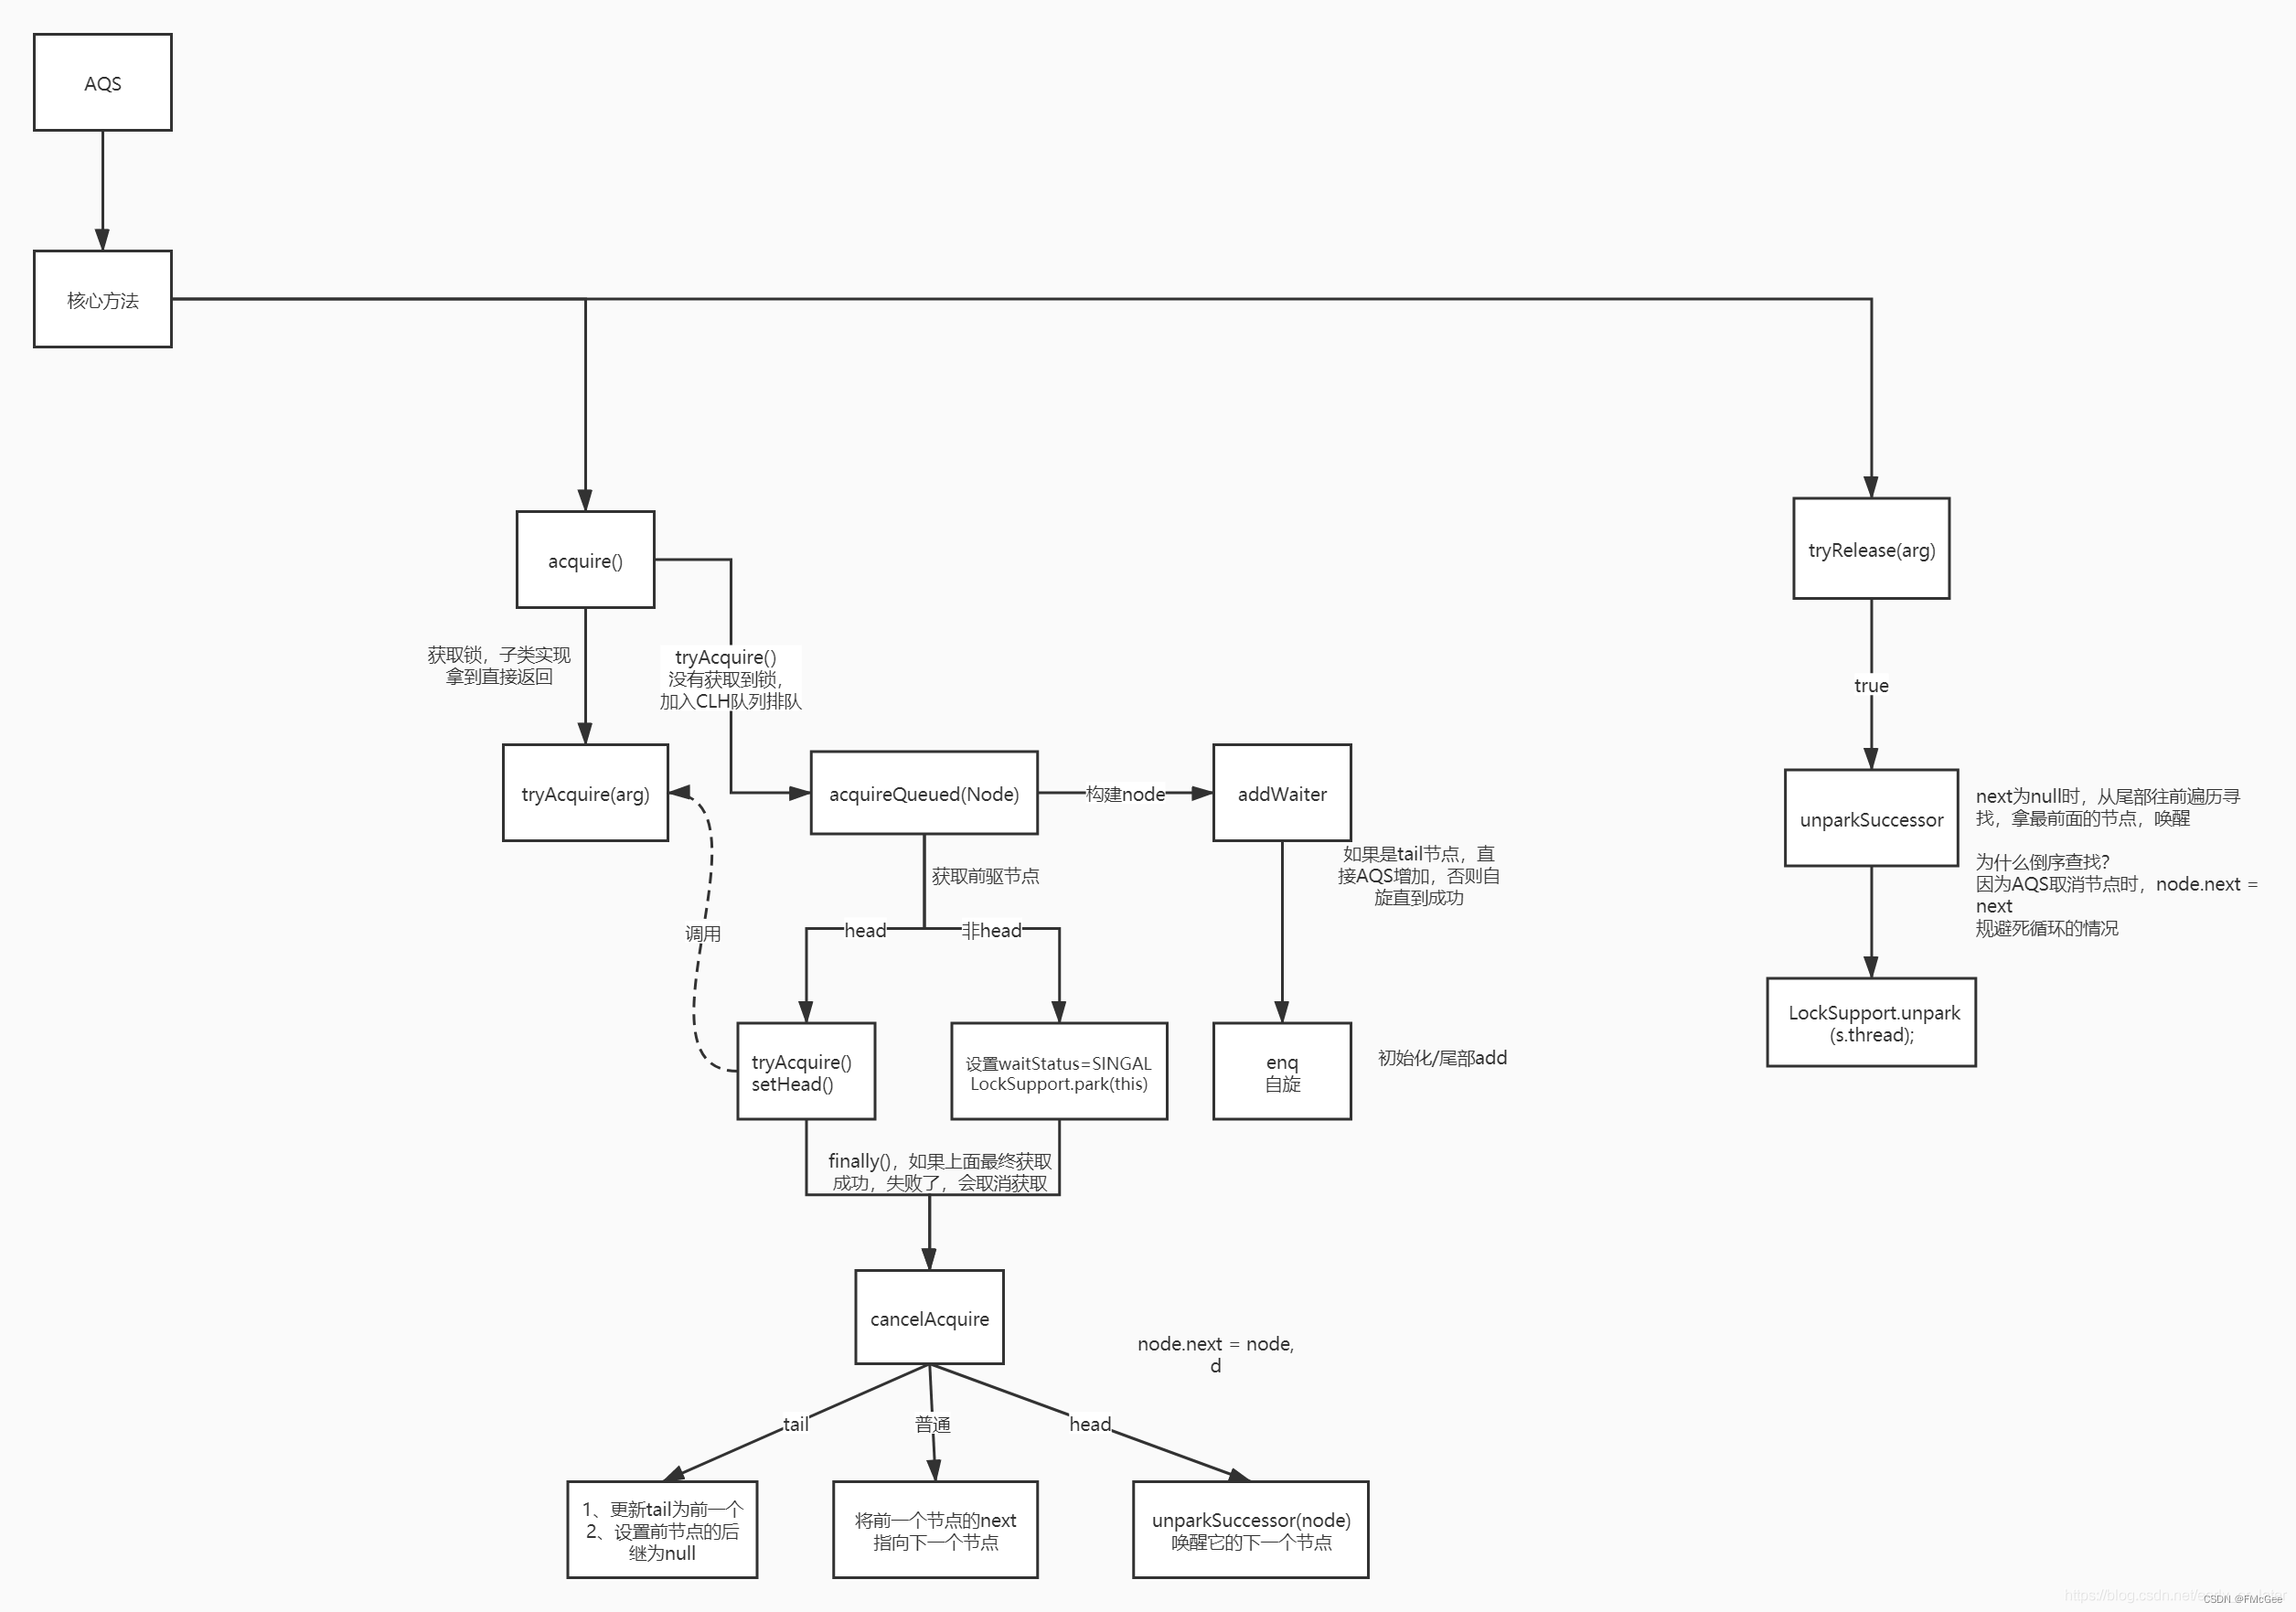
3f9634b0f3a6fd40530184a7a38102de

8.unlock源码分析

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42
43
44
45
46
47
48
49
50
51
52
53
54
55
56
57
58
59
60
 public final boolean release(int arg) {
// 如果成功释放独占锁,
if (tryRelease(arg)) {
Node h = head;
// 如果头结点不为null,且后续有入队结点
if (h != null && h.waitStatus != 0)
//释放当前线程,并激活等待队里的第一个有效节点
unparkSuccessor(h);
return true;
}
return false;
}
// 如果释放锁着返回true,否者返回false
// 并且将sate 设置为0
protected final boolean tryRelease(int releases) {
int c = getState() - releases;
if (Thread.currentThread() != getExclusiveOwnerThread())
throw new IllegalMonitorStateException();
boolean free = false;
if (c == 0) {
free = true;
setExclusiveOwnerThread(null);
}
setState(c);
return free;
}


private void unparkSuccessor(Node node) {
/*
* If status is negative (i.e., possibly needing signal) try
* to clear in anticipation of signalling. It is OK if this
* fails or if status is changed by waiting thread.
*/
int ws = node.waitStatus;
if (ws < 0)
// 重置头结点的状态waitStatus
compareAndSetWaitStatus(node, ws, 0);

/*
* Thread to unpark is held in successor, which is normally
* just the next node. But if cancelled or apparently null,
* traverse backwards from tail to find the actual
* non-cancelled successor.
*/
// 获取头结点的下一个节点
Node s = node.next;
// s.waitStatus > 0 为取消状态 ,结点为空且被取消
if (s == null || s.waitStatus > 0) {
s = null;
// 获取队列里没有cancel的最前面的节点
for (Node t = tail; t != null && t != node; t = t.prev)
if (t.waitStatus <= 0)
s = t;
}
// 如果节点s不为null,则获得锁
if (s != null)
LockSupport.unpark(s.thread);
}

总结:

  1. state 变量
    • private volatile int state;
    • 这是一个用 volatile 修饰的 int 变量,代表同步状态
    • 含义
      • 在 ReentrantLock 中:state=0 表示无锁,state>0 表示有线程持有锁(重入次数)。
      • 在 CountDownLatch 中:state 就是倒计时的计数值。
    • 操作:所有对 state 的修改都必须通过 CAS 来保证原子性。
  2. CLH 队列
    • 这是一个双向链表,AQS 内部用它来管理所有排队等待的线程。
    • 当一个线程抢锁失败,它就会被封装成一个 Node 节点,加入这个队列的尾部。
    • 特点
      • head 节点是“天选之子”,代表当前持有锁或即将持有锁的线程。
      • 每个节点都会“死死盯着”自己的前一个节点,只有前一个节点释放了锁,自己才有机会去抢。

抢锁失败后,线程是如何进入队列的?

这是一个标准的“自旋 -> 入队 -> 挂起”流程。以 ReentrantLock 的非公平锁为例:

1. 尝试抢锁 (CAS)

  • 线程一来,不管三七二十一,直接用 CAS 尝试把 state 从 0 改成 1。
  • 如果成功 -> 抢锁成功,设置自己为独占线程,完事。
  • 如果失败 -> 说明锁被别人占了,进入下一步。

2. acquire(1)

  • acquire 是 AQS 提供的模板方法,它会调用 tryAcquire(1)(这个是 ReentrantLock 自己实现的)。
  • tryAcquire 还会再试一次,万一锁正好释放了呢?如果还失败,就调用 addWaiter()。

3. addWaiter() - 创建节点并入队

  • 创建节点:把当前线程封装成一个 Node 对象。
  • 快速入队:用 CAS 尝试把这个新节点设置为队列的 tail(尾巴)。
    • 如果成功,皆大- 欢喜。
    • 如果失败(说明有别的线程也在入队),就进入 enq() 方法。

4. enq() - 自旋 CAS 入队

  • 这是一个 for(;;) 死循环,确保节点一定能入队。
  • 通过 CAS 不断尝试把自己加到队尾,直到成功为止。

5. acquireQueued() - 在队列中自旋并挂起

  • 入队成功后,节点就进入了这个方法,开始“排队生涯”。
  • 关键逻辑
    1. 看前任:检查自己的前一个节点是不是 head。
    2. 如果是 -> 说明轮到我了!再次尝试抢锁 (tryAcquire)。
      • 抢到了 -> 自己成为新的 head,方法返回。
      • 没抢到 -> 认命,准备睡觉。
    3. 如果不是 -> 认命,准备睡觉。
  • shouldParkAfterFailedAcquire() & parkAndCheckInterrupt() - 睡觉
    • 在睡觉前,会把自己前一个节点的 waitStatus 设为 SIGNAL(意思是:“前任大哥,你走的时候记得叫醒我”)。
    • 然后调用 LockSupport.park(this),当前线程被挂起,让出 CPU。

数据结构有哪些是线程安全的
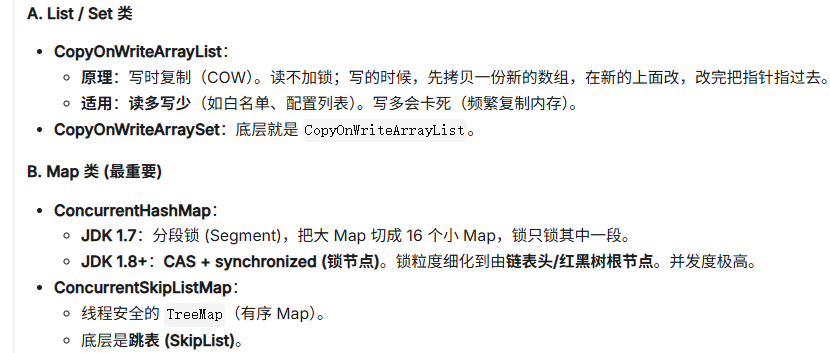
image-20260107162840535-1775809538968

image-20260107162857506-1775809509397


并发编程
https://kyy-logs.github.io/2026/04/10/语言/java/并发编程/
作者
Yangyang Kong
发布于
2026年4月10日
许可协议