Redis:实践
redis的持久化是怎么做的
redis有两种持久化机制:RDB和AOF。每种持久化机制各有优缺点,了解每种持久化机制的原理对我们使用Redis有很大的帮助。Redis4.0后支持RDB和AOF两种持久化机制混合使用,所以存在三种持久化策略。
(1)RDB持久化
RDB是基于快照一次的全量备份,即周期性的把redis当前内存中的全量数据写入到一个快照文件中(周期时间可以通过配置来调整)。redis是单线程程序,这个线程要同时负责多个客户端的读写请求,还要负责周期性的把当前内存中的数据写到快照文件中RDB中,数据写到RDB文件是IO操作,IO操作会严重影响redis的性能,甚至在持久化的过程中,读写请求会阻塞,为了解决这些问题,Redis采用多进程来同时进行读写请求和持久化操作。这样又会导致另外的问题,持久化的过程中,内存中的数据还在改变,假如redis正在进行持久化一个大的数据结构,在这个过程中客户端发送一个删除请求,把这个大的数据结构删掉了,这时候持久化的动作还没有完成,那么redis该怎么办呢?
————————————————
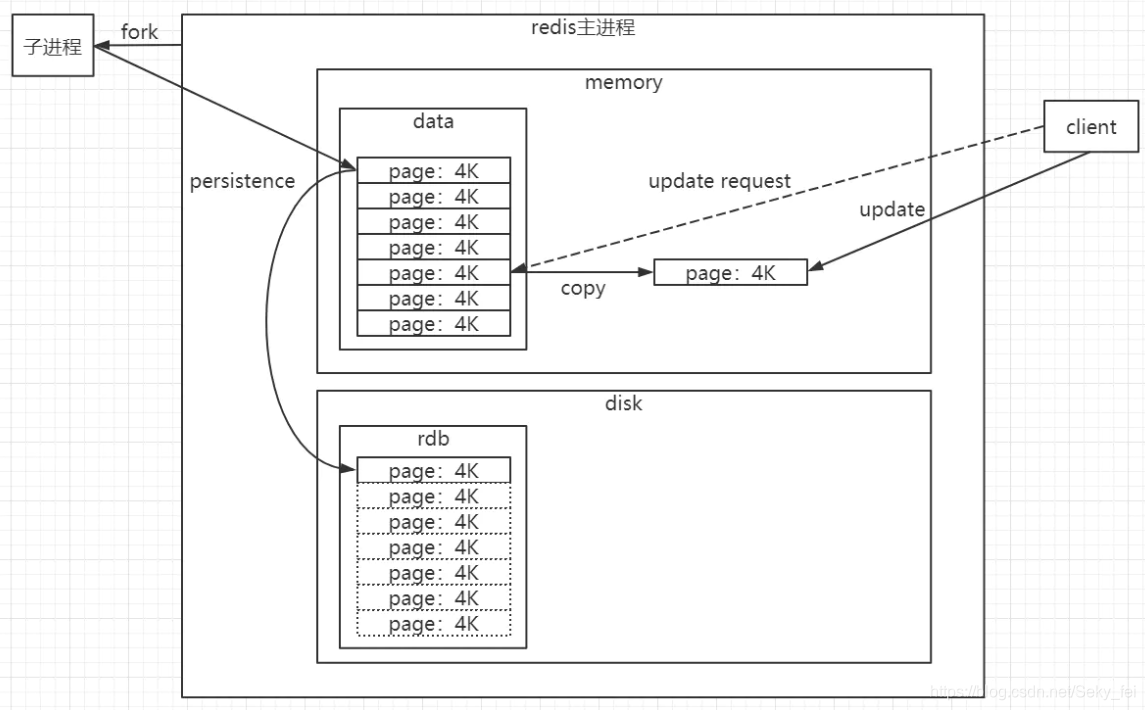
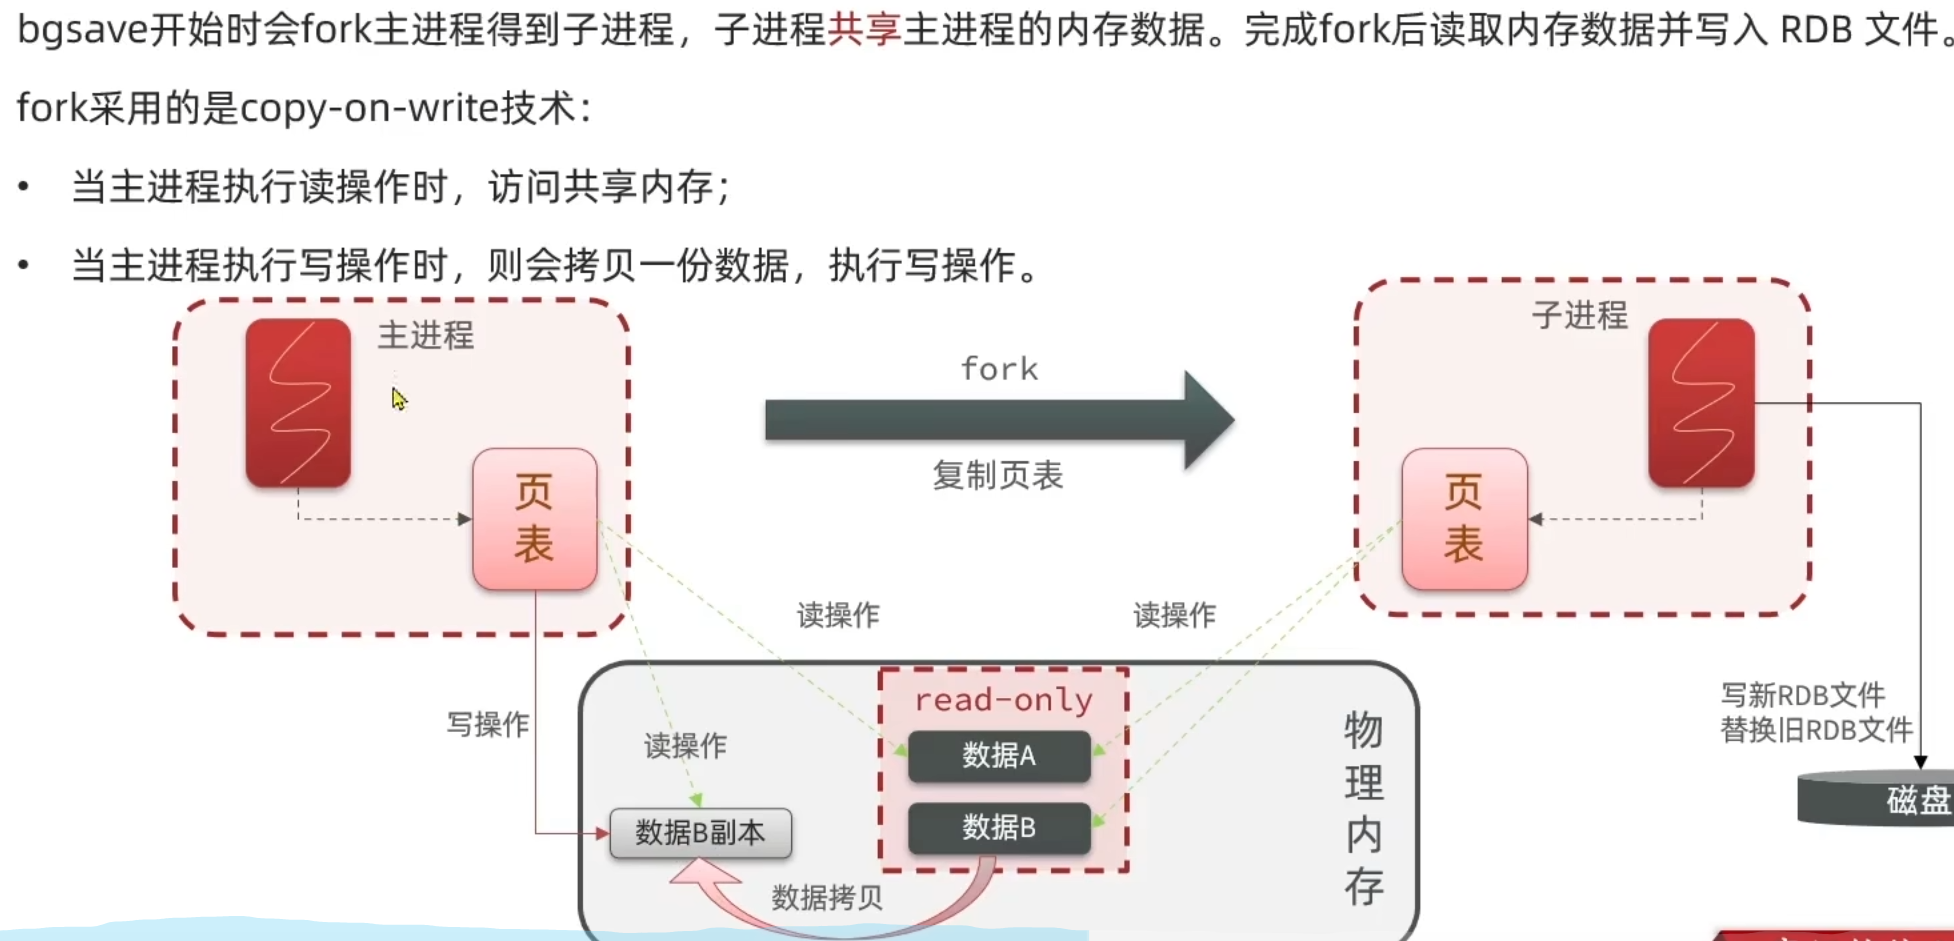
RDB持久化时,Redis会fork()一个子进程,快照持久化完全交给子进程来处理,父进程继续处理客户端的读写请求
子进程对当前内存中的数据进行持久化时,并不会修改当前的数据结构,如果父进程收到了读写请求,那么会把处理的那一部分数据复制一份到内存,对复制后的数据进行修改。所以即使对某个数据进行了修改,redis持久化到RDB中的数据也是未修改的数据,这也是把RDB文件称为”快照”文件的原因,子进程所看到的数据在它被创建的一瞬间就固定下来了,父进程修改的某个数据只是该数据的复制品。
———————————————
实际上,内存中的全量数据由一个个的”数据段页面”组成,每个数据段页面的大小为4K,客户端要修改的数据在哪个页面中,就会复制一份这个页面到内存中,这个复制的过程称为”页面分离”,在持久化过程中,随着分离出的页面越来越多,内存就会持续增长,但是不会超过原内存的2倍,因为在一次持久化的过程中,几乎不会出现所有的页面都会分离的情况,读写请求针对的只是原数据中的小部分,大部分redis数据还是”冷数据”。RDB过程整个过程如下图:
————————————————
热点数据和冷数据是什么
- 热点数据:读取频率高,如果不做缓存,给数据库造成很大的压力,可能被击穿。
- 冷数据:读取频率低,数据设置缓存后有可能没有被访问就被挤出内存(超时dele)。
(2)AOF持久化
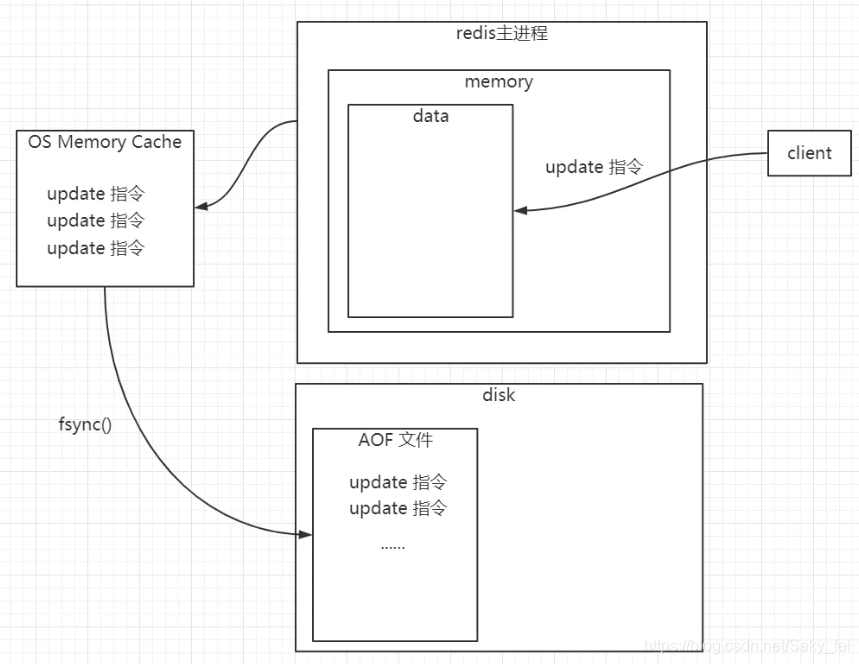
**AOF(Append-only file)日志存储的是redis服务器的顺序指令序列,即对内存中数据进行修改的指令记录。**当redis收到客户端修改指令后,先进行参数校验,如果校验通过,先把该指令存储到AOF日志文件中,也就是先存到磁盘,然后再执行该修改指令。
redis把操作指令追加到AOF文件这个过程,并不是直接写到AOF文件中,而是先写到操作系统的内存缓存中,这个内存缓存是由操作系统内核分配的,然后操作系统内核会异步地把内存缓存中的redis操作指令刷写到AOF文件中。当redis宕机后重启后,可以读取该AOF文件中的指令,进行数据恢复,恢复的过程就是把记录的指令再顺序执行一次,这样就可以恢复到宕机之前的状态。
————————————————
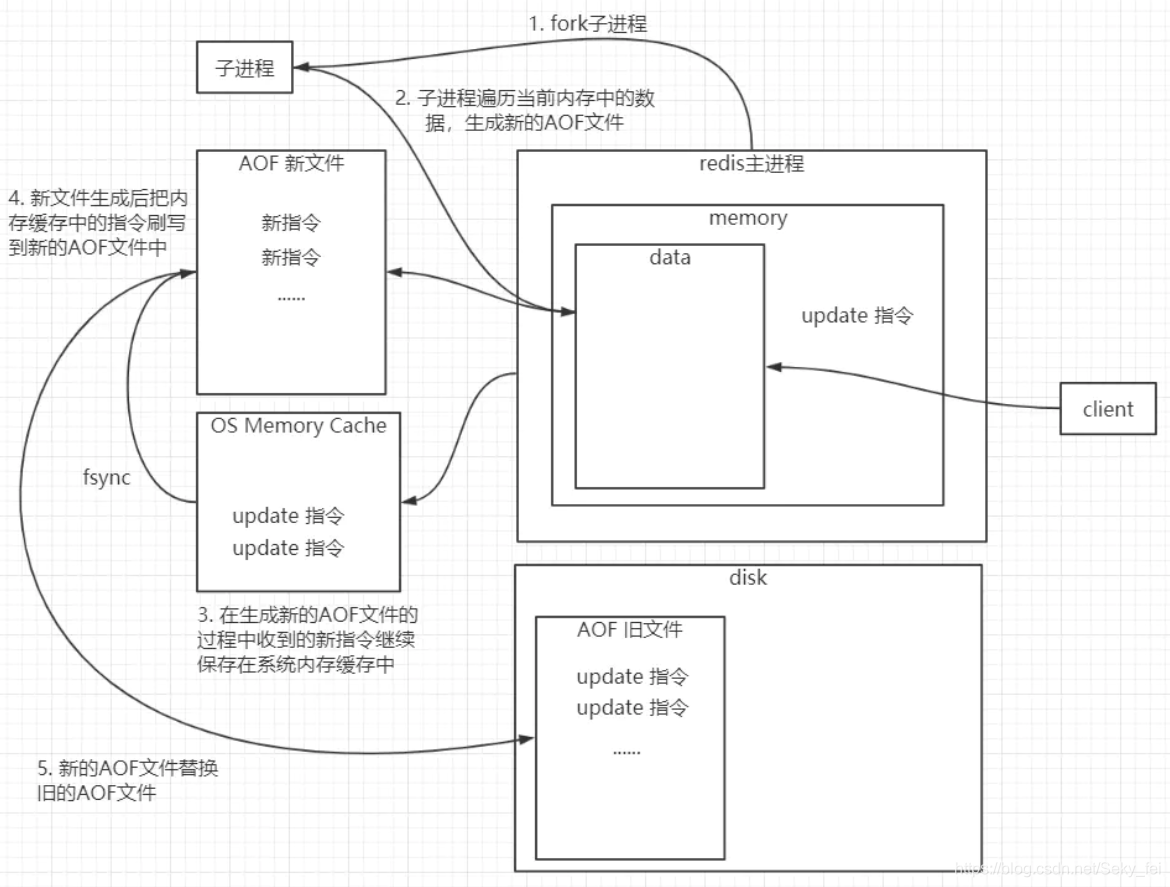
redis在长期运行过程中,AOF日志会越来越大,如果redis服务重启后根据很大的AOF文件来顺序执行指令,将会非常耗时,导致redis服务长时间无法对外提供服务,所以需要对AOF文件进行**”瘦身”。“瘦身”的过程称作AOF重写(rewrite)。**
AOF Rewrite 的原理是,主进程fork一个子进程,对当前内存中的数据进行遍历,转换成一系列的redis操作指令,并序列化到一个新的AOF日志中,然后把序列化操作期间新收到的操作指令追加到新的AOF文件中,追加完毕后就立即替换旧的AOF文件,这样就完成了”瘦身”工作,即AOF Rewrite。AOF Rewrite过程如下图:
————————————————
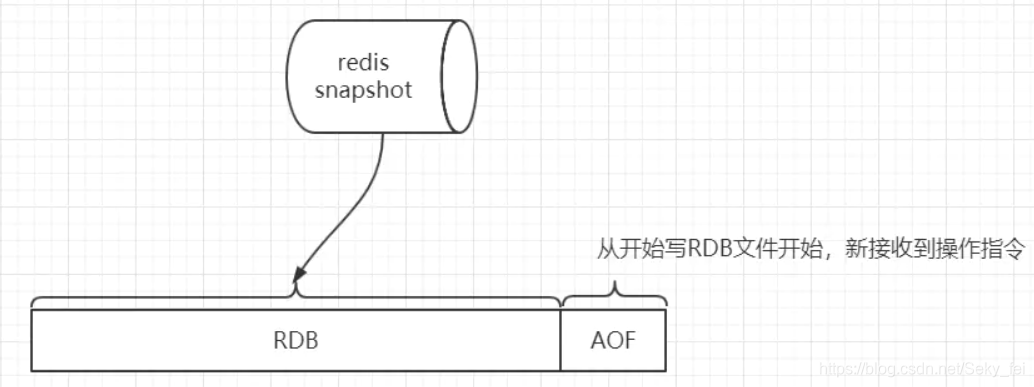
(3)混合持久化(其实就是RDB持久化后,再下一次RDB持久化前写入AOF)
redis-4.x后支持了RDB和AOF混合使用。重启redis时,我们很少使用RDB来恢复内存状态,因为会丢失大量数据。我们通常使用AOF日志重放,但是重放AOF日志性能相对RDB来说要慢很多,这样在redis实例很大的情况下,启动需要花费很长的时间。redis-4.0为了解决这个问题,带来了一个新的持久化选项——混合持久化。将RDB文件的内容和增量的AOF日志文件存在一起,这里的AOF日志不再是全量 的日志,而是RDB久化开始 到 RDB持久化结束的这段时间发生的增量AOF日志,通常这部分AOF日志很小。redis-4.x混合持久化机制如下图:
3.redis 持久化机制对比
(1)RDB的优缺点
优点:
RDB会生成多个数据文件,每个数据文件都代表了某一个时刻中redis的数据,这种多个数据文件的方式,非常适合做冷备,可以将这种完整的数据文件发送到一些远程的安全存储上去。
生成RDB文件的时候,主进程不需要进行任何磁盘IO操作。当进行RDB持久化时,对redis服务处理读写请求的影响非常小,可以让redis保持高性能,因为redis主进程只需要fork一个子进程,让子进程执行磁盘IO操作来进行RDB持久化即可。生成一次RDB文件的过程就是把当前时刻内存中的数据一次性写入文件中,而AOF则需要先把当前内存中的小量数据转换为操作指令,然后把指令写到内存缓存中,然后再刷写入磁盘。
RDB 在恢复大数据集时的速度比 AOF 的恢复速度要快。AOF存放的是指令日志,做数据恢复的时候,要回放和执行所有的指令日志,从而恢复内存中的所有数据;而RDB,就是一份数据文件,恢复的时候,直接加载到内存中即可。
缺点:
RDB方式数据没办法做到实时持久化/秒级持久化,会导致数据丢失。一般来说,RDB数据快照文件,都是每隔5分钟,或者更长时间生成一次,这个时候就得接受一旦redis进程宕机,那么会丢失最近5分钟的数据。这个问题,也是RDB最大的缺点,就是不适合做第一优先的恢复方案,如果你依赖RDB做第一优先恢复方案,会导致数据丢失的比较多。
RDB每次在fork子进程来执行RDB快照数据文件生成的时候,如果数据文件特别大,可能会导致对客户端提供的服务暂停数毫秒,甚至数秒。所以一般不要让生成RDB文件的间隔太长,否则每次生成的RDB文件太大了,对redis本身的性能会有影响。
(2)AOF的优缺点
优点:
AOF可以更好的保护数据不丢失,一般AOF会每隔1秒,通过一个后台线程执行一次fsync操作,最多丢失1秒钟的数据。
AOF日志文件以append-only模式(追加)写入,所以没有任何磁盘寻址的开销,写入性能非常高,而且文件不容易破损,即使文件尾部破损,也很容易修复。
AOF日志文件即使过大的时候,出现后台重写操作,也不会影响客户端的读写。因为在rewrite的时候,会对其中的指令进行压缩,会创建出一份需要恢复数据的最小日志出来。
AOF日志文件的命令通过非常可读的方式进行记录,这个特性非常适合做灾难性的误删除的紧急恢复。比如某人不小心用flushall命令清空了所有数据,只要这个时候后台rewrite还没有发生,那么就可以立即拷贝AOF文件,将最后一条flushall命令给删了,然后再将该AOF文件放回去,就可以通过恢复机制,自动恢复所有数据。
缺点:
对于同一份数据来说,AOF日志文件通常比RDB数据快照文件更大。因为AOF是指令文件,RDB是二进制文件。
AOF的写性能比RDB的写性能低,因为AOF一般会配置成每秒fsync一次日志文件,当然,每秒一次fsync,性能也还是很高的,只不过比起RDB来说性能低,如果要保证一条数据都不丢,也是可以的,AOF的fsync设置成每写入一条数据,fsync一次,但是这样,redis的性能会大大下降。
基于AOF文件做恢复的速度不如基于RDB文件做恢复的速度。
4.如何选择redis持久化机制
RDB和AOF到底该如何选择
不要仅仅使用RDB,因为那样会导致丢失很多数据。
也不要仅仅使用AOF,一是数据恢复慢,二是可靠性也不如RDB,毕竟RDB文件中存储的就是某一时刻实实在在的数据,而AOF只是操作指令,把数据转换为操作指令不一定是百分百没问题的。
综合使用AOF和RDB两种持久化机制,用AOF来保证数据不丢失,作为数据恢复的第一选择; 用RDB来做不同程度的冷备,在AOF文件都丢失或损坏不可用的时候,还可以使用RDB来进行快速的数据恢复。
介绍一下缓存穿透、缓存雪崩、缓存击穿和你的解决方案。
1.缓存击穿(4点)
描述:
缓存击穿是指缓存中没有但数据库中有的数据(一般是缓存时间到期),这时由于并发用户特别多,同时读缓存没读到数据,又同时去数据库去取数据,引起数据库压力瞬间增大,造成过大压力。
解决方案:
1、设置热点数据永远不过期。
**2、接口限流与熔断,降级。**重要的接口一定要做好限流策略,防止用户恶意刷接口,同时要降级准备,当接口中的某些 服务 不可用时候,进行熔断,失败快速返回机制
3、布隆过滤器(解决缓存穿透的,写错了)。bloomfilter就类似于一个hash set,用于快速判某个元素是否存在于集合中,其典型的应用场景就是快速判断一个key是否存在于某容器,不存在就直接返回。布隆过滤器的关键就在于hash算法和容器大小。
布隆过滤器的优点:
- 时间复杂度低,增加和查询元素的时间复杂为O(N),(N为哈希函数的个数,通常情况比较小)
- 保密性强,布隆过滤器不存储元素本身
- 存储空间小,如果允许存在一定的误判,布隆过滤器是非常节省空间的(相比其他数据结构如Set集合)
布隆过滤器的缺点:
- 有点一定的误判率,但是可以通过调整参数来降低
- 无法获取元素本身
- 很难删除元素
布隆过滤器可以告诉我们 “某样东西一定不存在或者可能存在”,也就是说布隆过滤器说这个数不存在则一定不存,布隆过滤器说这个数存在可能不存在(误判,后续会讲)
数据结构
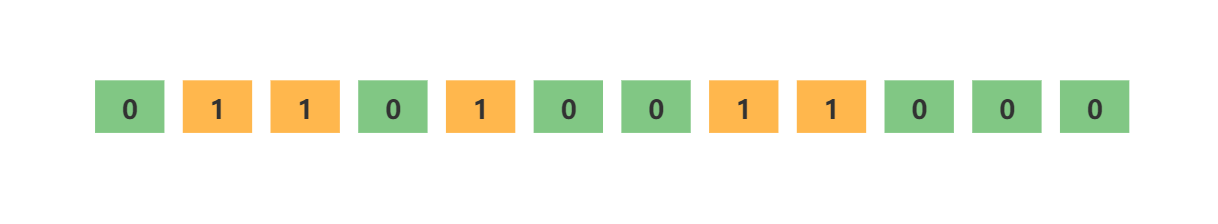
布隆过滤器它实际上是一个很长的二进制向量和一系列随机映射函数。以Redis中的布隆过滤器实现为例,Redis中的布隆过滤器底层是一个大型位数组(二进制数组)+多个无偏hash函数。
一个大型位数组(二进制数组):
多个无偏hash函数:
无偏hash函数就是能把元素的hash值计算的比较均匀的hash函数,能使得计算后的元素下标比较均匀的映射到位数组中。
如下就是一个简单的布隆过滤器示意图,其中k1、k2代表增加的元素,a、b、c即为无偏hash函数,最下层则为二进制数组。
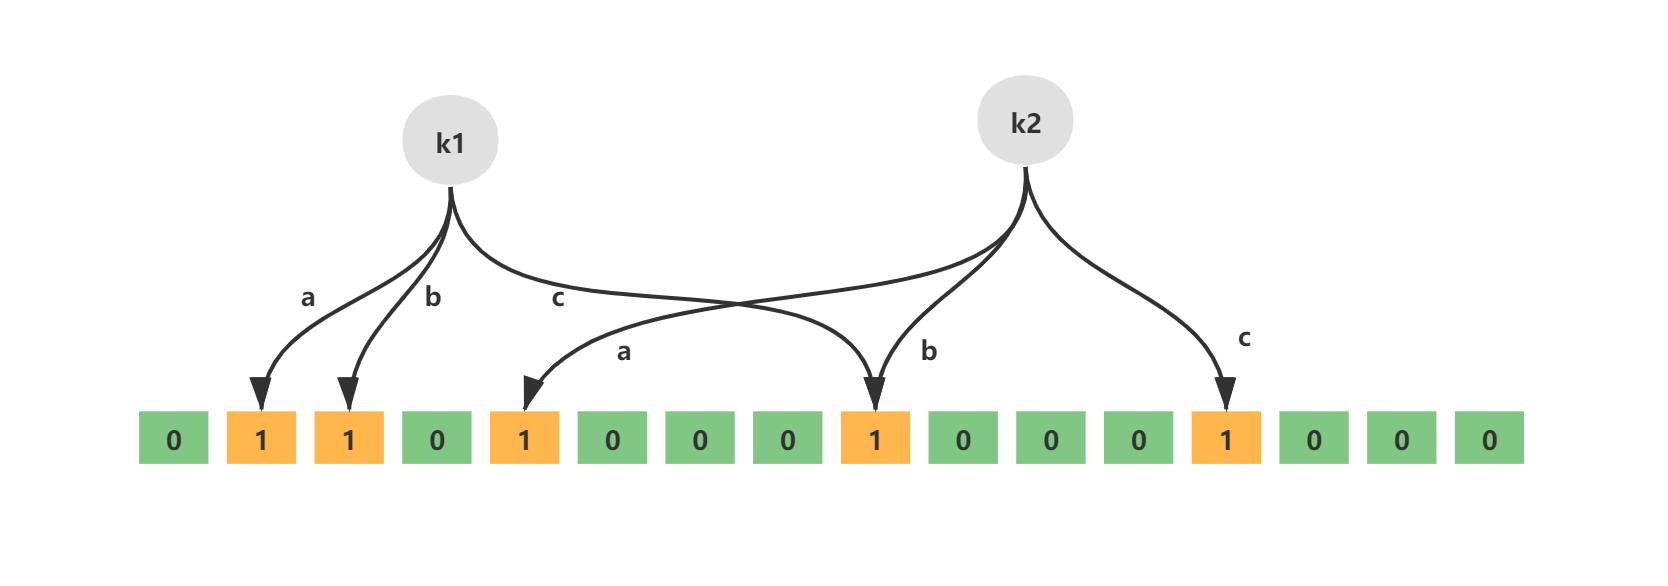
在布隆过滤器增加元素之前,首先需要初始化布隆过滤器的空间,也就是上面说的二进制数组,除此之外还需要计算无偏hash函数的个数。布隆过滤器提供了两个参数,分别是预计加入元素的大小n,运行的错误率f。布隆过滤器中有算法根据这两个参数会计算出二进制数组的大小l,以及无偏hash函数的个数k。
它们之间的关系比较简单:
- 错误率越低,位数组越长,控件占用较大
- 错误率越低,无偏hash函数越多,计算耗时较长
增加元素
往布隆过滤器增加元素,添加的key需要根据k个无偏hash函数计算得到多个hash值,然后对数组长度进行取模得到数组下标的位置,然后将对应数组下标的位置的值置为1
- 通过k个无偏hash函数计算得到k个hash值
- 依次取模数组长度,得到数组索引
- 将计算得到的数组索引下标位置数据修改为1
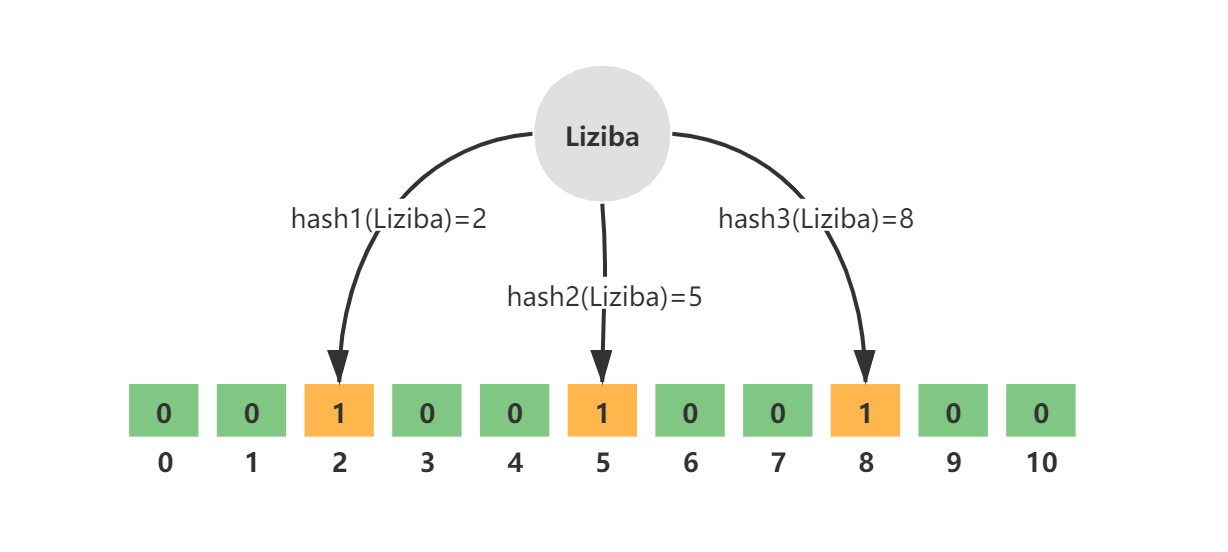
例如,key = Liziba,无偏hash函数的个数k=3,分别为hash1、hash2、hash3。三个hash函数计算后得到三个数组下标值,并将其值修改为1.
如图所示:
查询元素
隆过滤器最大的用处就在于判断某样东西一定不存在或者可能存在,而这个就是查询元素的结果。其查询元素的过程如下:
- 通过k个无偏hash函数计算得到k个hash值
- 依次取模数组长度,得到数组索引
- 判断索引处的值是否全部为1,如果全部为1则存在(这种存在可能是误判),如果存在一个0则必定不存在
解决缓存击穿的思路
1 | |
4.双重检查锁
5.异步更新 + 逻辑过期
缓存中存入
value + expireTime,即使过期仍返回旧数据。启动后台线程或消息队列异步更新缓存,避免阻塞请求线程。
2.缓存穿透(增加参数校验与黑名单拦截机制)
描述:
缓存穿透说简单点就是大量请求的 key 是不合理的,根本不存在于缓存中,也不存在于数据库中 。这就导致这些请求直接到了数据库上,根本没有经过缓存这一层,对数据库造成了巨大的压力,可能直接就被这么多请求弄宕机了。
解决办法:
最基本的就是首先做好参数校验,一些不合法的参数请求直接抛出异常信息返回给客户端。比如查询的数据库 id 不能小于 0、传入的邮箱格式不对的时候直接返回错误消息给客户端等等。
如果缓存和数据库都查不到某个 key 的数据就写一个到 Redis 中去并设置过期时间,具体命令如下:
SET key value EX 10086。这种方式可以解决请求的 key 变化不频繁的情况,如果黑客恶意攻击,每次构建不同的请求 key,会导致 Redis 中缓存大量无效的 key 。很明显,这种方案并不能从根本上解决此问题。如果非要用这种方式来解决穿透问题的话,尽量将无效的 key 的过期时间设置短一点比如 1 分钟。布隆过滤器。bloomfilter就类似于一个hash set,用于快速判某个元素是否存在于集合中,其典型的应用场景就是快速判断一个key是否存在于某容器,不存在就直接返回。布隆过滤器的关键就在于hash算法和容器大小。
布隆过滤器的优点:
- 时间复杂度低,增加和查询元素的时间复杂为O(N),(N为哈希函数的个数,通常情况比较小)
- 保密性强,布隆过滤器不存储元素本身
- 存储空间小,如果允许存在一定的误判,布隆过滤器是非常节省空间的(相比其他数据结构如Set集合)
布隆过滤器的缺点:
- 有点一定的误判率,但是可以通过调整参数来降低
- 无法获取元素本身
- 很难删除元素
布隆过滤器可以告诉我们 “某样东西一定不存在或者可能存在”,也就是说布隆过滤器说这个数不存在则一定不存,布隆过滤器说这个数存在可能不存在(误判,后续会讲)
数据结构
布隆过滤器它实际上是一个很长的二进制向量和一系列随机映射函数。以Redis中的布隆过滤器实现为例,Redis中的布隆过滤器底层是一个大型位数组(二进制数组)+多个无偏hash函数。
一个大型位数组(二进制数组): 多个无偏hash函数:
无偏hash函数就是能把元素的hash值计算的比较均匀的hash函数,能使得计算后的元素下标比较均匀的映射到位数组中。如下就是一个简单的布隆过滤器示意图,其中k1、k2代表增加的元素,a、b、c即为无偏hash函数,最下层则为二进制数组。
在布隆过滤器增加元素之前,首先需要初始化布隆过滤器的空间,也就是上面说的二进制数组,除此之外还需要计算无偏hash函数的个数。布隆过滤器提供了两个参数,分别是预计加入元素的大小n,运行的错误率f。布隆过滤器中有算法根据这两个参数会计算出二进制数组的大小l,以及无偏hash函数的个数k。
它们之间的关系比较简单:- 错误率越低,位数组越长,控件占用较大
- 错误率越低,无偏hash函数越多,计算耗时较长
增加元素
往布隆过滤器增加元素,添加的key需要根据k个无偏hash函数计算得到多个hash值,然后对数组长度进行取模得到数组下标的位置,然后将对应数组下标的位置的值置为1
- 通过k个无偏hash函数计算得到k个hash值
- 依次取模数组长度,得到数组索引
- 将计算得到的数组索引下标位置数据修改为1
例如,key = Liziba,无偏hash函数的个数k=3,分别为hash1、hash2、hash3。三个hash函数计算后得到三个数组下标值,并将其值修改为1.
如图所示: 查询元素
隆过滤器最大的用处就在于判断某样东西一定不存在或者可能存在,而这个就是查询元素的结果。其查询元素的过程如下:
- 通过k个无偏hash函数计算得到k个hash值
- 依次取模数组长度,得到数组索引
- 判断索引处的值是否全部为1,如果全部为1则存在(这种存在可能是误判),如果存在一个0则必定不存在
解决缓存穿透的思路
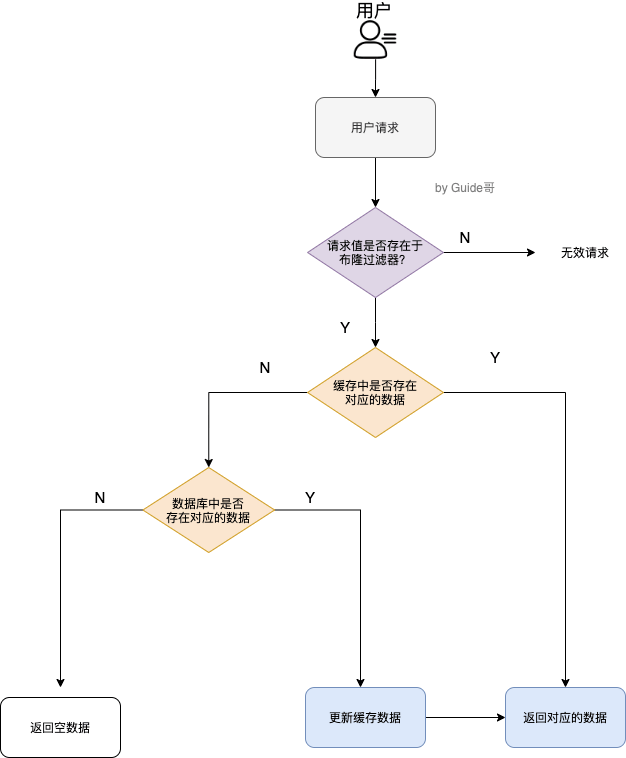
- 限流
3.缓存雪崩
实际上,缓存雪崩描述的就是这样一个简单的场景:缓存在同一时间大面积的失效,导致大量的请求都直接落到了数据库上,对数据库造成了巨大的压力。 这就好比雪崩一样,摧枯拉朽之势,数据库的压力可想而知,可能直接就被这么多请求弄宕机了。
举个例子:数据库中的大量数据在同一时间过期,这个时候突然有大量的请求需要访问这些过期的数据。这就导致大量的请求直接落到数据库上,对数据库造成了巨大的压力。
解决办法:
Redis 集群:采用 Redis 集群,避免单机出现问题整个缓存服务都没办法使用。Redis Cluster 和 Redis Sentinel 是两种最常用的 Redis 集群实现方案
多级缓存:设置多级缓存,例如本地缓存+Redis 缓存的二级缓存组合,当 Redis 缓存出现问题时,还可以从本地缓存中获取到部分数据,使用本地缓存和分布式缓存相结合的方式。当分布式缓存失效时,本地缓存可以作为一个备份,减少对数据库的直接压力。。
针对大量缓存同时失效的情况:
设置随机失效时间(可选):为缓存设置随机的失效时间,例如在固定过期时间的基础上加上一个随机值,这样可以避免大量缓存同时到期,从而减少缓存雪崩的风险。
提前预热(推荐):针对热点数据提前预热,将其存入缓存中并设置合理的过期时间比如秒杀场景下的数据在秒杀结束之前不过期,在缓存即将过期前,后台异步更新缓存数据,这样可以避免大量请求同时击中数据库。也可以在缓存快要过期前,后台服务异步提前加载并刷新缓存。比如设置定时任务提前刷新热点数据,避免过期瞬间数据库被打爆。有些系统会在缓存接近过期时(比如还剩 10% TTL)自动触发一次后台刷新。
持久缓存策略(看情况):虽然一般不推荐设置缓存永不过期,但对于某些关键性和变化不频繁的数据,可以考虑这种策略。
缓存预热实现
常见的缓存预热方式有两种:
- 使用定时任务,比如 xxl-job,来定时触发缓存预热的逻辑,将数据库中的热点数据查询出来并存入缓存中。
- 使用消息队列,比如 Kafka,来异步地进行缓存预热,将数据库中的热点数据的主键或者 ID 发送到消息队列中,然后由缓存服务消费消息队列中的数据,根据主键或者 ID 查询数据库并更新缓存。
分布式锁为什么选择redisson
说说双写一致性怎么保障,双写时如果mysql写入成功redis写入失败怎么办((八)漫谈分布式之缓存篇:唠唠老生常谈的MySQL与Redis数据一致性问题!缓存既能减轻数据库压力,还能加快请求响应速 - 掘金)
分布式系统中的一致性指的是在多个节点上存储和处理数据时,确保系统中的数据在不同节点之间保持一致的特性。在分布式系统中,一致性通常可以分为以下几个类别:
**1.强一致性:**所有节点在任何时间都看到相同的数据。任何更新操作都会立即对所有节点可见,保证了数据的强一致性。这意味着,如果一个节点完成了写操作,那么所有其他节点读取相同的数据之后,都将看到最新的结果。强一致性通常需要付出更高的代价,例如增加通信开销和降低系统的可用性。
**2.弱一致性:**系统中的数据在某些情况下可能会出现不一致的状态,但最终会收敛到一致状态。弱一致性下的系统允许在一段时间内,不同节点之间看到不同的数据状态。弱一致性通常用于需要在性能和一致性之间进行权衡的场景,例如缓存系统等。
3.最终一致性:是弱一致性的一种特例,它保证了在经过一段时间后,系统中的所有节点最终都会达到一致状态。尽管在数据更新时可能会出现一段时间的不一致,但最终数据会收敛到一致状态。
为什么操作缓存的时候是删除旧缓存而不是直接更新缓存?
我们举例模拟下并发环境下的更新DB&缓存:
- 线程A先发起一个写操作,第一步先更新数据库,然后更新缓存
- 线程B再发起一个写操作,第二步更新了数据库,然后更新缓存
当以上两个线程的执行,如果严格先后顺序执行,那么对于更新缓存还是删除缓存去操作缓存都可以,但是如果两个线程同时执行时,由于网络或者其他原因,导致线程B先执行完更新缓存,然后线程A才会更新缓存。如下图: 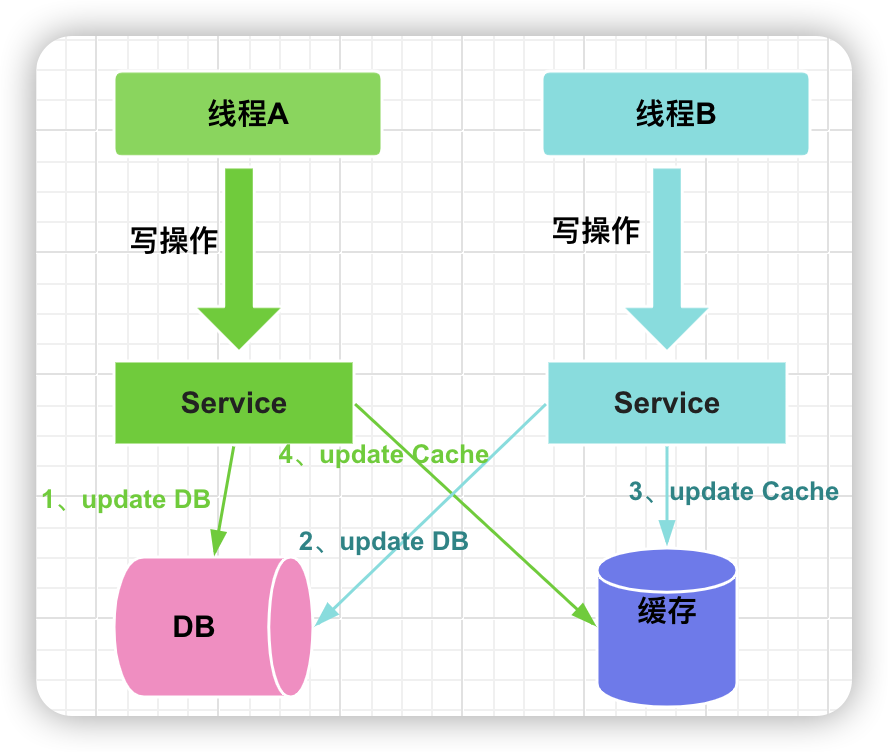
这时候缓存中保存的就是线程A的数据,而数据库中保存的是线程B的数据。这时候如果读取到的缓存就是脏数据。但是如果使用删除缓存取代更新缓存,那么就不会出现这个脏数据。尽管这种方法可能会增加一次数据库访问的成本,但在实际应用中,考虑到数据的一致性和系统的健壮性,这是值得付出的折衷。
为什么是先操作数据库再操作缓存?
在操作缓存时,为什么要先操作数据库而不是先操作缓存?我们同样举例模拟两个线程,线程A写入数据,先删除缓存在更新DB,线程B读取数据。流程如下:
线程A发起一个写操作,第一步删除缓存
此时线程B发起一个读操作,缓存中没有,则继续读DB,读出来一个老数据
然后线程B把老数据放入缓存中
线程A更新DB数据
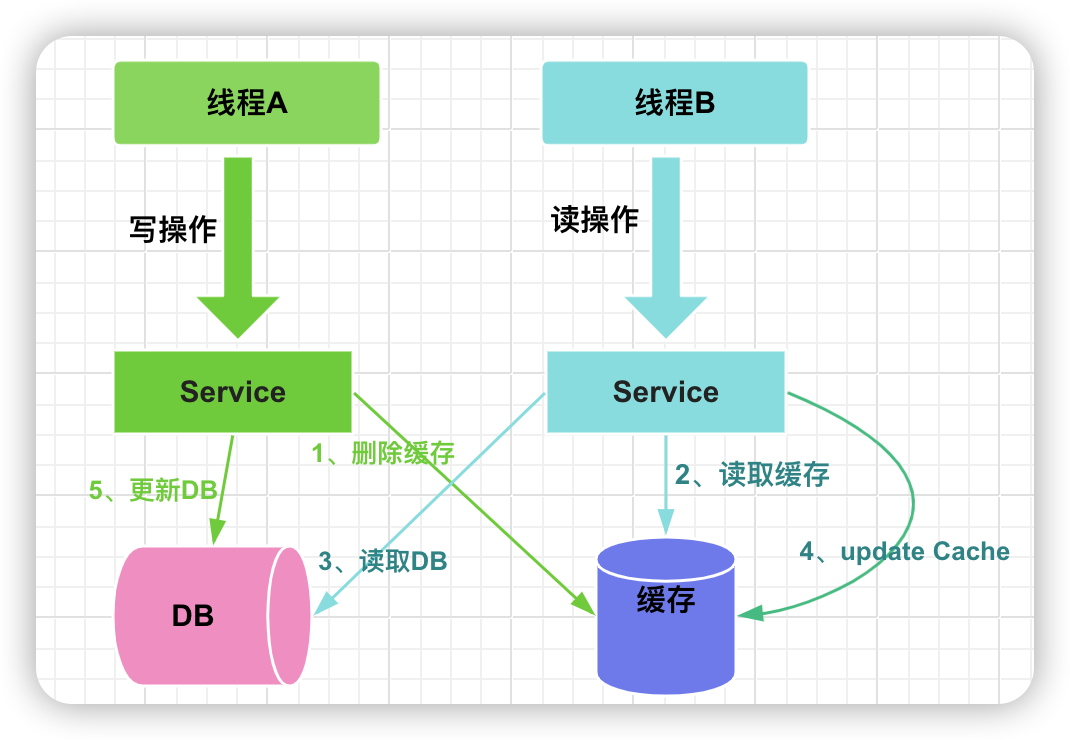
所以这样就会出现缓存中存储的是旧数据,而数据库中存储的是新数据,这样就出现脏数据,所以我们一般都采取先操作数据库,在操作缓存。
解决双写一致性问题的3种方案
1. 延时双删策略,延迟要覆盖住用户重新读数据库并回写缓存 的这段时间
延时双删策略主要用于解决在高并发场景下,由于网络延迟、并发控制等原因造成的数据库与缓存数据不一致的问题。
当更新数据库时,首先删除对应的缓存项,以确保后续的读请求会从数据库加载最新数据。
但是由于网络延迟或其他不确定性因素,删除缓存与数据库更新之间可能存在时间窗口,导致在这段时间内的读请求从数据库读取数据后写回缓存,新写入的缓存数据可能还未反映出数据库的最新变更。
所以为了解决这个问题,延时双删策略在第一次删除缓存后,设定一段短暂的延迟时间,如几百毫秒,然后在这段延迟时间结束后再次尝试删除缓存。这样做的目的是确保在数据库更新传播到所有节点,并且在缓存中的旧数据彻底过期失效之前,第二次删除操作可以消除缓存中可能存在的旧数据,从而提高数据一致性。
1 | |
2.删除缓存重试机制(与消费失败的场景很像)
删除缓存重试机制是在删除缓存操作失败时,设定一个重试策略,确保缓存最终能被正确删除,以维持与数据库的一致性。
使用同步重试:捕获删除缓存的异常,设置最大重试次数(如3次),每次失败后短暂休眠(如100ms)后重试。
使用异步重试:将删除缓存的任务放入消息队列(如Kafka、RabbitMQ)或任务调度器,异步重试,避免阻塞主线程。
将失败的删除任务记录到数据库或消息队列,定期通过定时任务(如Spring Scheduler、Quartz)重新尝试删除,当重试次数超过一定的次数,记录日志,触发报警,通知。
总结:短TTL+重试+异步补偿:1.为缓存设置短TTL,降低不一致窗口。2.删除失败时,同步重试2-3次。3.重试仍失败,记录到异步补偿任务,定时重试。4.配合日志和报警,及时发现异常。
3.监听并读取biglog异步删除缓存
在数据库发生写操作时,将变更记录在binlog或类似的事务日志中,然后使用一个专门的异步服务或者监听器订阅binlog的变化(比如Canal),一旦检测到有数据更新,便根据binlog中的操作信息定位到受影响的缓存项。讲这些需要更新缓存的数据发送到消息队列,消费者处理消息队列中的事件,异步地删除或更新缓存中的对应数据,确保缓存与数据库保持一致。
这种方法的好处是将缓存的更新操作与主业务流程解耦,避免阻塞主线程,同时还能处理数据库更新后由于网络问题或并发问题导致的缓存更新滞后情况。当然,实现这一策略相对复杂,需要对数据库的binlog机制有深入理解和定制开发。
4.总结
在分布式系统中,为了保证缓存与数据库双写一致性,可以采用以下方案:
- 读取操作:
- 先尝试从缓存读取数据,若缓存命中,则直接返回缓存中的数据。
- 若缓存未命中,则从数据库读取数据,并将数据放入缓存。
- 更新操作:
- 在更新数据时,首先在数据库进行写入操作,确保主数据库数据的即时更新。
- 为了减少数据不一致窗口,采用异步方式处理缓存更新,具体做法是监听数据库的binlog事件,异步进行删除缓存。
- 在一主多从的场景下,为了确保数据一致性,需要等待所有从库的binlog事件都被处理后才删除缓存(确保全部从库均已更新)。
- 同时,还需注意以下要点:
- 对于高并发环境,可能需要结合分布式锁、消息队列或缓存失效延时等技术,进一步确保并发写操作下的数据一致性。
- 异步处理binlog时,务必考虑异常处理机制和重试策略,确保binlog事件能够正确处理并执行缓存更新操作。
说说redis的数据结构,实现原理及其功能和应用
1.String类型
底层实现是SDS(simple dynamic string),中文翻译为简单动态字符串。它是一个动态字符串结构,*由长度、空闲空间和字节数组三部分组成*。
通过维护 len 属性,实现了
1
O(1)获取长度。
不依赖 \0 结尾,保证了二进制安全。
通过空间预分配和惰性释放机制,大大减少了内存重分配的次数,提升了性能。
自动扩容机制也解决了 C 语言常见的缓冲区溢出问题。”
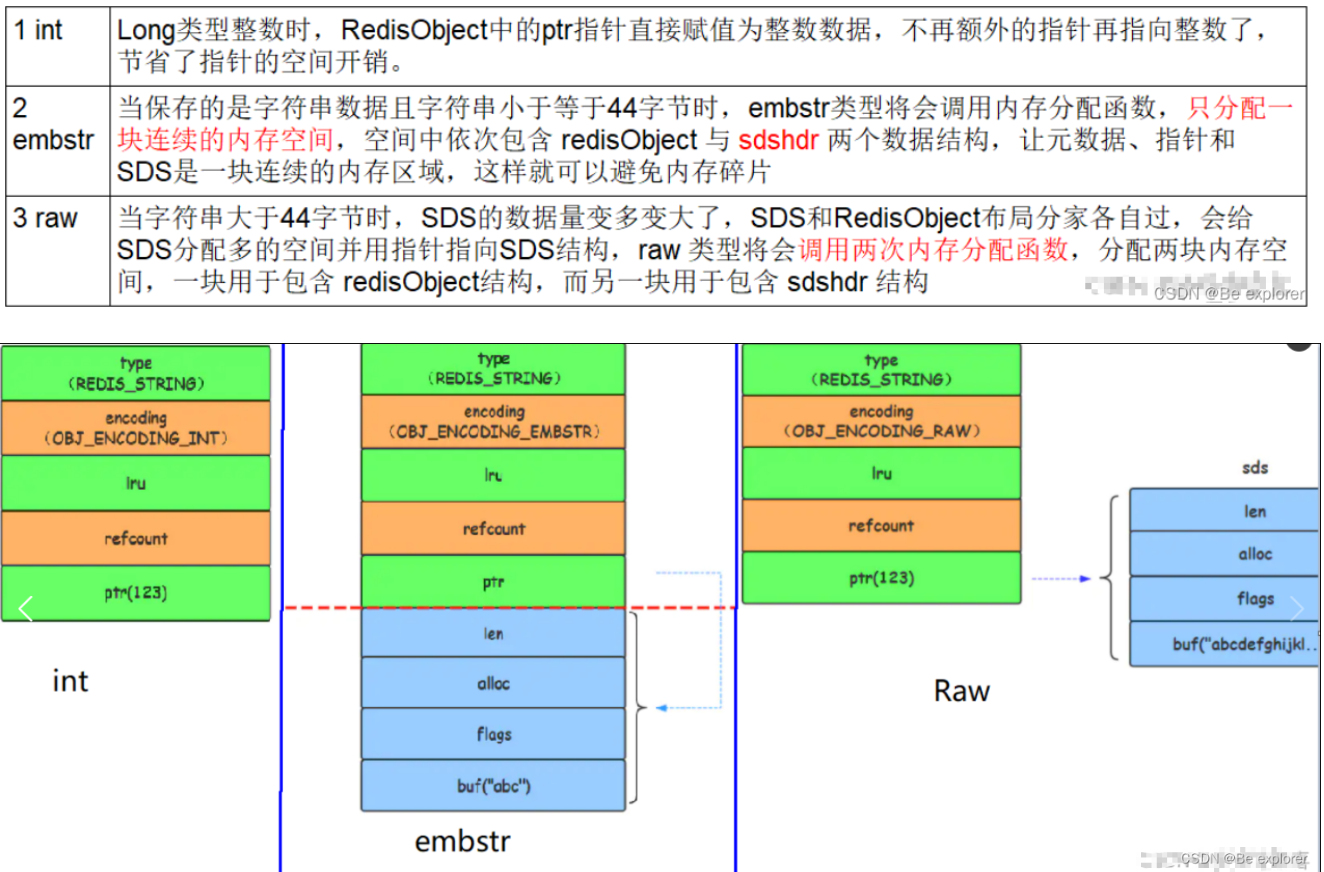
SDS有三种编码类型:
1、embstr:占用64Bytes的空间,存储44Bytes的数据
2、raw:存储大于44Bytes的数据
3、int:存储整数类型
常见应用场景
1、缓存数据,提高访问速度和降低数据库压力;
2、计数器,利用incr和decr命令实现原子性的加减操作;
3、分布式锁,利用setnx实现互斥访问;
4、限流,利用exprie命令实现窗口内的访问控制
2.Hash数据(【Redis】五大常见的数据类型之 Hash我们都知道 Redis 提供了丰富的数据类型,常见的有五种:String,H - 掘金)(Redis 底层数据结构 listpacklistpack 为什么要存在?其底层实现是怎样的?和 ZipList 有什么 - 掘金)
Redis 中的 Hash 结构(字典 dict),底层的实现方案非常精妙,面试的重点是它的 渐进式 Rehash 机制。
1. 底层数据结构
Redis 的 Hash 底层本质上是一个数组 + 链表(和 Java 1.7 的 HashMap 类似,用链地址法解决哈希冲突)。
- 它的核心结构是一个叫 dictht(哈希表)的结构体。
- 每个字典(dict)内部包含了两个哈希表 (ht[0] 和 ht[1])。平时只用 ht[0]。
2. 为什么要两个哈希表?(为了 Rehash)
当 Hash 里的元素越来越多,哈希冲突变严重,链表变长,查询效率会下降,必须扩容 (Rehash)。
- Java 的做法:一次性分配个两倍大的新数组,把老数组的数据全部重新计算 Hash 搬过去。如果数据有几百万,这个动作会卡顿几百毫秒。
- Redis 能这么干吗? 绝对不能! 因为 Redis 是单线程处理命令的,如果一次性搬运几百万数据,会导致整个 Redis 卡死,其他客户端的请求全部超时。
3. Redis 的神操作:渐进式 Rehash (Progressive Rehash)
为了不阻塞主线程,Redis 采用了“愚公移山”的策略:
- 准备新表:给 ht[1] 分配足够大的空间。
- 打个标记:把字典中的 rehashidx 设为 0,表示 Rehash 开始。
- 分批搬运(关键点):
- 在 Rehash 期间,Redis 每次处理该字典的客户端请求(如增删改查)时,会顺手把 ht[0] 在 rehashidx 索引上的**那一个桶(链表)**里的数据,迁移到 ht[1] 上。
- 迁移完一个桶,rehashidx 加 1。
- 后台还有个定时任务,如果系统空闲,也会帮忙搬一点。
- 完成:当 ht[0] 全搬空了,把 ht[1] 变成新的 ht[0],并把 rehashidx 设为 -1,宣告结束。
4. Rehash 期间怎么查数据?
- 查/改/删:先去 ht[0] 查,找不到再去 ht[1] 查。
- 增 (Add):只向 ht[1] 里添加。保证 ht[0] 的数据只会越来越少。
hash呢,它是一个string类型的field和value的映射表,一个key可对应多个field,一个field对应一个value;其中value只能是字符串,不能嵌套其他类型。
Hash本身也是一个KV的结构,类似于Java中的HashMap。外层的哈希(RedisKV的实现)只用到了hashtable。当存储hash数据类型时,我们把它叫做内层的哈希。内层的哈希底层可以使用两种数据结构实现:
ziplist:OBJ_ENCODING_ZIPLIST(压缩列表)
hashtable:OBJ_ENCODING_HT(hash表)
1 | |
常见的应用场景
- 举例:用户信息、商品信息、文章信息、购物车信息。
- 相关命令:
HSET(设置单个字段的值)、HMSET(设置多个字段的值)、HGET(获取单个字段的值)、HMGET(获取多个字段的值)
3.Set集合
Redis 中的 Set 类型是一种无序集合,集合中的元素没有先后顺序但都唯一,有点类似于 Java 中的 HashSet 。当你需要存储一个列表数据,又不希望出现重复数据时,Set 是一个很好的选择,并且 Set 提供了判断某个元素是否在一个 Set 集合内的重要接口,这个也是 List 所不能提供的。
Redis 的 Set 底层并不只有哈希结构,而是有两种实现方式。当集合元素全部为整数且数量较少时,会使用 intset 整数集合存储;当元素数量超过 512 或者出现非整数元素时,就会转换为 hashtable。
当底层是哈希表时,扩容机制和 Redis 的 dict 一样,采用渐进式 rehash。Redis 会同时维护旧表和新表,在后续的读写操作过程中逐步迁移数据,从而避免一次性扩容带来的阻塞问题。
你可以基于 Set 轻易实现交集、并集、差集的操作,比如你可以将一个用户所有的关注人存在一个集合中,将其所有粉丝存在一个集合。这样的话,Set 可以非常方便的实现如共同关注、共同粉丝、共同喜好等功能。这个过程也就是求交集的过程。
| 命令 | 介绍 |
|---|---|
| SADD key member1 member2 … | 向指定集合添加一个或多个元素 |
| SMEMBERS key | 获取指定集合中的所有元素 |
| SCARD key | 获取指定集合的元素数量 |
| SISMEMBER key member | 判断指定元素是否在指定集合中 |
| SINTER key1 key2 … | 获取给定所有集合的交集 |
| SINTERSTORE destination key1 key2 … | 将给定所有集合的交集存储在 destination 中 |
| SUNION key1 key2 … | 获取给定所有集合的并集 |
| SUNIONSTORE destination key1 key2 … | 将给定所有集合的并集存储在 destination 中 |
| SDIFF key1 key2 … | 获取给定所有集合的差集 |
| SDIFFSTORE destination key1 key2 … | 将给定所有集合的差集存储在 destination 中 |
| SPOP key count | 随机移除并获取指定集合中一个或多个元素 |
| SRANDMEMBER key count | 随机获取指定集合中指定数量的元素 |
应用场景
需要存放的数据不能重复的场景
- 举例:网站 UV 统计(数据量巨大的场景还是
HyperLogLog更适合一些)、文章点赞、动态点赞等场景。 - 相关命令:
SCARD(获取集合数量) 。
需要获取多个数据源交集、并集和差集的场景
举例:共同好友(交集)、共同粉丝(交集)、共同关注(交集)、好友推荐(差集)、音乐推荐(差集)、订阅号推荐(差集+交集) 等场景。
相关命令:SINTER(交集)、SINTERSTORE (交集)、SUNION (并集)、SUNIONSTORE(并集)、SDIFF(差集)、SDIFFSTORE (差集)。
需要随机获取数据源中的元素的场景
- 举例:抽奖系统、随机点名等场景。
- 相关命令:
SPOP(随机获取集合中的元素并移除,适合不允许重复中奖的场景)、SRANDMEMBER(随机获取集合中的元素,适合允许重复中奖的场景)。
4.Sorted Set 集合(有序集合Zset)
Sorted Set 类似于 Set,但和 Set 相比,Sorted Set 增加了一个权重参数 score,使得集合中的元素能够按 score 进行有序排列,还可以通过 score 的范围来获取元素的列表。有点像是 Java 中 HashMap 和 TreeSet 的结合体。
| 命令 | 介绍 |
|---|---|
| ZADD Key score1 member1 score2 member2 | 向指定有序集合添加一个或多个元素 |
| ZCARD KEY | 获取指定有序集合的元素数量 |
| ZINTERSTORE destination numkeys key1 key2 …将给定所有有序集合的交集存储在 destination 中,对相同元素对应的 score 值进行 SUM 聚合操作,numkeys 为集合数量 | 将给定所有有序集合的交集存储在 destination 中,对相同元素对应的 score 值进行 SUM 聚合操作,numkeys 为集合数量 |
| ZUNIONSTORE destination numkeys key1 key2 … | 求并集,其它和 ZINTERSTORE 类似 |
| ZUNIONSTORE destination numkeys key1 key2 … | 求并集,其它和 ZINTERSTORE 类似 |
| ZDIFFSTORE destination numkeys key1 key2 … | 求差集,其它和 ZINTERSTORE 类似 |
| ZRANGE key start end | 获取指定有序集合 start 和 end 之间的元素(score 从低到高) |
| ZREVRANGE key start end | 获取指定有序集合 start 和 end 之间的元素(score 从高到底) |
| ZREVRANK key member | 获取指定有序集合中指定元素的排名(score 从大到小排序) |
应用场景
需要随机获取数据源中的元素根据某个权重进行排序的场景
- 举例:各种排行榜比如直播间送礼物的排行榜、朋友圈的微信步数排行榜、王者荣耀中的段位排行榜、话题热度排行榜等等。
- 相关命令:
ZRANGE(从小到大排序)、ZREVRANGE(从大到小排序)、ZREVRANK(指定元素排名)。
5.list集合
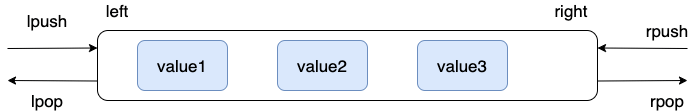
Redis 的 List 的实现为一个 双向链表,即可以支持反向查找和遍历,更方便操作,不过带来了部分额外的内存开销。
| 命令 | 介绍 |
|---|---|
| RPUSH key value1 value2 … | 在指定列表的尾部(右边)添加一个或多个元素 |
| LPUSH key value1 value2 … | 在指定列表的头部(左边)添加一个或多个元素 |
| LSET key index value | 将指定列表索引 index 位置的值设置为 value |
| LPOP key | 移除并获取指定列表的第一个元素(最左边) |
| RPOP key | 移除并获取指定列表的最后一个元素(最右边) |
| LLEN key | 获取列表元素数量 |
| LRANGE key start end | 获取列表 start 和 end 之间 的元素 |
应用场景
信息流展示
- 举例:最新文章、最新动态。
- 相关命令:
LPUSH、LRANGE。
消息队列
List 可以用来做消息队列,只是功能过于简单且存在很多缺陷,不建议这样做。
相对来说,Redis 5.0 新增加的一个数据结构 Stream 更适合做消息队列一些,只是功能依然非常简陋。和专业的消息队列相比,还是有很多欠缺的地方比如消息丢失和堆积问题不好解决。
6.BitMap(位图)
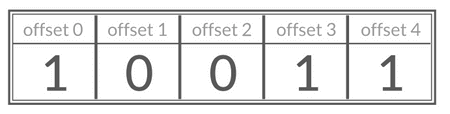
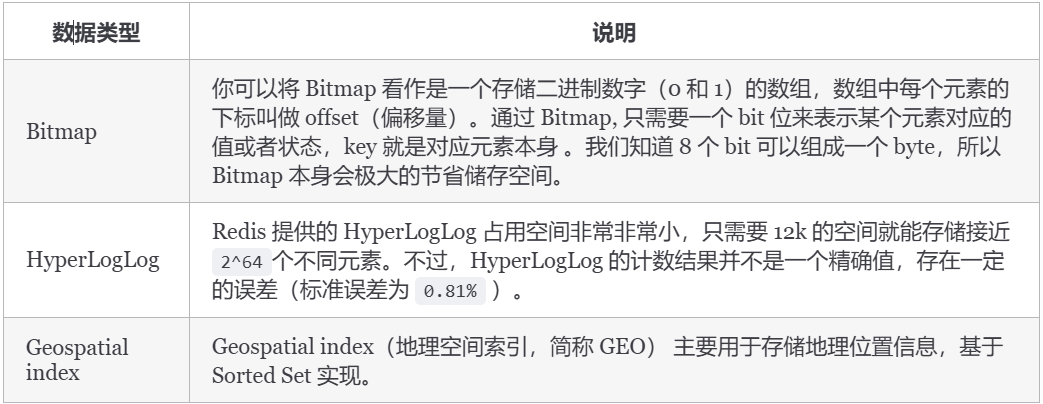
Bitmap 存储的是连续的二进制数字(0 和 1),通过 Bitmap, 只需要一个 bit 位来表示某个元素对应的值或者状态,key 就是对应元素本身 。我们知道 8 个 bit 可以组成一个 byte,所以 Bitmap 本身会极大的节省储存空间。
你可以将 Bitmap 看作是一个存储二进制数字1(0 和 1)的数组,数组中每个元素的下标叫做 offset(偏移量)。
| 命令 | 介绍 |
|---|---|
| SETBIT key offset value | 设置指定 offset 位置的值 |
| GETBIT key offset | 获取指定 offset 位置的值 |
| BITCOUNT key start end | 获取 start 和 end 之间值为 1 的元素个数 |
| BITOP operation destkey key1 key2 … | 对一个或多个 Bitmap 进行运算,可用运算符有 AND, OR, XOR 以及 NOT |
应用场景
需要保存状态信息(0/1 即可表示)的场景
用户签到情况
很多网站都提供了签到功能,并且需要展示最近一个月的签到情况,这种情况可以使用 BitMap 来实现。
根据日期 offset = (今天是一年中的第几天) % (今年的天数),key = 年份:用户id。如果需要将用户的详细签到信息入库的话,可以考虑使用一个异步线程来完成。
活跃用户情况(用户登录情况)
使用日期作为 key,然后用户 id 为 offset,如果当日活跃过就设置为1。具体怎么样才算活跃这个标准大家可以自己指定。
假如 20201009 活跃用户情况是: [1,0,1,1,0]
20201010 活跃用户情况是 :[ 1,1,0,1,0 ]
1 | |
统计20201009 ~ 20201010 活跃过的用户:
1 | |
实现布隆过滤器
7.HyperLogLog(基数统计)
- 一种基于概率的算法,用来估计集合中不重复元素(基数)的个数。
- 不是精确计数,而是用很少内存换取可接受的误差(误差率约 0.81%)。
HyperLogLog 是一种有名的基数计数概率算法 ,基于 LogLog Counting(LLC)优化改进得来,并不是 Redis 特有的,Redis 只是实现了这个算法并提供了一些开箱即用的 API。
Redis 提供的 HyperLogLog 占用空间非常非常小,只需要 12k 的空间就能存储接近2^64个不同元素。这是真的厉害,这就是数学的魅力么!并且,Redis 对 HyperLogLog 的存储结构做了优化,采用两种方式计数:
- 稀疏矩阵:计数较少的时候,占用空间很小。
- 稠密矩阵:计数达到某个阈值的时候,占用 12k 的空间。
基数计数概率算法为了节省内存并不会直接存储元数据,而是通过一定的概率统计方法预估基数值(集合中包含元素的个数)。因此, HyperLogLog 的计数结果并不是一个精确值,存在一定的误差(标准误差为 0.81% )。
| 命令 | 介绍 |
|---|---|
| PFADD key element1 element2 … | 添加一个或多个元素到 HyperLogLog 中 |
| PFCOUNT key1 key2 | 获取一个或者多个 HyperLogLog 的唯一计数。 |
| FMERGE destkey sourcekey1 sourcekey2 … | 将多个 HyperLogLog 合并到 destkey 中,destkey 会结合多个源,算出对应的唯一计数。 |
1 | |
应用场景
数量巨大(百万、千万级别以上)的计数场景
- 举例:热门网站每日/每周/每月访问 ip 数统计、热门帖子 uv 统计、
- 相关命令:
PFADD、PFCOUNT
8.Geospatial(地理位置)
Geospatial index(地理空间索引,简称 GEO) 主要用于存储地理位置信息,基于 Sorted Set 实现。
通过 GEO 我们可以轻松实现两个位置距离的计算、获取指定位置附近的元素等功能。
| 命令 | 介绍 |
|---|---|
| GEOADD key longitude1 latitude1 member1 … | 添加一个或多个元素对应的经纬度信息到 GEO 中 |
| GEOPOS key member1 member2 … | 返回给定元素的经纬度信息 |
| GEODIST key member1 member2 M/KM/FT/MI | 返回两个给定元素之间的距离 |
| GEORADIUS key longitude latitude radius distance获取指定位置附近 distance 范围内的其他元素,支持 ASC(由近到远)、DESC(由远到近)、Count(数量) 等参数 | 获取指定位置附近 distance 范围内的其他元素,支持 ASC(由近到远)、DESC(由远到近)、Count(数量) 等参数 |
| GEORADIUSBYMEMBER key member radius distance | 类似于 GEORADIUS 命令,只是参照的中心点是 GEO 中的元素 |
1 | |
获取指定位置范围内的其他元素:
1 | |
应用场景
需要管理使用地理空间数据的场景
- 举例:附近的人
- 相关命令:
GEOADD、GEORADIUS、GEORADIUSBYMEMBER
redis做排行榜用什么数据结构
Redis删除过期key有哪些策略?并详细说明?
1.定时删除
- 原理:在设置键的过期时间的同时,创建一个定时器(timer),让定时器在键的过期时间来临时,立即执行对键的删除操作
- 优点:能够很及时的删除过期的Key,能够最大限度的节约内存
- 缺点:对CPU时间不友好,如果过期的Key比较多时,可能会占用相当一部分CPU时间,对服务器的响应时间和吞吐量造成影响
2.惰性删除
- 原理:在取出键时才对键进行过期检查,如果发现过期了就会被删除
- 优点:对CPU友好,能够最大限度的节约CPU时间
- 缺点:对内存不友好,过期的Key会占用内存,造成浪费
3.定期删除
- 原理:定期删除策略是定时删除策略和惰性删除策略的一个折中。定期删除策略每隔一段时间执行一次删除过期键的操作,并通过限制删除操作执行的时长和频率来减少删除操作对CPU时间的影响
- 优点:对CPU时间和内存空间的一种权衡,可以根据实际使用情况来调整删除操作执行的时长和频率
- 缺点:确定删除操作执行的时长和频率很难。如果删除操作执行的太频繁,或者执行的时间太长,退化成定时删除策略;如果删除操作执行的太少,或者执行时间太短,退化成惰性删除策略
Redis服务器实际使用的是惰性删除和定期删除两种策略:通过配合使用这两种删除策略,服务器可以很好地在合理使用CPU时间和避免浪费内存空间之间取得平衡。Redis默认每隔100ms随机抽取一些设置了过期时间的key,检查是否过期,如果过期就删除。
这两种策略天然的互补,结合起来之后,定时删除策略就发生了一些改变,不在是每次扫描全部的 key 了,而是随机抽取一部分 key 进行检查,这样就降低了对 CPU 资源的损耗,惰性删除策略互补了为检查到的key,基本上满足了所有要求。
但是有时候就是那么的巧,既没有被定时器抽取到,又没有被使用触发惰性删除,是否会把内存撑爆?回答是不会,当内存不够用时,内存淘汰机制就会上场。
4内存淘汰机制
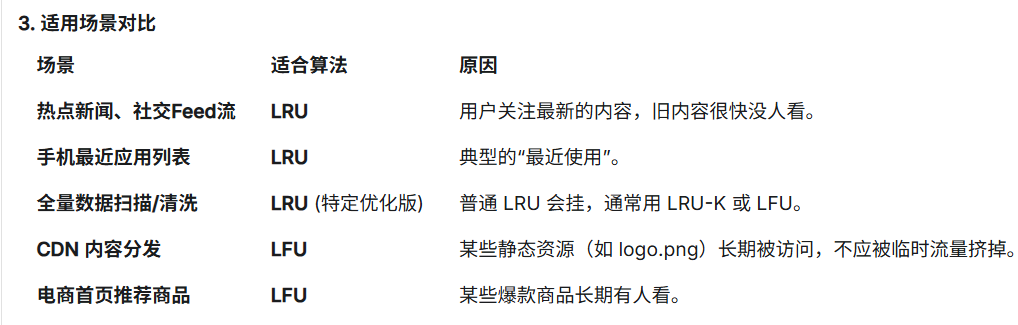
如果Redis服务器打开了maxmemory选项,并且服务器占用的内存数超过了maxmemory选项所设置的上限值时,会进行内存淘汰,常见的淘汰策略如下:
- volatile-lru:从已设置过期时间的数据集中挑选最近最少使用的数据淘汰
- volatile-ttl:从已设置过期时间的数据集中挑选将要过期的数据淘汰
- volatile-random:从已设置过期时间的数据集中任意选择数据淘汰
- volatile-lfu:从已设置过期时间的数据集挑选使用频率最低的数据淘汰
- allkeys-lru:从数据集(server.db[i].dict)中挑选最近最少使用的数据淘汰
- allkeys-lfu:从数据集(server.db[i].dict)中挑选使用频率最低的数据淘汰
- allkeys-random:从数据集(server.db[i].dict)中任意选择数据淘汰
- no-enviction(驱逐):禁止驱逐数据,这也是默认策略。意思是当内存不足以容纳新入数据时,新写入操作就会报错,请求可以继续进行,线上任务也不能持续进行,采用no-enviction策略可以保证数据不被丢失。
Redis为什么快
1.Redis是基于内存操作,需要的时候需要我们手动持久化到硬盘中
Redis 是基于内存的数据库,不论读写操作都是在内存上完成的,完全吊打磁盘数据库的速度。Redis之所以可以使用单线程来处理,其中的一个原因是,内存操作对资源损耗较小,保证了处理的高效性。
2.Redis高效数据结构,对数据的操作也比较简单
在 Redis 中存储value,常用的 5 种数据类型和应用场景如下:
String: 缓存、计数器、分布式锁等。
List: 链表、队列、微博关注人时间轴列表等。
Hash: 用户信息、Hash 表等。
Set: 去重、赞、踩、共同好友等。
Zset: 访问量排行榜、点击量排行榜等。
3.Redis是单线程模型,从而避开了多线程中上下文频繁切换的操作
我们要明确的是:Redis 的单线程指的是 Redis 的网络 IO 以及键值对指令读写是由同一个线程来执行的。 对于 Redis 的持久化、集群数据同步、异步删除等都是其他线程执行。
所谓单线程是指对数据的所有操作都是由一个线程按顺序挨个执行的,使用单线程好处:
- 不会因为线程创建导致的性能消耗;
- 避免上多线程上下文切换引起的 CPU开销;
- 避免了线程之间的竞争问题,比如添加锁、释放锁、死锁等,不需要考虑各种锁的问题。
4.使用多路I/O复用模型,非阻塞I/O
5.使用底层模型不同,它们之间底层实现方式以及与客户端之间通信的应用协议不一样,Redis直接自己构建了VM 机制 ,因为一般的系统调用系统函数的话,会浪费一定的时间去移动和请求—-高效的的 Gossip 通信协议
Redis做分布式锁,什么情况下会死锁,分布式锁的局限性(缺点),在 redis 中使用分布式锁时,有哪些常见的实现方式和可能的陷阱?
死锁: 上锁和设置过期时间不是原子性
Redis的zset数据结构
跳表是一种基于多层有序链表的概率型数据结构,其中最底层为双向链表,其它为通过为节点随机生成层高,构建多级索引,从而将查找复杂度从 O(N) 优化到 O(logN)。查找时从高层向下逐步定位,插入和删除通过维护多层指针完成。相比红黑树,跳表实现更简单,并发友好,因此在 Redis 的 ZSet 中被广泛使用。
zset底层两种实现:1.ziplist(压缩列表)2.skiplist(跳表) + dict(哈希表)
如果
zset的元素个数 ≤ 128 且每个 member 和 score 的字节数 ≤ 64,就使用 ziplist;否则,自动升级为 跳表 + 哈希表。
为什么在数据量大的情况下切换数据结构:
- 压缩列表其实就是双向链表,因此在大数据量的情况下,增删改查的时间复杂度为O(n)
- 压缩列表可能产生连锁更新的问题
redis的zset是一个自动根据元素score排序的有序集合,和普通集合set非常相似,是一个没有重复元素的字符串集合。
zset的常用命令
1 | |
跳表
跳表(SkipList):增加了向前指针的链表叫作跳表。跳表全称叫做跳跃表,简称跳表。跳表是一个随机化的数据结构,实质就是一种可以进行二分查找的有序链表。跳表在原有的有序链表上面增加了多级索引,通过索引来实现快速查找。跳表不仅能提高搜索性能,同时也可以提高插入和删除操作的性能。
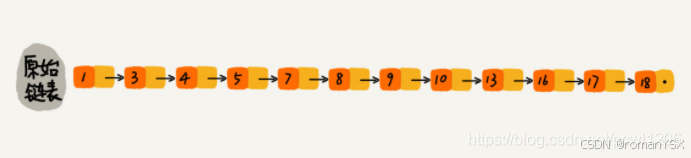
对于一个单链表来说,即使链表中的数据是有序的,如果我们想要查找某个数据,也必须从头到尾的遍历链表,很显然这种查找效率是十分低效的,时间复杂度为O(n)。
那么我们如何提高查找效率呢?我们可以对链表建立一级“索引”,每两个结点提取一个结点到上一级,我们把抽取出来的那一级叫做索引或者索引层,如下图所示,down表示down指针。
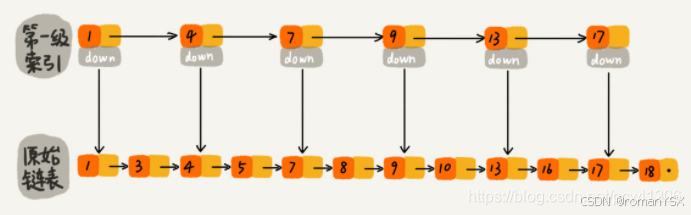
假设我们现在要查找值为16的这个结点。我们可以先在索引层遍历,当遍历索引层中值为13的时候,通过值为13的结点的指针域发现下一个结点值为17,因为链表本身有序,所以值为16的结点肯定在13和17这两个结点之间。然后我们通过索引层结点的down指针,下降到原始链表这一层,继续往后遍历查找。这个时候我们只需要遍历2个结点(值为13和16的结点),就可以找到值等于16的这个结点了。如果使用原来的链表方式进行查找值为16的结点,则需要遍历10个结点才能找到,而现在只需要遍历7个结点即可,从而提高了查找效率。
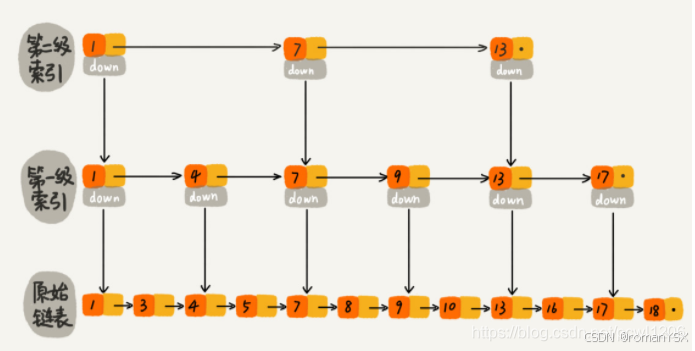
那么我们可以由此得到启发,和上面建立第一级索引的方式相似,在第一级索引的基础上,每两个一级索引结点就抽到一个结点到第二级索引中。再来查找值为16的结点,只需要遍历6个结点即可,从而进一步提高了查找效率。
【单链表+二级索引】
上面举得例子中的数据量不大,所以即便加了两级索引,查找的效率提升的也不是很明显,下面通过一个64结点的链表来更加直观的感受下索引提升查找效率,如图所示,建立了五级索引。
【单链表+五级索引】
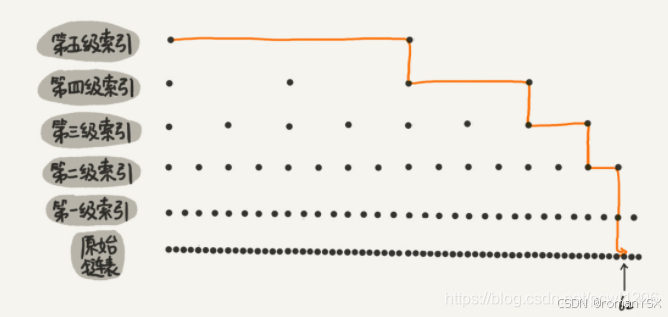
1.1跳表高效的动态插入和删除
跳表这个动态数据结构,不仅支持查找操作,还支持动态的插入、删除操作,而且插入、删除操作的时间复杂度也是 ○(㏒n)。
对于单纯的单链表,需要遍历每个结点来找到插入的位置。但是对于跳表来说,因为其查找某个结点的时间复杂度是 ○(㏒n),所以这里查找某个数据应该插入的位置,时间复杂度也是 ○(㏒n)。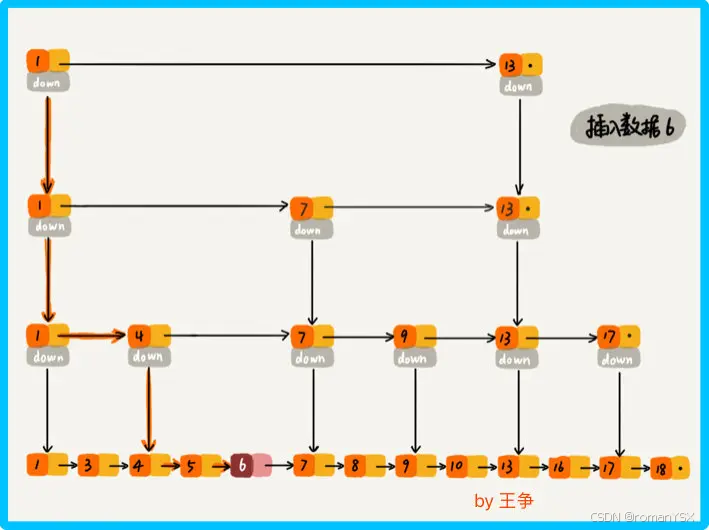
1.2跳表索引动态更新
当我们不停的往跳表中插入数据时,如果我们不更新索引,就可能出现某 2 个索引结点之间数据非常多的情况。极端情况下,跳表会退化成单链表。
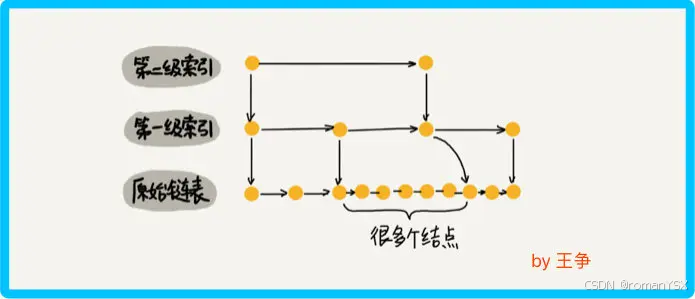
作为一种动态数据结构,我们需要某种手段来维护索引与原始链表大小之间的平滑,也就是说如果链表中结点多了,索引结点就相应地增加一些,避免复杂度退化,以及查找、插入、删除操作性能下降。
跳表是通过随机函数来维护前面提到的 平衡性。
我们往跳表中插入数据的时候,可以选择同时将这个数据插入到第几级索引中,比如随机函数生成了值 K,那我们就将这个结点添加到第一级到第 K 级这 K 级索引中。
那么这个随机函数是如何生成的呢?下面看一下源码:
1 | |
redis通过zslRandomLevel函数随机生成一个1~32的值,作为新建节点的高度,值越大出现的概率越低,节点高度确定后不会再修改,从上述生成节点高度代码可以看出,level的初始值为1,通过while循环,每次生成一个随机值,取这个值的低16位作为x,当x小于0.25倍的0xFFFF时,level值加1;否则return退出循环,最终返回level和ZSKIPLIST_MAXLEVEL这两者中的最小值。
直观上期望的目标是 50% 的概率被分配到Level 1,25% 的概率被分配到Level 2,12.5% 的概率被分配到Level 3,以此类推…有 2^63 的概率被分配到最顶层,因为这里每一层的晋升率都是 50%。
Redis 跳跃表默认允许最大的层数是 32,被源码中 ZSKIPLIST_MAXLEVEL 定义,当 Level[0] 有 2^64 个元素时,才能达到 32 层,所以定义 32 完全够用了。
1.3 zset中的跳表
skiplist作为zset的存储结构,整体存储结构如下图,核心点主要是包括一个dict对象和一个skiplist对象。dict保存key/value,key为元素,value为分值;skiplist保存的有序的元素列表,每个元素包括元素和分值。两种数据结构下的元素指向相同的位置。
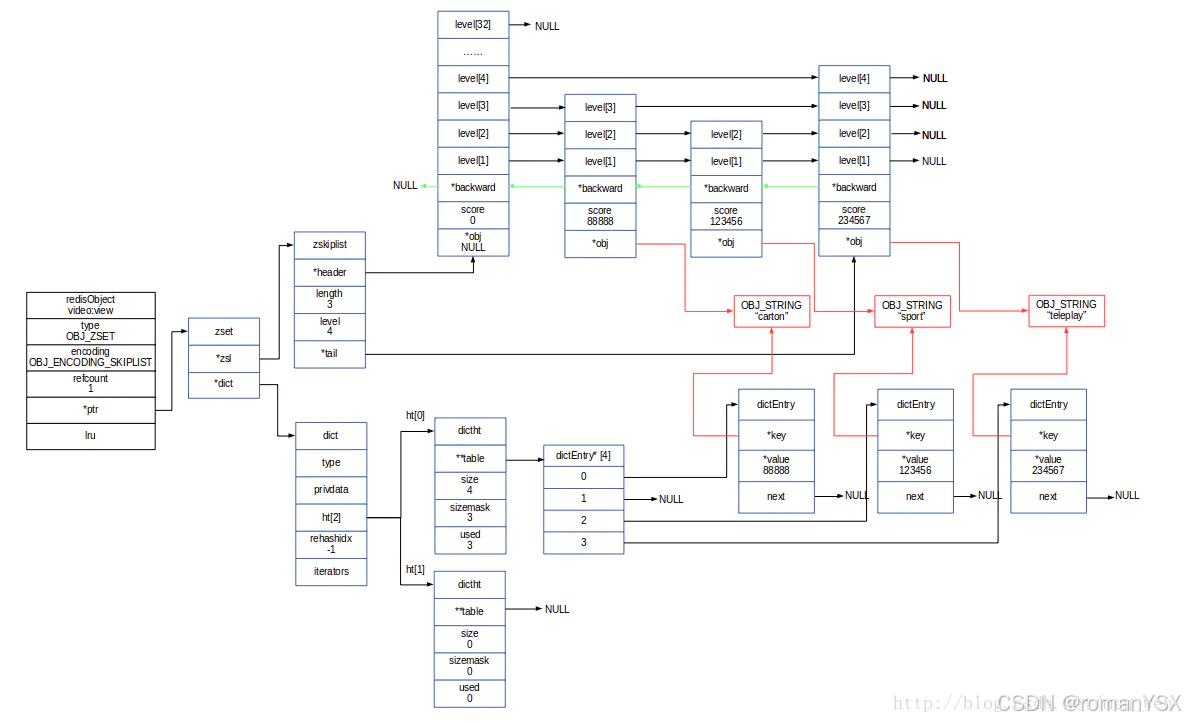 上图中 zskiplist 结构包含以下属性:
header:指向跳跃表的表头节点
tail:指向跳跃表的表尾节点
level:记录目前跳跃表内,层数最大的那个节点层数(表头节点的层数不计算在内)
length:记录跳跃表的长度,也就是跳跃表目前包含节点的数量(表头节点不计算在内)
位于 zskiplist 结构右侧是四个 zskiplistNode 结构,该结构包含以下属性:
层(level):节点中用 L1、L2、L3 等字样标记节点的各个层,L1 代表第一层,L2 代表第二层,以此类推。每个层都带有两个属性:前进指针和跨度。前进指针用于访问位于表尾方向的其它节点,而跨度则记录了前进指针所指向节点和当前节点的距离。
后退(backward)指针:节点中用 BW 字样标识节点的后退指针,它指向位于当前节点的前一个节点。后退指针在程序从表尾向表头遍历时使用。
分值(score):各个节点中的 1.0、2.0 和 3.0 是节点所保存的分值。在跳跃表中,节点按各自所保存的分值从小到大排列。
成员对象(obj):各个节点中的 o1、o2 和 o3 是节点所保存的成员对象。
Redis 的有序集合底层为什么要用跳表,而不用平衡树、红黑树或者 B+树?”
1.平衡树vs跳表
先来说说它和平衡树的比较,平衡树我们又会称之为 AVL 树,是一个严格的平衡二叉树,平衡条件必须满足(所有节点的左右子树高度差不超过 1,即平衡因子为范围为 [-1,1])。平衡树的插入、删除和查询的时间复杂度和跳表一样都是 O(log n) 。
对于范围查询来说,它也可以通过中序遍历的方式达到和跳表一样的效果。但是它的每一次插入或者删除操作都需要保证整颗树左右节点的绝对平衡,只要不平衡就要通过旋转操作来保持平衡,这个过程是比较耗时的。
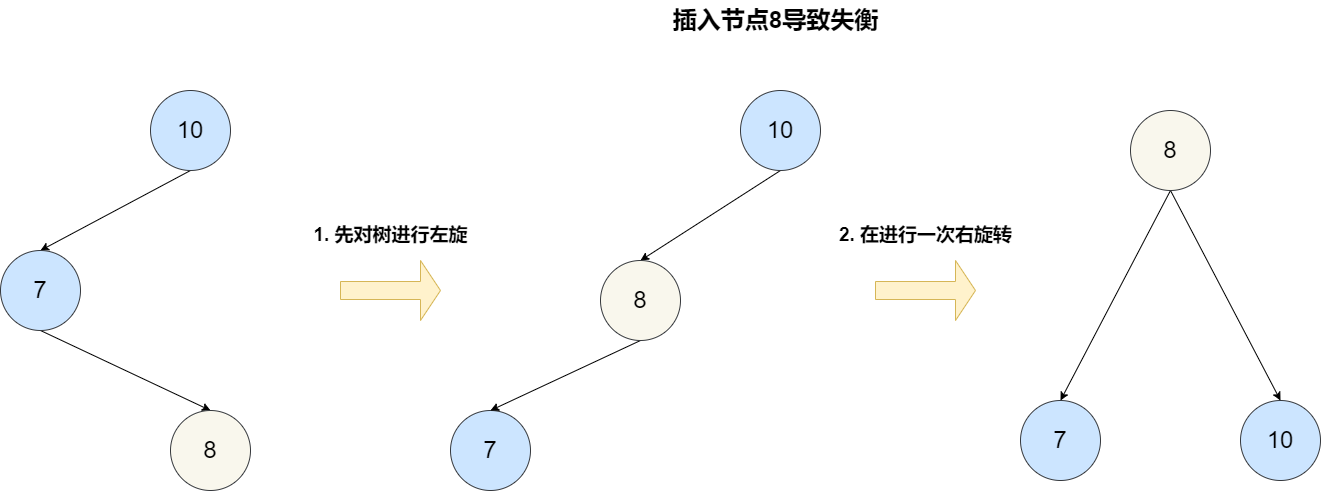
跳表是一种可以用来代替平衡树的数据结构。跳表使用概率平衡而不是严格强制的平衡,因此,跳表中的插入和删除算法比平衡树的等效算法简单得多,速度也快得多。
2.红黑树和跳表
红黑树(Red Black Tree)也是一种自平衡二叉查找树,它的查询性能略微逊色于 AVL 树,但插入和删除效率更高。红黑树的插入、删除和查询的时间复杂度和跳表一样都是 O(log n) 。
红黑树是一个黑平衡树,即从任意节点到另外一个叶子叶子节点,它所经过的黑节点是一样的。当对它进行插入操作时,需要通过旋转和染色(红黑变换)来保证黑平衡。不过,相较于 AVL 树为了维持平衡的开销要小一些。关于红黑树的详细介绍,可以查看这篇文章:红黑树。
相比较于红黑树来说,跳表的实现也更简单一些。并且,按照区间来查找数据这个操作,红黑树的效率没有跳表高。
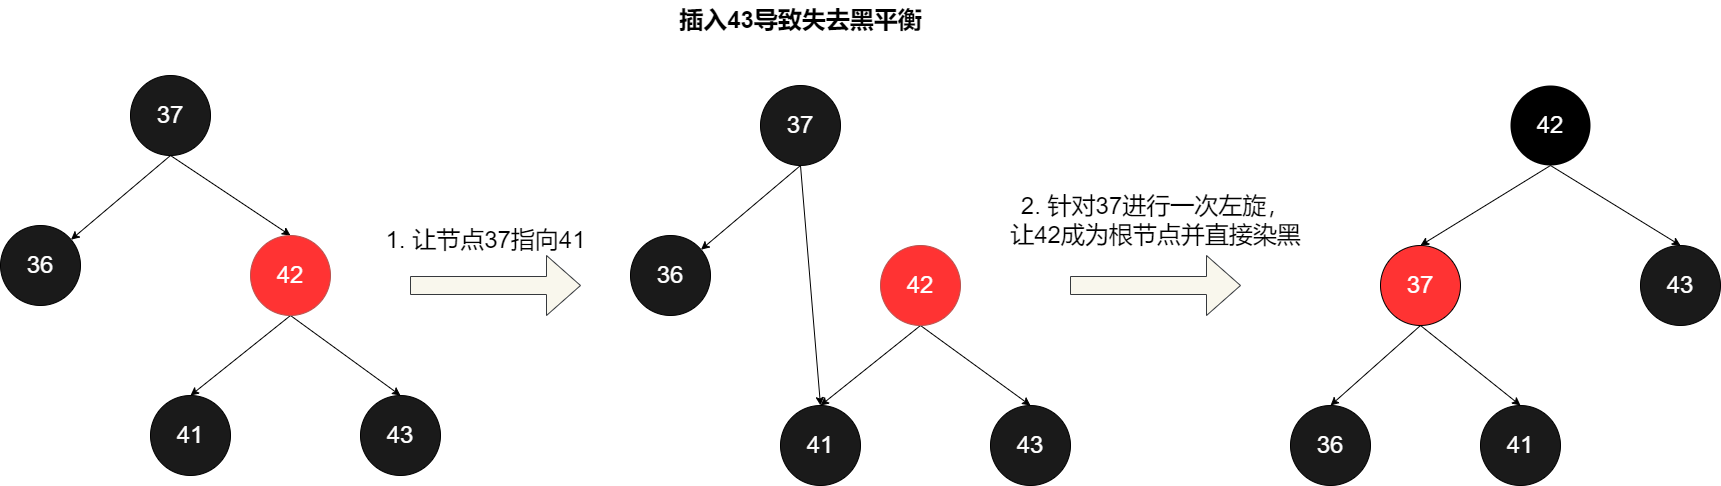
3.B+树vs跳表
想必使用 MySQL 的读者都知道 B+树这个数据结构,B+树是一种常用的数据结构,具有以下特点:
- 多叉树结构:它是一棵多叉树,每个节点可以包含多个子节点,减小了树的高度,查询效率高。
- 存储效率高:其中非叶子节点存储多个 key,叶子节点存储 value,使得每个节点更够存储更多的键,根据索引进行范围查询时查询效率更高。-
- 平衡性:它是绝对的平衡,即树的各个分支高度相差不大,确保查询和插入时间复杂度为 O(log n) 。
- 顺序访问:叶子节点间通过链表指针相连,范围查询表现出色。
- 数据均匀分布:B+树插入时可能会导致数据重新分布,使得数据在整棵树分布更加均匀,保证范围查询和删除效率。
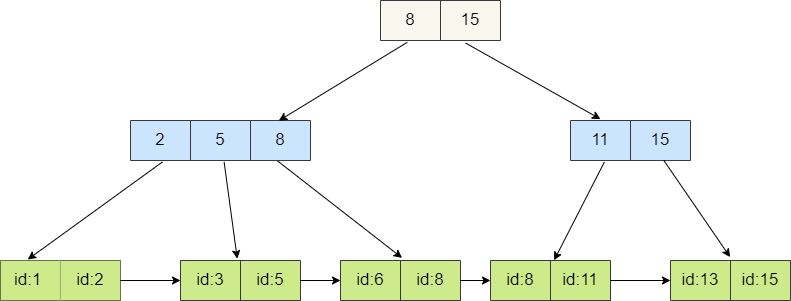
所以,B+树更适合作为数据库和文件系统中常用的索引结构之一,它的核心思想是通过可能少的 IO 定位到尽可能多的索引来获得查询数据。对于 Redis 这种内存数据库来说,它对这些并不感冒,因为 Redis 作为内存数据库它不可能存储大量的数据,所以对于索引不需要通过 B+树这种方式进行维护,只需按照概率进行随机维护即可,节约内存。而且使用跳表实现 zset 时相较前者来说更简单一些,在进行插入时只需通过索引将数据插入到链表中合适的位置再随机维护一定高度的索引即可,也不需要像 B+树那样插入时发现失衡时还需要对节点分裂与合并。
Redis作者给出的理由
有几个原因:
1、它们不是很占用内存。这主要取决于你。改变节点拥有给定层数的概率的参数,会使它们比 B 树更节省内存。
2、有序集合经常是许多 ZRANGE 或 ZREVRANGE 操作的目标,也就是说,以链表的方式遍历跳表。通过这种操作,跳表的缓存局部性至少和其他类型的平衡树一样好。
3、它们更容易实现、调试等等。例如,由于跳表的简单性,我收到了一个补丁(已经在 Redis 主分支中),用增强的跳表实现了 O(log(N))的 ZRANK。它只需要对代码做很少的修改。
Redis大Key问题(Redis性能瓶颈揭秘:如何优化大key问题?Redis大key问题指的是某个key对应的value值所占的内存空间比较 - 掘金)
简单来说,如果一个 key 对应的 value 所占用的内存比较大,那这个 key 就可以看作是 bigkey。
bigkey 通常是由于下面这些原因产生的:
- 程序设计不当,比如直接使用 String 类型存储较大的文件对应的二进制数据。
- 对于业务的数据规模考虑不周到,比如使用集合类型的时候没有考虑到数据量的快速增长。
- 未及时清理垃圾数据,比如哈希中冗余了大量的无用键值对。
大 key 还会造成阻塞问题。具体来说,主要体现在下面三个方面:
客户端超时阻塞:由于 Redis 执行命令是单线程处理,然后在操作大 key 时会比较耗时,那么就会阻塞 Redis,从客户端这一视角看,就是很久很久都没有响应。
网络阻塞:每次获取大 key 产生的网络流量较大,如果一个 key 的大小是 1 MB,每秒访问量为 1000,那么每秒会产生 1000MB 的流量,这对于普通千兆网卡的服务器来说是灾难性的。
工作线程阻塞:如果使用 del 删除大 key 时,会阻塞工作线程,这样就没办法处理后续的命令。
如何处理大Key呢
bigkey 的常见处理以及优化办法如下(这些方法可以配合起来使用):
- 分割 bigkey:将一个 bigkey 分割为多个小 key。例如,将一个含有上万字段数量的 Hash 按照一定策略(比如二次哈希)拆分为多个 Hash。
- 手动清理:Redis 4.0+ 可以使用
UNLINK命令来异步删除一个或多个指定的 key。Redis 4.0 以下可以考虑使用SCAN命令结合DEL命令来分批次删除。 - 采用合适的数据结构:例如,文件二进制数据不使用 String 保存、使用 HyperLogLog 统计页面 UV、Bitmap 保存状态信息(0/1)。
- 开启 lazy-free(惰性删除/延迟释放) :lazy-free 特性是 Redis 4.0 开始引入的,指的是让 Redis 采用异步方式延迟释放 key 使用的内存,将该操作交给单独的子线程处理,避免阻塞主线程。
Redis的热Key问题(Redis——热点key问题_redis热点key解决方案-CSDN博客)(Redis 热 key 的终极解决方案?京东、得物、b 站都是如何解决的?背景 Redis 热 key 问题是指单位时间 - 掘金)
hotkey 出现的原因主要是某个热点数据访问量暴增,如重大的热搜事件、参与秒杀的商品。
1.危害
处理 hotkey 会占用大量的 CPU 和带宽,可能会影响 Redis 实例对其他请求的正常处理。此外,如果突然访问 hotkey 的请求超出了 Redis 的处理能力,Redis 就会直接宕机。这种情况下,大量请求将落到后面的数据库上,可能会导致数据库崩溃。
2.如何发现hotKey?
2.1使用 Redis 自带的 --hotkeys 参数来查找。
2.2使用MONITOR 命令。
MONITOR 命令是 Redis 提供的一种实时查看 Redis 的所有操作的方式,可以用于临时监控 Redis 实例的操作情况,包括读写、删除等操作。
由于该命令对 Redis 性能的影响比较大,因此禁止长时间开启 MONITOR(生产环境中建议谨慎使用该命令)。
1 | |
3.如何解决
hotkey 的常见处理以及优化办法如下(这些方法可以配合起来使用):
- 读写分离:主节点处理写请求,从节点处理读请求。
- 使用 Redis Cluster:将热点数据分散存储在多个 Redis 节点上。
- 二级缓存:hotkey 采用二级缓存的方式进行处理,将 hotkey 存放一份到 JVM 本地内存中(可以用 Caffeine)。
热key与本地缓存怎么维持一致性
方案一:超时淘汰 (TTL) —— 最简单,弱一致性
- 原理:
- 给本地缓存设置一个非常短的过期时间(比如 1-3 秒)。
- 即使 Redis 数据变了,本地缓存最多也只脏 3 秒钟,然后会自动失效,下一次请求会重新从 Redis 加载。
- 适用场景:
- 对数据一致性要求不高的场景(比如新闻标题、商品详情页)。
- 能接受秒级延迟。
- 优点:实现极其简单(用 Guava Cache / Caffeine 即可),对系统无侵入。
- 缺点:一致性有延迟。
方案二:主动更新 (Write-Through / Update-then-Delete)
- 原理:
- 更新方(比如后台管理系统)在修改完数据库和 Redis 后,再主动通知所有应用节点去清理本地缓存。
- 通知方式:
- 消息队列 (MQ):这是最优的方式。
- 更新方发送一条消息到 MQ(如 RabbitMQ/RocketMQ)的发布/订阅 (Pub/Sub) 主题,消息内容是 key: “hot_key_name”。
- 所有应用节点都订阅这个主题。
- 收到消息后,各自去删除自己 JVM 内存里的 hot_key_name。
- 消息队列 (MQ):这是最优的方式。
- 适用场景:
- 对一致性要求较高的场景。
- 优点:一致性高,延迟低。
- 缺点:引入了 MQ,增加了系统复杂度。
方案三:订阅 Key 变更 (Redis Pub/Sub or Keyspace Notifications)
原理:
- 利用 Redis 自带的发布/订阅功能或键空间通知 (Keyspace Notifications)。
- 应用节点启动一个后台线程,SUBSCRIBE 一个特定的频道,或者监听 keyspace@0:hot_key_name 的 set / del 事件。
流程:
- 当有人修改了 hot_key_name。
- Redis 会自动发布一条消息。
- 所有订阅的节点收到消息,清理本地缓存。
优点:不需要引入外部 MQ。
缺点:
- 可靠性差:Redis 的 Pub/Sub 是“发后即忘”的,如果客户端网络抖动,消息就丢了,不会重试。
- 性能影响:Keyspace Notifications 会对 Redis 性能有一定影响。
- 结论:这种方案在生产环境中用得不多。
Redis集群,集群相对于单机来说,有什么不同点,如何固定某个key映射到固定槽?数据倾斜怎么处理(Redis集群原理详解-CSDN博客)(深入剖析Redis系列(二) - Redis哨兵模式与高可用集群Redis 的 主从复制 模式下,一旦 主节点 由于故障 - 掘金)(一文掌握Redis主从复制、哨兵、Cluster三种集群模式在开发测试环境中,我们一般搭建Redis的单实例来应对开发测 - 掘金)
但它存在两个致命的瓶颈:
- 存储容量的瓶颈:单台 Redis 机器的内存是有限的(通常建议单实例不要超过 10GB~20GB,否则持久化 RDB 时的 Fork 操作会严重阻塞主线程)。如果企业有 500GB 的缓存数据,单机根本装不下。
- 并发写性能的瓶颈:无论有多少个从节点,所有的写操作都只能由唯一的主节点承担。如果每秒有 20 万次的写请求,单台机器的 CPU 和网卡会被瞬间打满。
一、 数据分片:哈希槽 (Hash Slot) 机制 —— 【绝对核心】
Redis Cluster 并没有使用传统的“一致性哈希”,而是引入了哈希槽 (Hash Slot) 的概念。
- 槽位总数:Redis Cluster 将整个缓存空间硬性划分为 16384 个槽。
- 槽位分配:集群中的每个 Master 节点负责管理一部分槽位。
- 例如 3 个节点:Node A 负责 05460,Node B 负责 546110922,Node C 负责 10923~16383。
- 数据路由(Key 怎么找到 Node?):
- 当你要存取一个 Key 时,Redis 先对 Key 进行 CRC16 计算。
- 公式:==HASH_SLOT = CRC16(key) % 16384。==
- 算出槽位号后,客户端就知道该去找哪个节点要数据了。
面试官追问:为什么是 16384 个槽,而不是 65536 个?
- 答案:因为节点间心跳包(Gossip 协议)需要携带槽位信息。16384 个槽的位图(Bitmap)只占 2KB,如果用 65536 个槽,位图会占 8KB,这会导致心跳包体积过大,浪费网络带宽。并且,Redis 作者认为一个集群通常不会超过 1000 个节点,16384 个槽足够分配了。
二、 节点通信:Gossip 协议
集群中没有“中心节点”(比如 Zookeeper),所有节点地位平等。那它们怎么知道谁挂了、谁负责哪些槽呢?
- Gossip (流言/八卦) 协议:
- 集群中的节点会不断地相互发送 PING/PONG 消息,就像人们传播八卦一样。
- 消息里包含了:自己负责的槽位、自己认为哪些节点挂了等状态信息。
- 通过这种方式,一段时间后,所有的节点都会拥有一份完整的全局拓扑视图。
三、 高可用:故障转移 (Failover)
Redis Cluster 自带哨兵(Sentinel)的功能,不需要额外部署。
- 主观下线 (PFAIL):节点 A 发现节点 B 心跳超时了,A 就把 B 标记为主观下线。
- 客观下线 (FAIL):A 通过 Gossip 协议问别人,如果有超过半数的 Master 节点都说 B 挂了,B 就被正式标记为客观下线。
- 选举新主:
- B 的几个 Slave 开始竞选。
- 它们会向其他存活的 Master 拉票。
- 哪个 Slave 的数据复制偏移量(offset)最大(数据最新),拿到的票数就最多。
- 拿到超过半数 Master 选票的 Slave 晋升为新 Master,接管旧 Master 的槽位。
1.什么是集群模式
Redis集群的做法是 将数据划分为 16384(2的14次方)个哈希槽(slots),如果你有多个实例节点,那么每个实例节点将管理其中一部分的槽位,槽位的信息会存储在各自所归属的节点中。以下图为例,该集群有4个 Redis 节点,每个节点负责集群中的一部分数据,数据量可以不均匀。比如性能好的实例节点可以多分担一些压力。
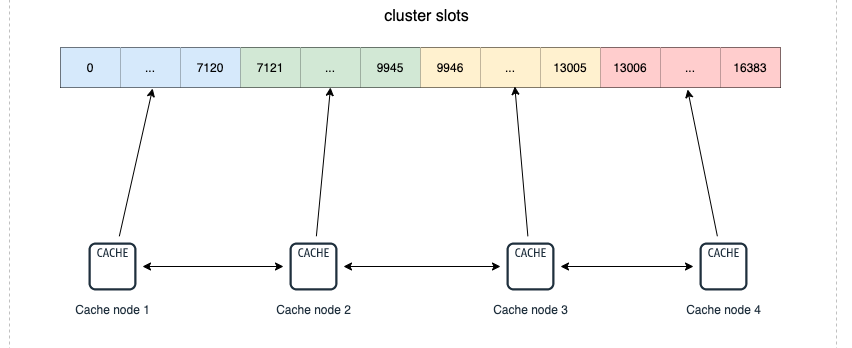
一个Redis集群一共有16384个哈希槽,你可以有1 ~ n个节点来分配这些哈希槽,可以不均匀分配,每个节点可以处理0个 到至多 16384 个槽点。
当16384个哈希槽都有节点进行管理的时候,集群处于online 状态。同样的,如果有一个哈希槽没有被管理到,那么集群处于offline状态。
上面图中4个实例节点组成了一个集群,集群之间的信息通过 Gossip协议 进行交互,这样就可以在某一节点记录其他节点的哈希槽(slots)的分配情况。
Gossip 是一种去中心化传播节点状态信息的协议,核心特征是:去中心化,没有“中心服务器”,随机选节点传播消息,像“流言(gossip)”一样扩散,最终一致性,不是瞬时一致,但最终所有节点信息一致
Redis Cluster 是**无中心节点(P2P 架构)**的。
- 网状连接:集群中的每个节点都与其他所有节点保持一条 TCP 长连接。
- Gossip(八卦)协议:节点之间不断地互相发送心跳消息(PING / PONG)。
- 消息中包含:当前节点的状态、自己负责的哈希槽、自己知道的其他节点的状态。
- 通过这种“口口相传”的方式,整个集群的每一个节点最终都会拥有一份完整的全局路由表(知道哪个槽归哪个节点管,知道哪个节点挂了)。
4.数据复制过程和故障转移
如果只有数据分片,节点 A 挂了,那么 0~5460 的槽位就全军覆没。为了保证高可用,每个 Master 至少需要配备一个 Slave(从节点)。
最经典的配置是 “三主三从”(6台服务器)。
故障转移的过程(与你了解的 Raft 选举思想非常类似):
- 主观下线(PFAIL):节点 A 发 PING 给节点 B,超时未收到回复,A 会在本地标记 B 为“可能下线”。
- 客观下线(FAIL):节点 A 把这个消息通过 Gossip 告诉大家。如果集群中超过半数的主节点都认为 B 没响应,B 就会被正式标记为“已下线”。
- 从节点选举:节点 B 挂了,它的从节点 B1、B2 发现老大死了,就会发起选举。它们向集群中剩下的主节点拉票。
- 晋升主节点:拥有最新数据(复制偏移量最大)的从节点(假设是 B1)会获得多数派选票,成功晋升为新的 Master,接管 5461 ~ 10922 槽位,集群恢复正常。
5.client 访问 数据集群的过程
既然没有中心代理节点,客户端怎么知道该连哪台机器?
- MOVED 重定向(标准路由)
- 客户端随便连了一台节点 A,发送 GET user:100。
- 节点 A 计算 user:100 的槽位是 8000,发现 8000 归节点 B 管。
- 节点 A 不会自己去 B 拿数据,而是向客户端返回一个错误:-MOVED 8000 <B的IP:端口>。
- 客户端收到后,自动重连到节点 B 获取数据。
- 智能客户端优化:像 JedisCluster 这样的成熟客户端,会在启动时拉取整个集群的槽位映射表缓存在本地内存。每次执行命令前,客户端自己在本地算好槽位,直接请求目标节点,极其高效,避免了 MOVED 重定向的开销。
- ASK 重定向(数据迁移时的特殊处理)
- 集群扩容时,我们可能正在把槽位 8000 从节点 A 迁移到节点 D。
- 此时槽位 8000 处于半迁移状态(部分数据在 A,部分在 D)。
- 客户端请求节点 A,如果数据还在 A,A 直接返回。如果数据已经被迁到了 D,A 会返回 -ASK 8000 <D的IP:端口>。
- 客户端收到 ASK 后,会先向 D 发送一个 ASKING 命令,然后再向 D 请求数据。
如何固定某个key映射到固定槽?
使用哈希标签(Hash Tags)
1 | |
数据倾斜
1.存储倾斜:指不同节点上存储的数据量很不均匀,如一台存的很多,一台存的很少。
2.访问倾斜:数据存储都差不多,但是访问很倾斜的打到一台节点上。
数据量倾斜
数据量倾斜产生的根本原因是:数据在各个redis实例上分布不均匀。
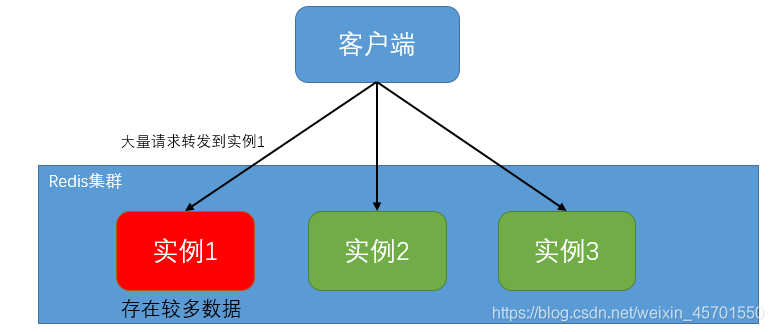
产生数据分布不均匀的情况主要有以下三种。
- 存在大bigkey:将一个bigKey拆分为多个小key
- hashTag使用不当:所有业务相关的的数据,都要放到同一个实例上,如果这个业务相关的数据量比较大的话,就会导致,业务所在实例的内存资源消耗严重。产生数据倾斜问题。
- slot分配不均
数据访问倾斜
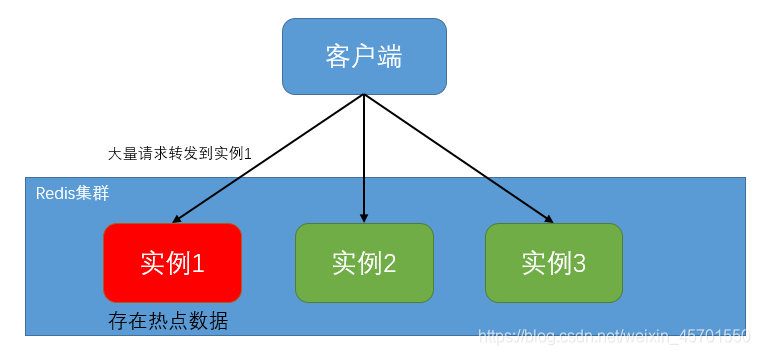
复制多份副本
我们可以在key的后面拼上有序编号,比如key#01、key#02。。。key#10多个副本,这些加工后的key位于多个缓存节点上。
客户端每次访问时,只需要在原key的基础上拼接一个分片数上限的随机数,将请求路由不到的实例节点。
注意:缓存一般都会设置过期时间,为了避免缓存的集中失效,我们对缓存的过期时间尽量不要一样,可以在预设的基础上增加一个随机数。
至于数据路由的均匀性,这个由 Hash 算法来保证。
Redis Cluster的slot迁移过程会阻塞请求吗?(ASK机制)
1. 迁移的基本流程(非阻塞设计)
Redis Cluster 的槽迁移是按 Key 迁移的,而不是一次性把整个 Slot 搬走。迁移一个 Slot 的过程大致如下:
- 标记状态:
- 源节点(Source)将 Slot 状态设为 MIGRATING。
- 目标节点(Destination)将 Slot 状态设为 IMPORTING。
- 此阶段不阻塞任何请求。
- 获取 Key 列表:源节点通过 CLUSTER GETKEYSINSLOT 命令获取该 Slot 下的一批 Key。
- 执行迁移(核心指令:MIGRATE):
源节点对每个 Key(或一批 Key)执行 MIGRATE 命令。这个命令包含三个步骤:DUMP(序列化)-> RESTORE(在目标端恢复)-> DEL(在源端删除)。
2. 对请求的具体影响(三种情况)
在迁移过程中,客户端访问属于该 Slot 的 Key 时,Redis 处理逻辑如下:
情况 A:Key 还在源节点,且尚未开始迁移该 Key
- 结果:源节点正常处理请求。
- 影响:完全无阻塞。
情况 B:Key 已经成功迁移到了目标节点
- 结果:源节点找不到该 Key,但发现 Slot 处于 MIGRATING 状态。
- 处理:源节点返回一个 -ASK 重定向错误(例如:-ASK 16384 192.168.1.2:6379)。
- 客户端操作:客户端先向目标节点发送 ASKING 命令,紧接着发送原本的请求命令。
- 影响:不阻塞,但会增加一次网络往返(RTT)的延迟。
情况 C:Key 正在执行 MIGRATE 命令(正在传输中)
- 结果:MIGRATE 是一个同步操作。在 Redis 序列化数据并将其发送到目标节点的过程中,Redis 的主线程是阻塞的。
- 影响:
- 如果 Key 很小(普通 String、小的 List),迁移速度极快(微秒级),用户无感知。
- 如果是大 Key(Big Key):比如一个包含百万元素的 Hash。由于 Redis 是单线程处理命令,MIGRATE 会导致主线程卡住,直到该大 Key 传输并删除完成。此时,该源节点上的所有其他请求都会被阻塞。
总结
Redis Cluster 的 slot 迁移设计是非阻塞的,前提是 Key 不大。
遇到 大 Key 时,会触发单节点阻塞,这是迁移的性能瓶颈。
面试回答可补充:
Redis Cluster 迁移通常不阻塞,但大 Key 会因为 MIGRATE 的同步序列化和发送而阻塞源节点的主线程。
保证Redis的高可用(深入剖析Redis系列(二) - Redis哨兵模式与高可用集群Redis 的 主从复制 模式下,一旦 主节点 由于故障 - 掘金)
“脑裂”(Split-Brain) 是分布式系统(如 Redis 哨兵、集群、Keepalived、ZooKeeper 等)中一个非常严重的问题。
简单来说,脑裂就是指:由于网络故障,一个集群裂变成了两个或多个子集群,每个子集群都认为对方已经挂了,从而各自选出了自己的“老大(Master/Leader)”。
结果就是,原本应该只有一个主节点的系统,出现了多个主节点。这就像一个人有两个大脑在同时指挥身体,必然会导致逻辑混乱。
1. 脑裂是怎么发生的?(以 Redis 哨兵为例)
假设你有一个主从架构:1 个 Master,2 个 Slaves,以及 3 个 Sentinel 哨兵。
- 网络分区:突然,Master 与哨兵、Slaves 之间的网络断了,但 Master 本身还在运行。
- 选举新主:哨兵们发现连不上 Master 了,于是认为 Master 死了。它们根据投票机制,从剩下的 Slaves 中选出了一个新的 Master。
- 两个老大出现:
- 老 Master 觉得自己还活着,继续接收一部分能连上它的客户端的“写请求”。
- 新 Master 也正式上岗,接收另一部分客户端的“写请求”。
- 混乱发生:此时系统里存在两个 Master,它们的数据开始不一致。
2. 脑裂的后果:数据丢失
这是脑裂最可怕的地方。
当网络恢复正常后:
- 哨兵会将老 Master 降级为 Slave,并命令它去连接新 Master 进行数据同步。
- 清空旧数据:作为 Slave,第一步就是清空自己的本地数据,去同步新 Master 的数据。
- 结果:在脑裂期间写入老 Master 的那部分数据,全部永久丢失了。
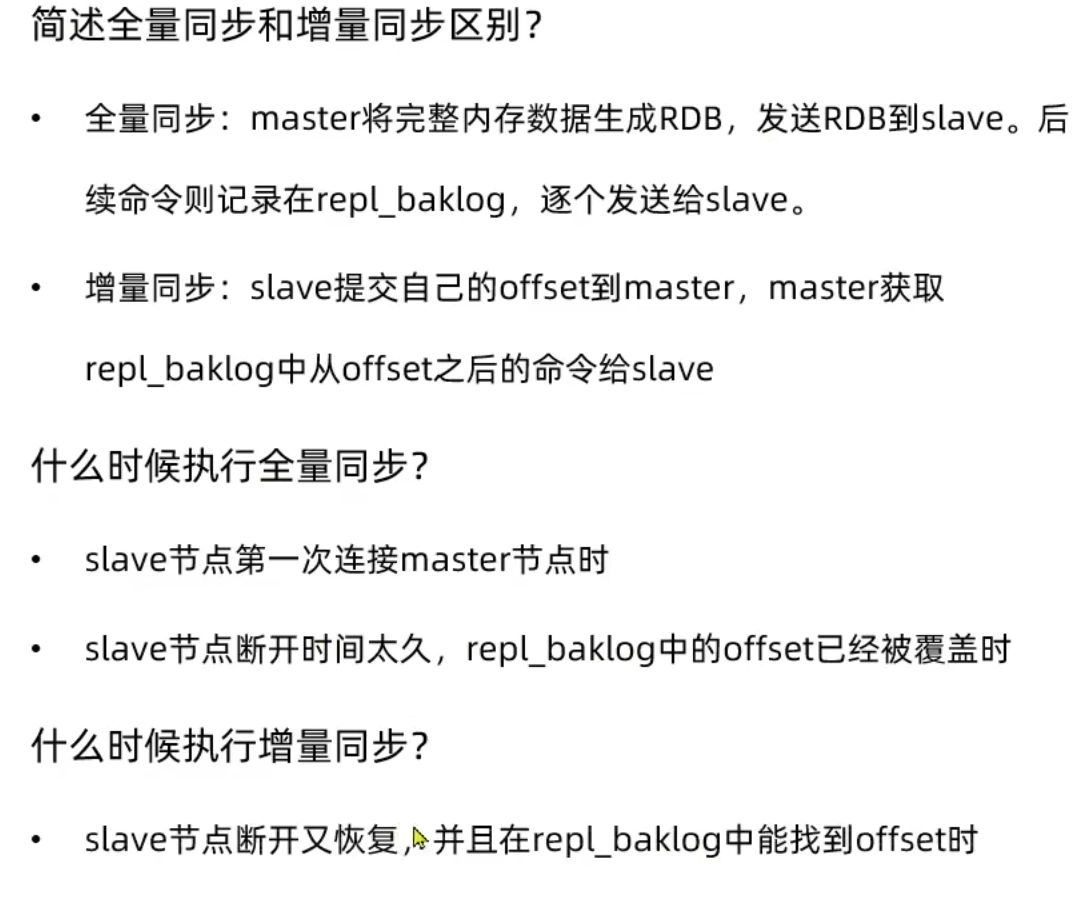
Redis主从复制
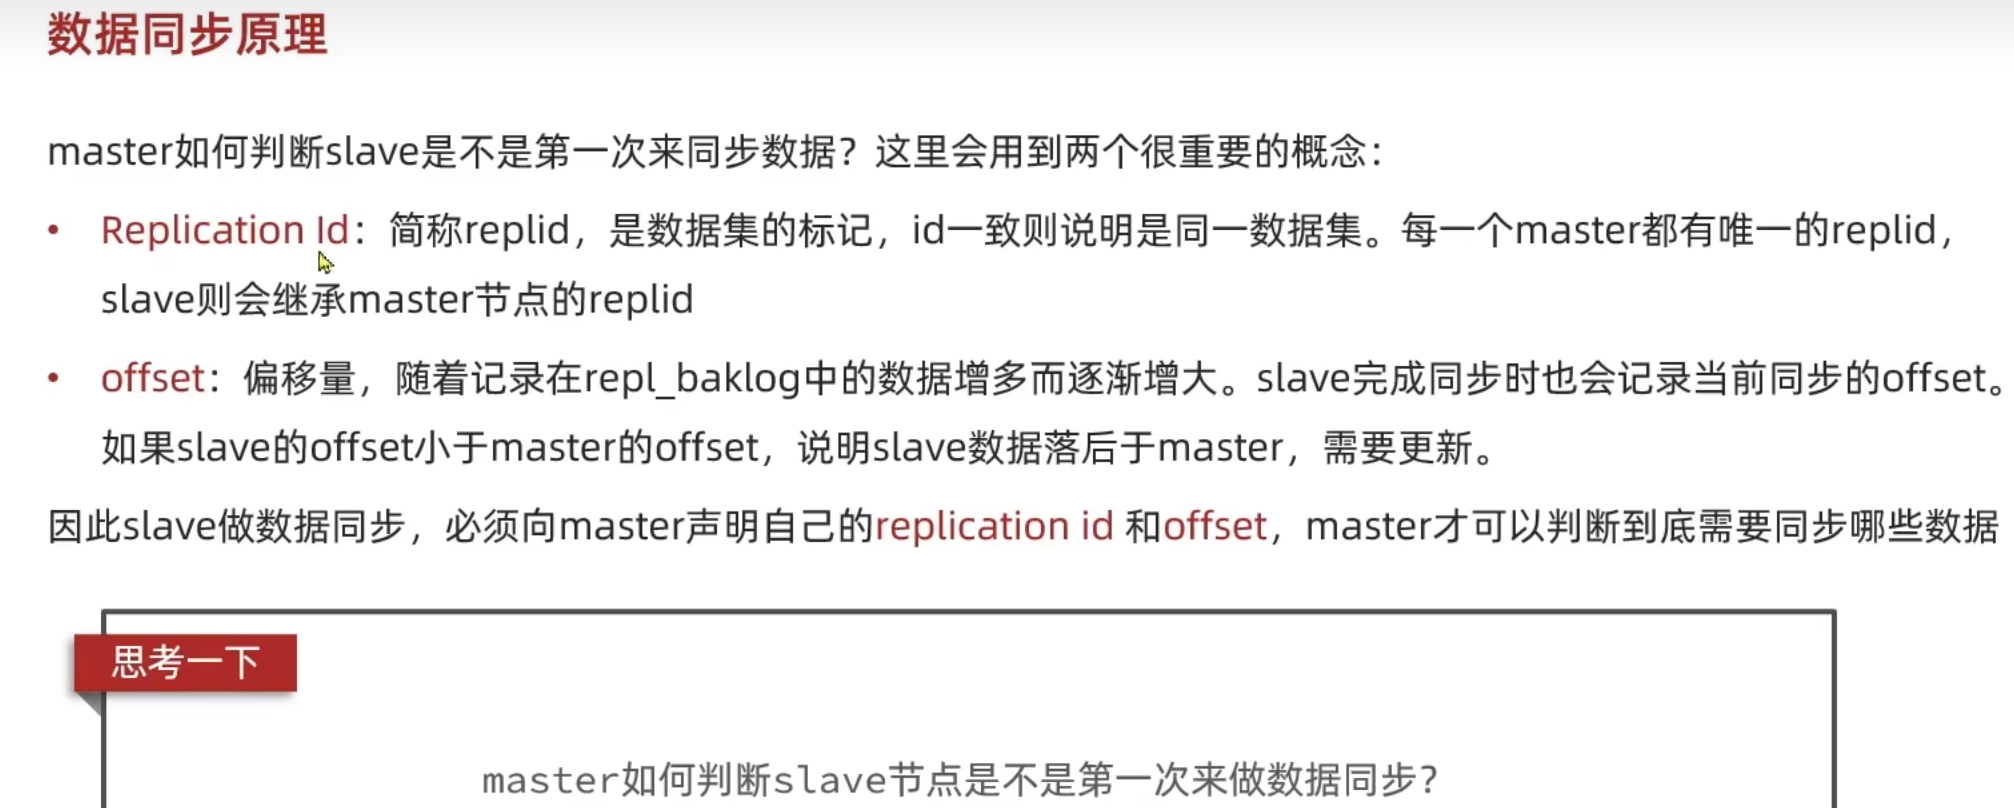
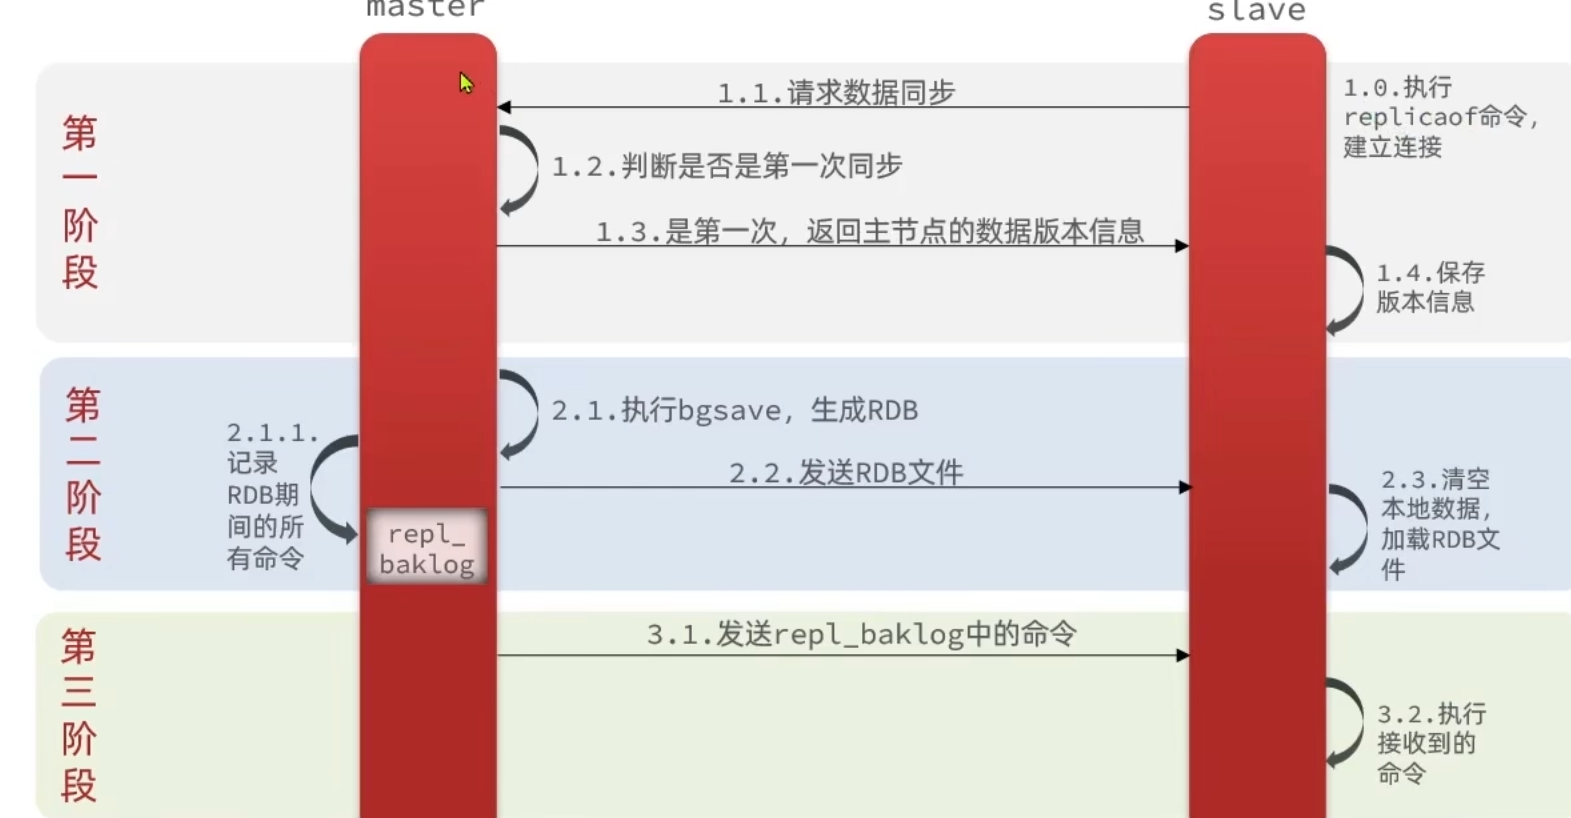
1.主从第一次同步是全量同步
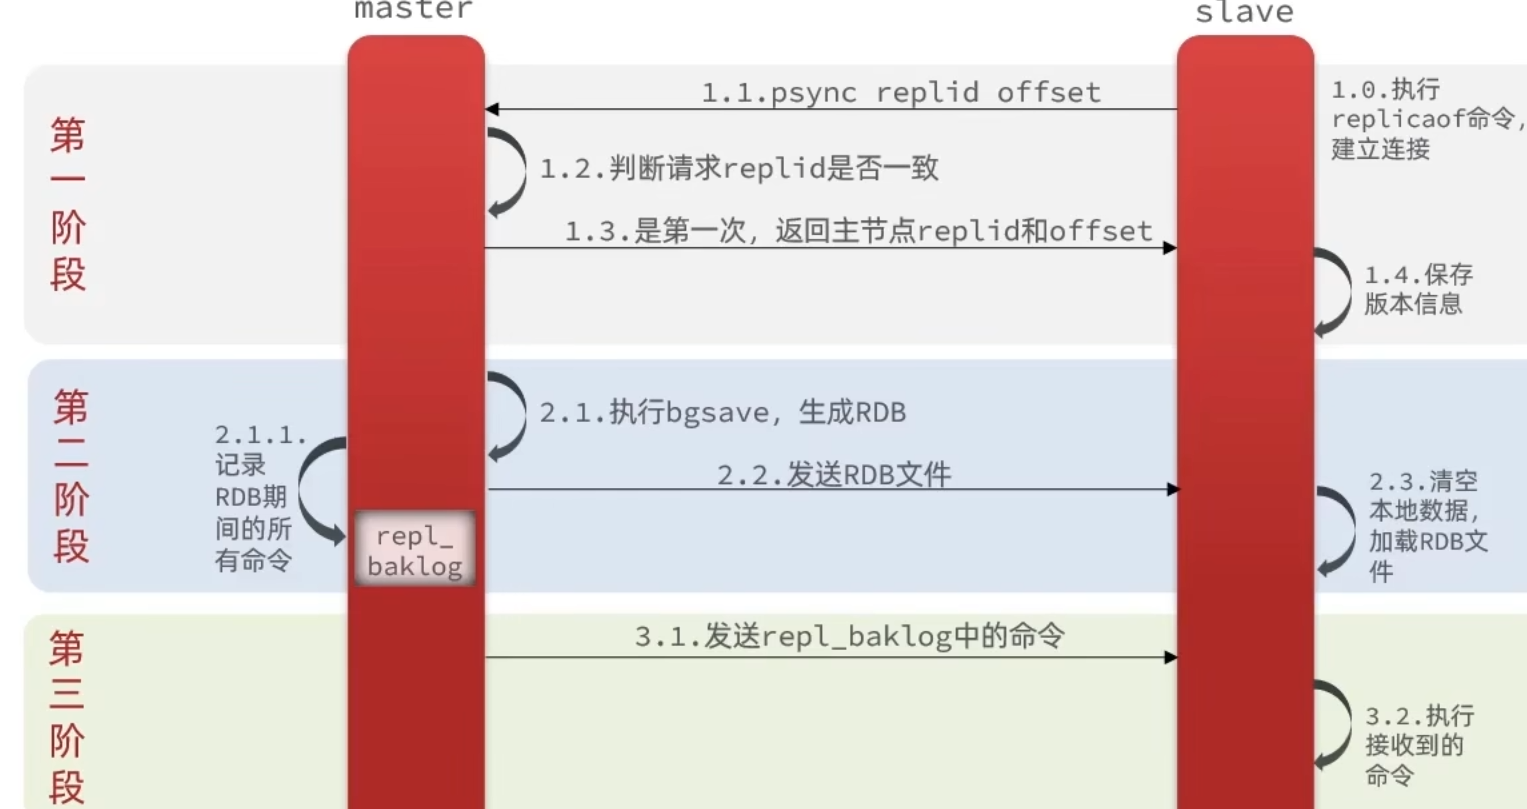
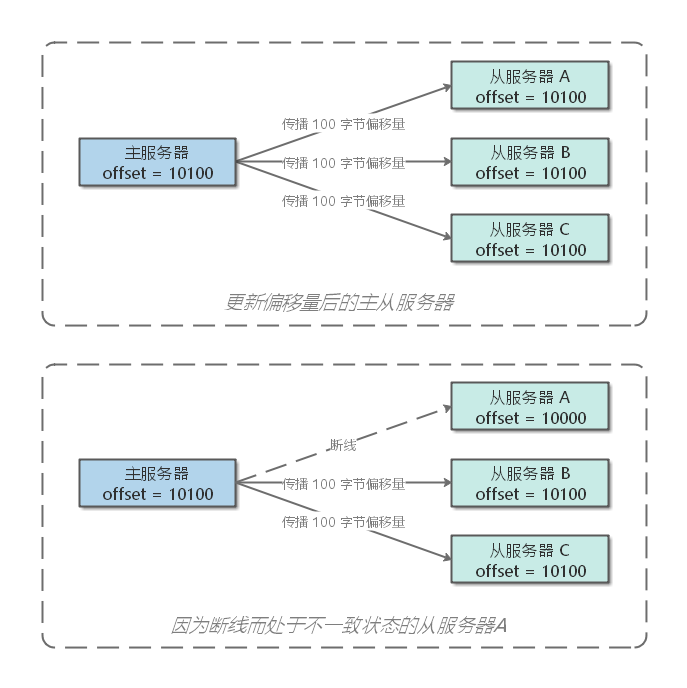
2.增量同步
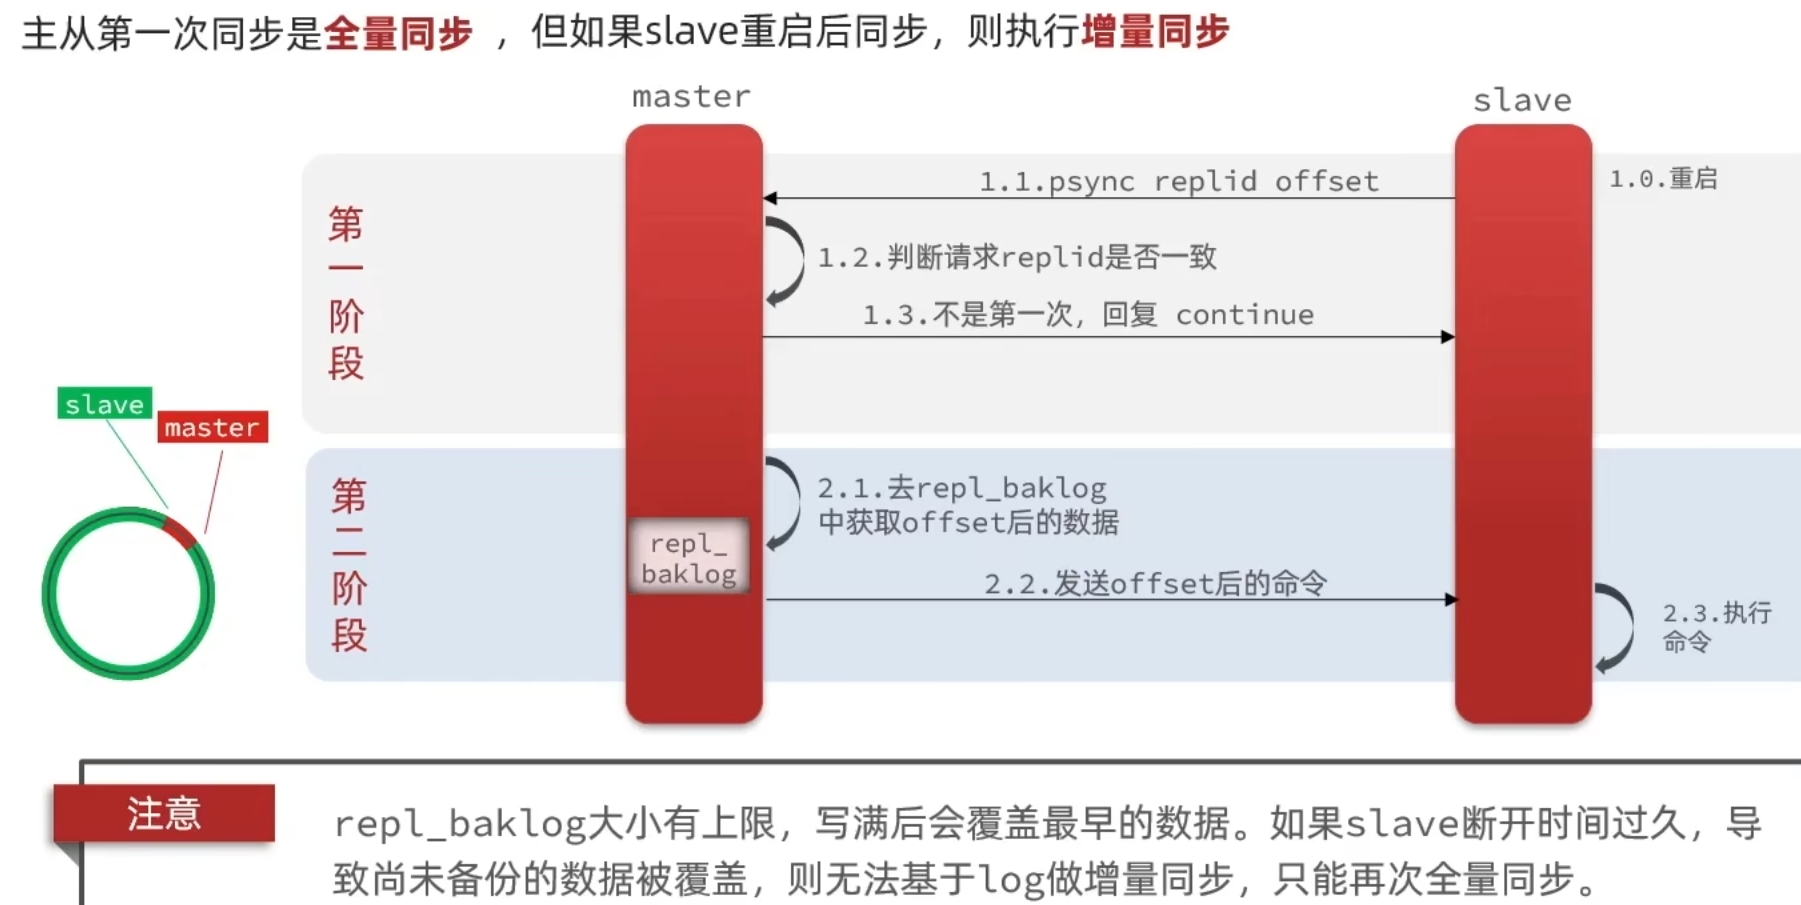
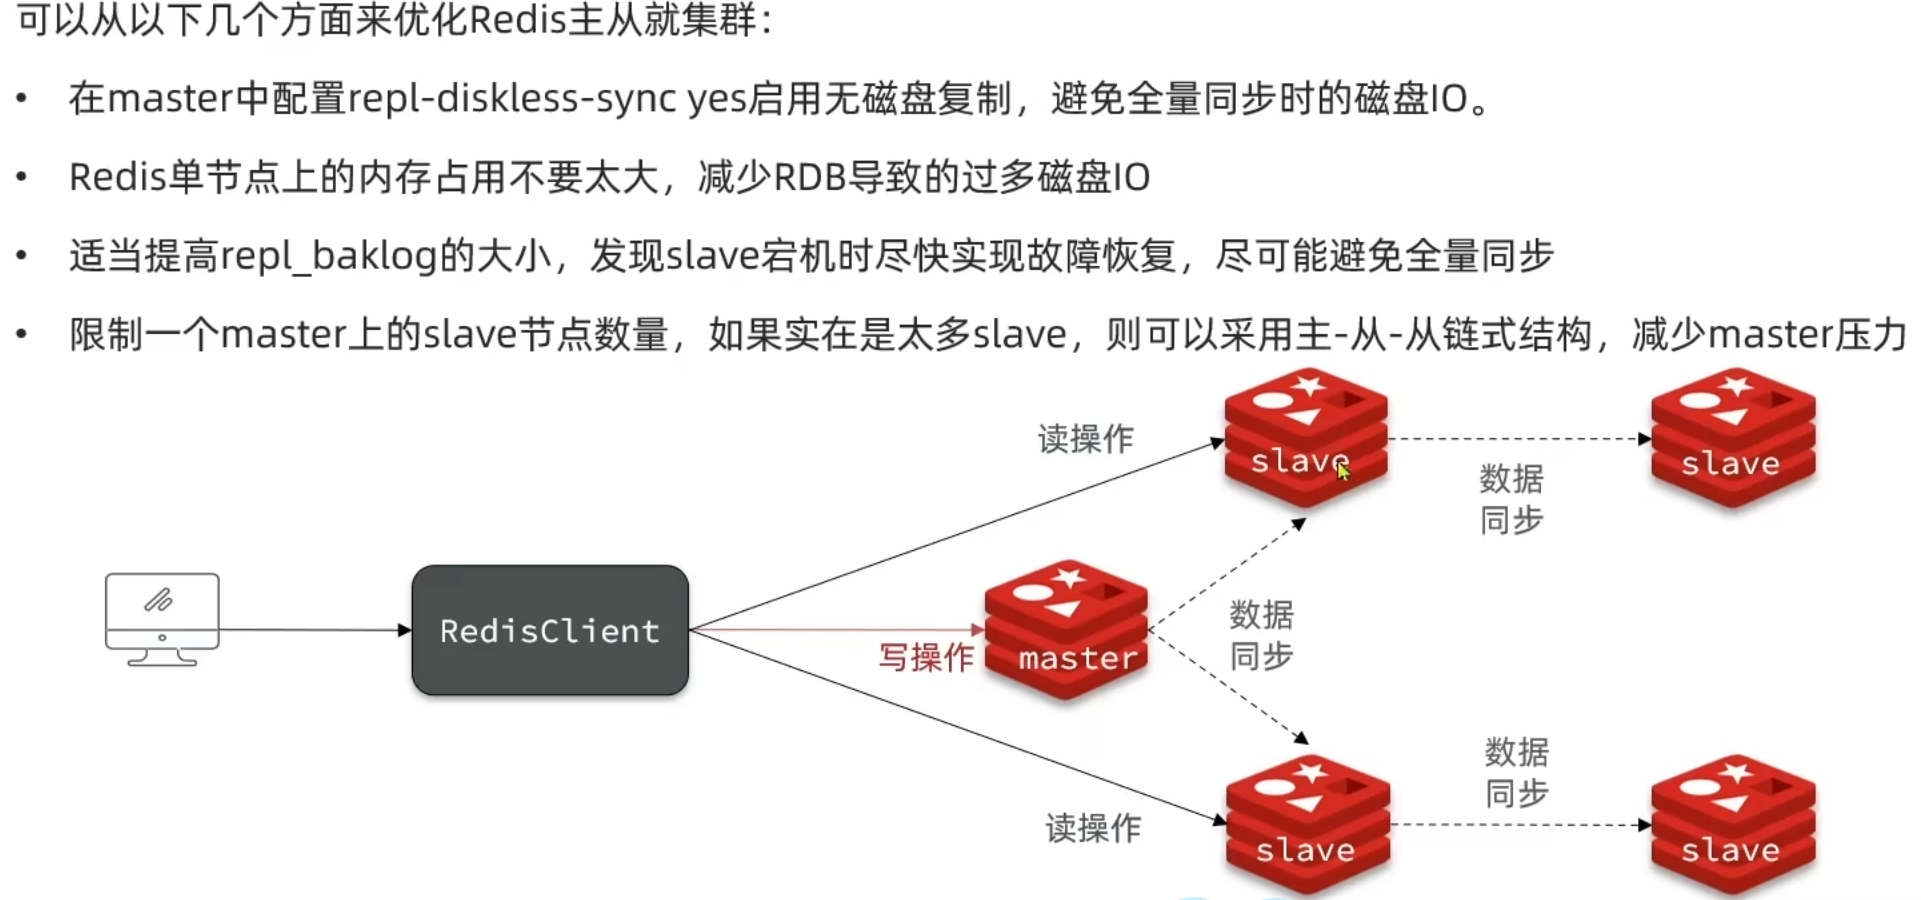
哨兵模式原理*
1.哨兵节点通过发送命令来监控Redis服务器的状态。它会定期向主节点和从节点发送PING命令,检查节点是否存活。
2.当主节点发生故障或不可用时,哨兵节点会进行故障检测。它会询问其他哨兵节点是否已经发现了主节点的故障,并尝试达成共识。
3.如果多数哨兵节点都认为主节点故障,那么它们会选举新的主节点。选举的原则是选择一个具有最高优先级的从节点,如果没有从节点则选择一个具有最高优先级的哨兵节点。
4.一旦新的主节点被选出,哨兵节点会更新所有其他从节点的配置信息,使它们成为新主节点的从节点。
5.当故障的主节点恢复时,哨兵节点会将其重新加入到主从复制环境中,并将其设置为新主节点的从节点。
6.通过哨兵模式,Redis可以实现高可用性和故障恢复。当主节点发生故障时,哨兵节点可以自动切换为新的主节点,使系统可以在故障期间继续提供服务。同时,哨兵节点可以监控并修复其他节点的故障,确保整个Redis集群处于可用状态。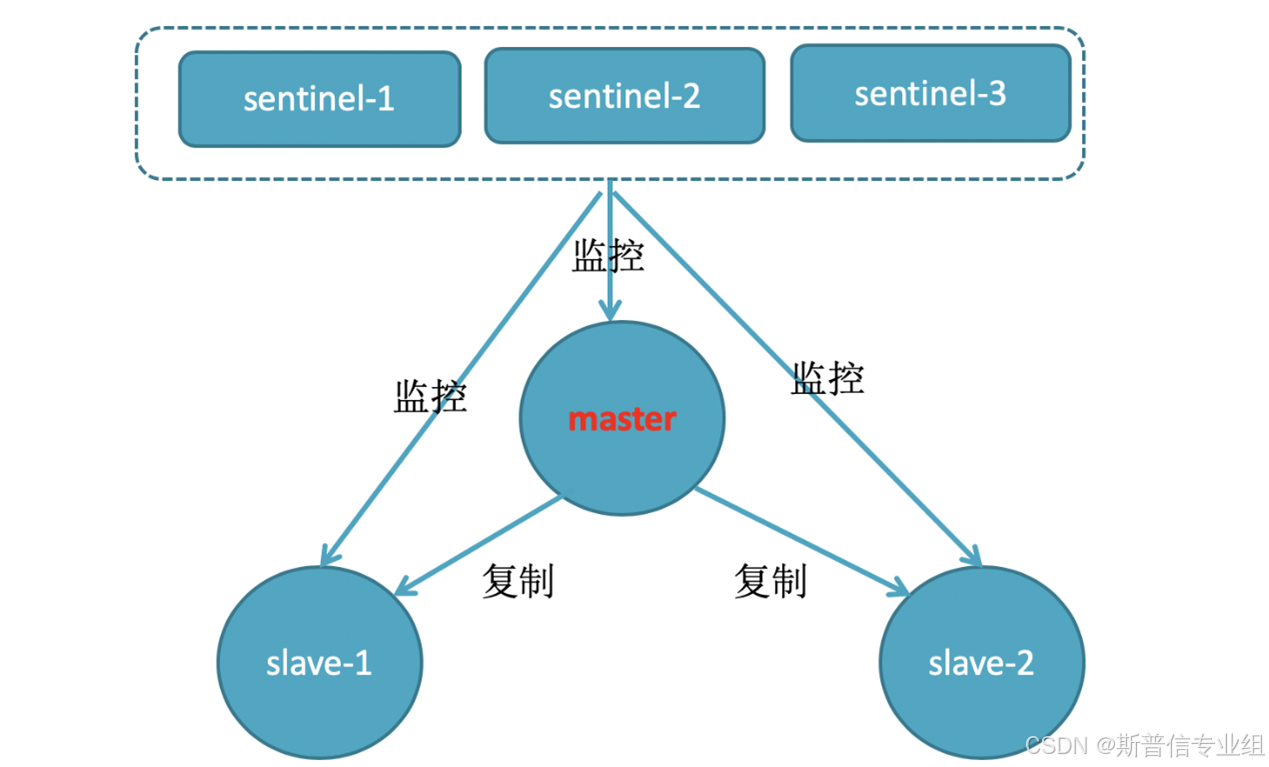
Redis单线程和多线程问题
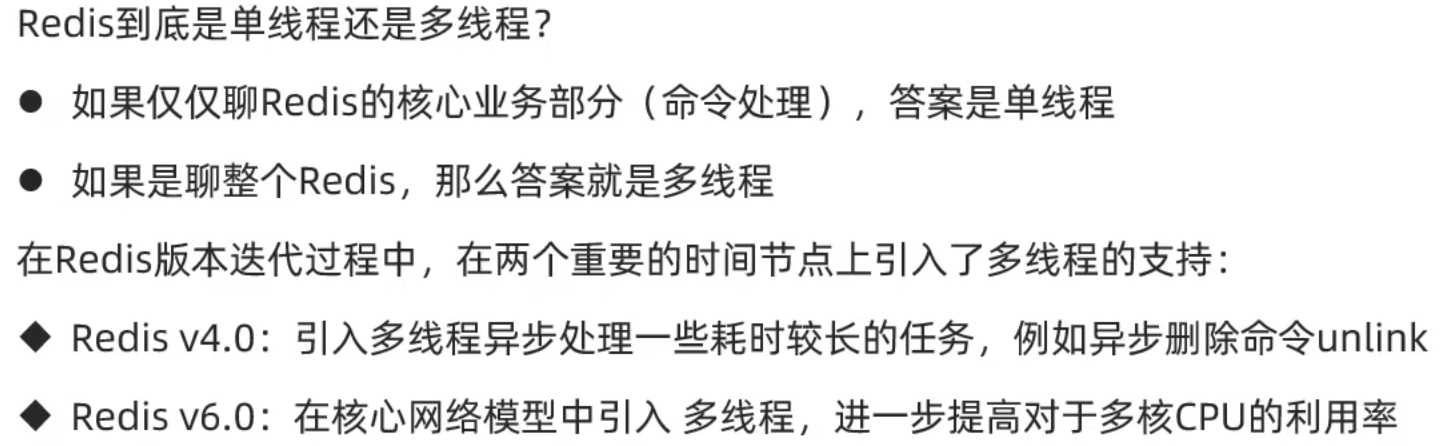
1.Redis为什么使用单线程
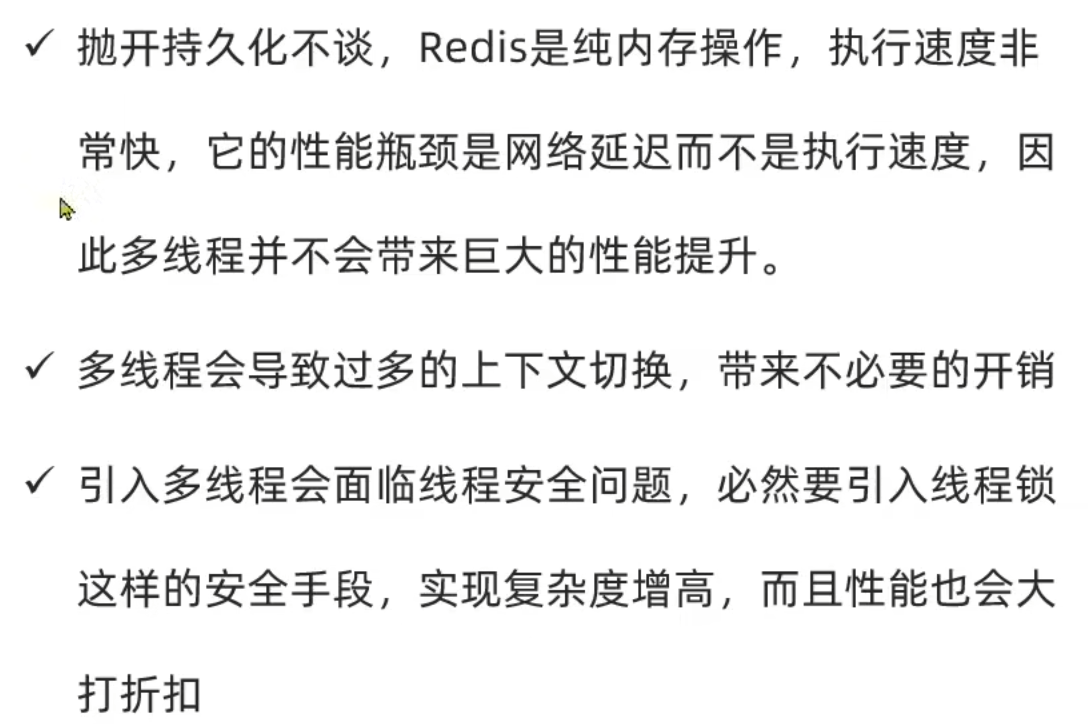
Redis在4.0版本之后,新增了一个新的后台线程,用来异步释放Redis内存,也就是lazyfree+
线程。例如执行unlinkkey/flushdbasync/flushallasync等命令,会把这些删除操作交给后台
线程来执行,好处是不会导致Redis主线程卡顿。因此,当我们要删除一个大key的时候,不要
使用del命令删除,因为del是在主线程处理的,这样会导致Redis主线程卡顿,因此我们应该
使用unlink命令来异步删除大key。
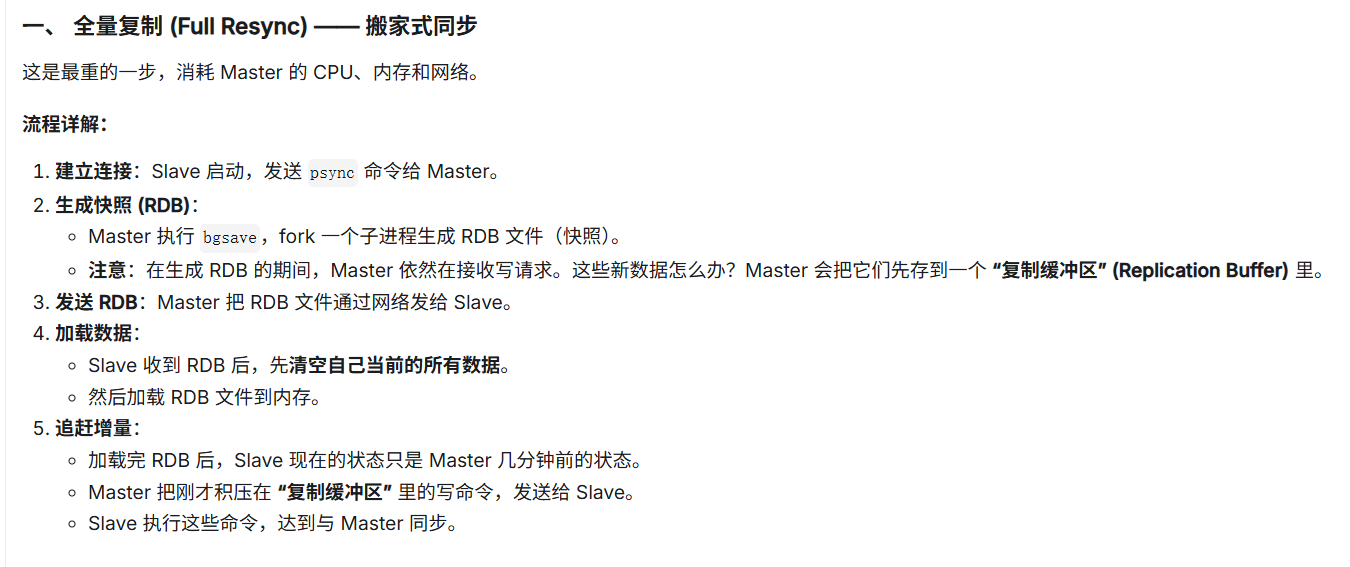
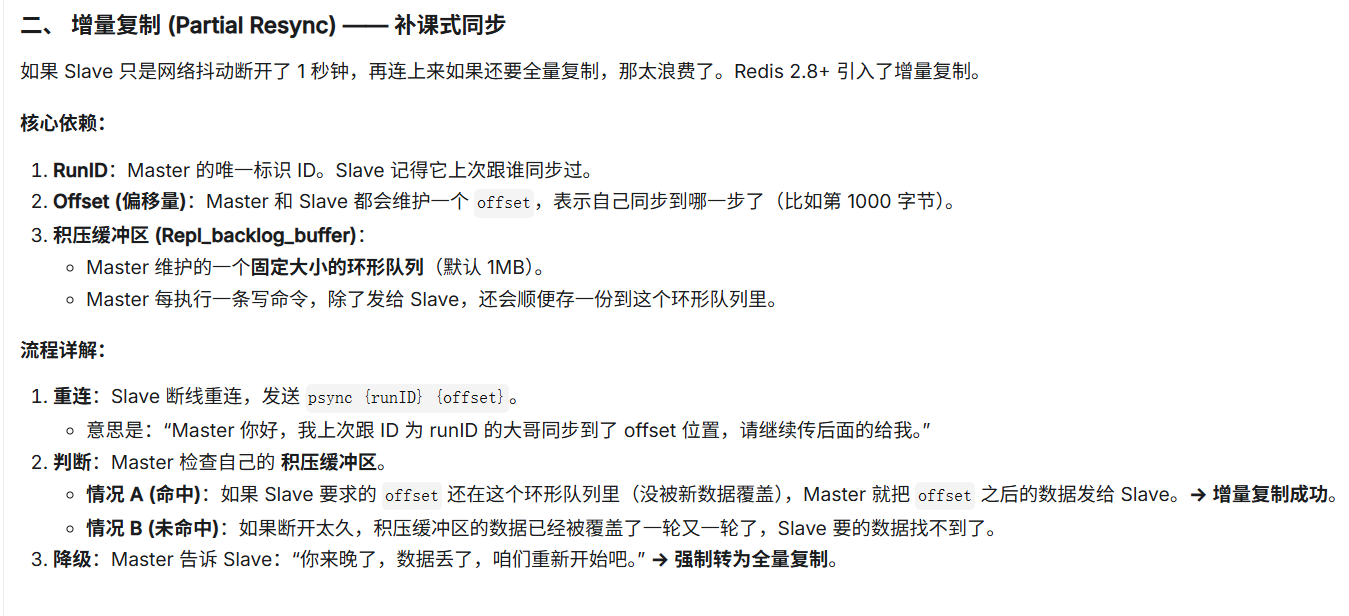
redis的LRU是怎么做的(Redis - LRU原理 + Redis的LRU实现 - frank_cui - 博客园),LFU?
LFU (Least Frequently Used) 的实现(Redis 4.0+)
LFU 要淘汰的是“访问频率最低”的。同样是利用那宝贵的 24 bits,Redis 把它劈成了两半,玩出了花:
- 前 16 bits:记录上次访问时间(LDT, Last Decrement Time)。精度是分钟级,足够用了。
- 后 8 bits:记录访问频次(LOG_C, Logistic Counter)。最大值是 255。
面试官必问难点:8 个 bit 最大只能存 255,如果一个 Key 被访问了 10 万次怎么办?
- 解决方案:对数递增算法 (Logistic Counter)
- 每次访问 Key 时,计数器不是简单地 +1。
- 而是根据当前的计数值,算出一个概率。计数值越大,它加 1 的概率就越小。
- 通过配置 lfu-log-factor 参数,可以控制增长的速度。比如因子设为 10,可能要被访问 100 万次,计数器才会涨到 255。这完美地用 8 个 bit 表示了海量的访问频率。
- 解决方案:随时间衰减 (Decrement)
- 如果一个冷门商品双十一被疯狂访问,频次涨到了 255,但之后一年都没人看了,如果不衰减,它就永远不会被淘汰。
- 所以,在进行访问或淘汰检查时,Redis 会对比前 16 bits(上次访问时间)和当前时间。如果隔了很久,就会把 8 bits 的频次减掉一部分。衰减速度由 lfu-decay-time 配置控制。
- 淘汰过程:和 LRU 一样,也是随机采样 N 个 Key,但在比较时,谁的频次(后 8 bits)最低,就淘汰谁。
redis的扩容过程
redis如何保证数据一致性,如果先写数据库再改缓存,会有什么问题(缓存和数据库一致性问题,看这篇就够了)
先写数据库再改缓存
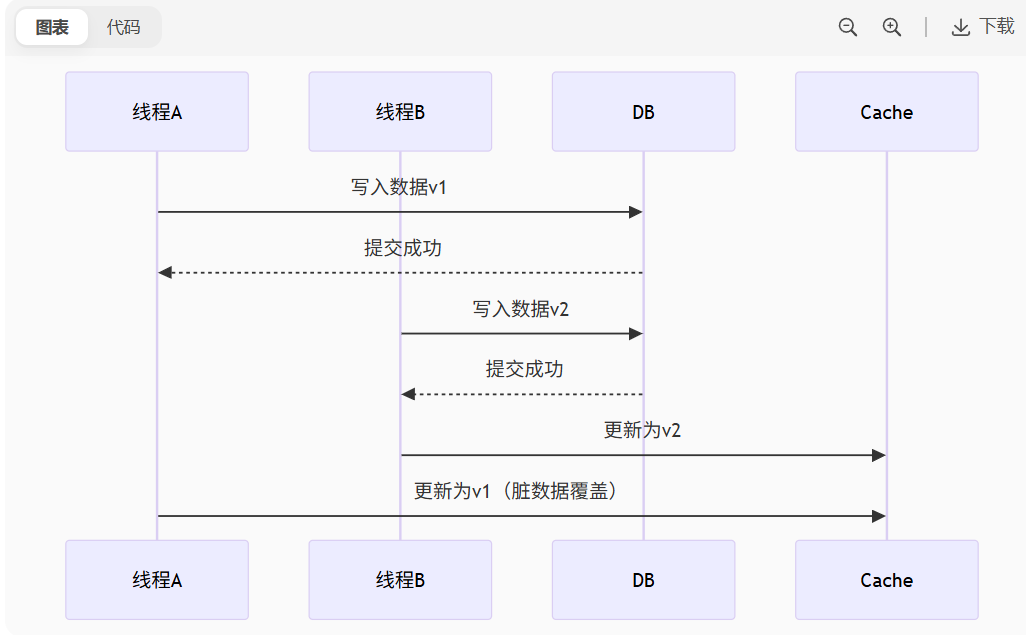
简单介绍一下主动更新,延迟双删流程(出现了什么问题用这个)
Redis有事务吗,为什么,Redis的pipeline是做什么用的?Pipeline是原子性的吗?redis事务底层是如何实现的?
你可以将 Redis 中的事务理解为:Redis 事务提供了一种将多个命令请求打包的功能。然后,再按顺序执行打包的所有命令,并且不会被中途打断。
pipeline
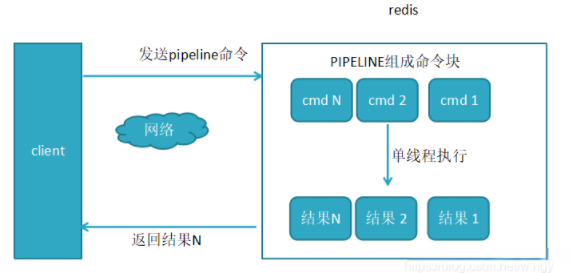
Pipeline(管道) 是 Redis 提供的一种机制,允许客户端在一次网络请求中发送多个命令,减少网络往返(RTT,Round-Trip Time),提高执行效率。
Pipeline 本身 不是原子性的,它只是一个批量发送命令的方式,并不会保证所有命令要么全部执行成功,要么全部失败,如果某个命令失败。
redis线程模型(Redis 6.0 新特性:带你 100% 掌握多线程模型Redis 采用多个 IO 线程来处理网络请求,提高网络请求处 - 掘金)(Java 面试宝典:Redis 的线程模型是怎么样的?Redis 的线程模型其实是分两块的: Redis 6.0 之前的 - 掘金)
Redis 内部使用文件事件处理器 file event handler,这个文件事件处理器是单线程的,所以 Redis 才叫做单线程的模型。它采用 IO 多路复用机制同时监听多个 Socket,根据 Socket 上的事件来选择对应的事件处理器进行处理。
文件事件处理器的结构包含 4 个部分:
- 多个 Socket
- IO 多路复用程序
- 文件事件分派器
- 事件处理器(连接应答处理器、命令请求处理器、命令回复处理器)
多个 Socket 可能会并发产生不同的操作,每个操作对应不同的文件事件,但是 IO 多路复用程序会监听多个 Socket,会将 Socket 产生的事件放入队列中排队,事件分派器每次从队列中取出一个事件,把该事件交给对应的事件处理器进行处理
- 在 6.0 之前,是纯粹的单线程模型。它之所以快,主要是因为它基于纯内存操作和 I/O 多路复用技术,避免了不必要的线程上下文切换和锁竞争。
- 在 6.0 之后,引入了多线程来优化网络 I/O。它的模型变成了‘一个主线程 + 多个 I/O 线程’。
- I/O 线程负责并行地读取请求和写回响应。
- 主线程依然是单线程的,负责执行具体的 Redis 命令。
- 这样做,既利用了多核 CPU 提升了网络吞吐量,又保持了 Redis 命令执行的原子性和无锁特性。”
- 主线程负责 accept 新连接。
- 主线程将建立好的 Socket 连接轮询地交给 I/O 线程。
- I/O 线程负责从 Socket 读取请求数据,并解析出命令。
- I/O 线程把解析好的命令交给主线程去执行。
- 主线程执行完命令,把结果再交给 I/O 线程。
- I/O 线程负责把结果写回给客户端。
什么情况会导致redis分布式锁出现死锁,怎么避免
死锁问题:如果在加锁之后,未设置过期时间、锁忘记释放、加锁后还没来得及释放锁就宕机了 这3种情况都会导致死锁问题。锁误删问题:设置了超时时间,但是 线程执行超过过期时间 后锁误删问题。
- Redisson使用Redis的Lua脚本来实现分布式锁,保证锁的获取和释放是原子操作,避免死锁问题。
- 在获取锁的时候,Redisson会设置一个自动续期的定时任务,在锁即将过期的时候,会自动续期,确保业务逻辑能够在锁有效期内完成。
- 在锁被释放的时候,Redisson会检查当前线程是否为持有锁的线程,如果是才会释放锁,避免误删其他线程的锁。
了解redis的压缩表的数据结构吗?【Redis】数据结构(中)—-ZipList(压缩列表)-CSDN博客)
redis刷新token是如何保证用户无感的
redis为什么选择lua作为原子性操作,lua脚本执行时间很长,怎么排查
Redis 选用 Lua 脚本作为原子操作机制,是因为其天然适配 Redis 的单线程模型,脚本执行过程不会被打断,可以批量操作多个 key,同时具备较小的内存占用和良好的性能。
如果脚本执行时间过长,我们可以通过 slowlog、monitor 和 info cpu 进行排查,定位出卡顿点,再优化数据结构或拆分操作逻辑,确保 Lua 脚本控制在毫秒级以内,避免阻塞其他请求。
如何使用redis实现一个延迟队列(如何基于Redis实现延时任务 | JavaGuide)
讲讲mysql和redis区别?(MySQL与Redis的区别与联系(详细解析!!!)_redis与mysql的联系和区别-CSDN博客)(关系型数据库和非关系型数据库的区别-CSDN博客)
Lua脚本的具体实现
redis宕机了分布式锁如何处理?
1.Redis宕机出现的问题
- 锁丢失:进程还在运行,但锁的数据丢了,其他线程可能抢到“假锁”
- 锁死了:Redis恢复后,老的锁没被释放,造成阻塞
2.Redis 宕机时,怎么保证锁的可靠性?
- Redisson + Redis Sentinel(高可用)
- Redisson 内置支持 Redis 的主从 + 哨兵机制
- 如果主节点宕机,会自动切换到从节点
- Redisson 维护一个本地看门狗机制续约锁,避免因 GC 或短暂故障丢锁
- 哨兵系统会自动故障转移,Redisson 会感知新主节点,锁能“平滑切换”
3.使用 RedLock(Redis 官方分布式锁算法)
- 在多个 Redis 节点(一般是 5 个)上加锁,超过半数成功才认为加锁成功
- 即便其中一个 Redis 宕机,锁依然安全
红锁(Redisson-红锁(Redlock)-使用/原理 - 自学精灵)
解决单节点 Redis 分布式锁的单点故障问题
不用任何组件如何做分布式锁?
基于文件锁 + 网络共享文件系统
**核心思路:**利用 文件系统锁机制,在所有节点之间共享一个目录,然后基于文件进行加锁控制。
技术细节:
使用 共享文件系统:如 NFS、GlusterFS 等
每个节点尝试在共享目录下创建一个文件
lock.file使用 OS 的 文件锁 API:如
fcntl(Linux)、FileChannel.tryLock()(Java)第一个拿到锁的节点可以写入或执行任务,其他等待或失败
示例
1 | |
redis的哈希表扩容机制(一文搞懂Redis的渐进式rehash扩容机制-腾讯云开发者社区-腾讯云)(Redis数据库笔记—— Hash(哈希)的扩容机制(rehash)_redis hash扩容机制-CSDN博客)
redis主库挂了之后无法承接写操作,这期间的写操作的有效性和一致性如何来保证?
Redis连接的最大数量是多少?从哪些角度考虑上面连接的数量?
“Redis 默认的最大连接数配置是 10,000,但这个值并不是随意可以达到的,它受到多方面因素的制约。
- 操作系统限制:Linux 一切皆文件,一个 Socket 占用一个文件句柄。必须通过 ulimit -n 调大系统限制,否则 Redis 设置再高也会被强行截断。
- 资源开销:每个连接都会消耗输入/输出缓冲区内存,连接数过多可能导致内存溢出;此外,过多的活跃连接会让单线程的 CPU 疲于奔命。
Lua脚本的底层原理有了解过吗?
“Redis 执行 Lua 脚本的底层原理,主要依赖于它内嵌的一个轻量级 Lua 5.1 解释器。
- 关于执行:Redis 在内部维护了一个伪客户端。Lua 脚本通过这个伪客户端调用 Redis 命令,复用了原有的命令执行逻辑。
- 关于原子性:得益于Redis的单线程模型。在执行 Lua 脚本期间,Redis 会阻塞所有其他客户端的请求,直到脚本执行完毕。这天然保证了脚本内的操作是不可分割的。
redis超时怎么办
网络链路排查:
- 网络延迟与丢包: 应用服务器和 Redis 服务器之间的网络延迟(RTT)突然增高或发生丢包。
- 排查手段: 在应用服务器上持续 ping 或 mtr Redis 服务器,检查网络质量。
- 带宽打满: 如果 Redis 存了大 Key(如几 MB 的 JSON),高并发读写时可能会瞬间打满网卡带宽。
3. Redis 服务端侧排查(最核心):
- 慢查询阻塞: Redis 是单线程处理命令的。如果某个客户端执行了一条慢查询(如 KEYS *、对几百万个元素的 Set 做 SMEMBERS、或者 HGETALL 一个包含几万个 Field 的大 Hash),所有其他客户端的命令都会被阻塞排队,直到慢查询结束。
- 排查手段: 使用 redis-cli –latency 监控延迟,使用 slowlog get 命令查看慢查询日志。
- AOF/RDB 的 fsync 阻塞: 如果 Redis 开启了持久化,并且 appendfsync 策略设为 always,那么每次写操作都会同步刷盘。如果此时磁盘 I/O 压力大,就会阻塞主线程。
面试真题
Redis 集群模式下,Lua 脚本还能保证原子性吗?跨 slot 可以吗?
直接给出答案:在 Redis 集群(Cluster)模式下,Lua 脚本仍然可以保证原子性,但前提是脚本中操作的所有 Key 必须落在同一个 Hash Slot(哈希槽)中。如果 Lua 脚本尝试操作跨 Slot 的 Key,Redis 集群默认会直接拒绝执行并报错。
秒杀场景里Lua脚本调Redis超时了会有什么问题?答返回失败。追杀,如果只是超时但最终还是执行了呢,库存是否会重复扣减?
核心回答策略:先明确 Lua 脚本在 Redis 中的执行特性,再分析超时带来的具体影响(客户端层面和 Redis 服务端层面)。
你可以这样回答:
在秒杀场景中,我们通常使用 Lua 脚本来保证“判断库存 + 扣减库存”的原子性。如果 Lua 脚本调用 Redis 发生了超时,会引发两个层面的严重问题:
1. 对客户端(业务系统)的影响:状态未知与请求堆积
- 状态未知(这是最头疼的): 客户端(比如 Java 应用)发起了 Lua 脚本执行请求,但因为网络抖动、Redis 负载过高或脚本本身逻辑复杂,导致等待响应的时间超过了客户端设置的 Timeout(比如 2 秒)。此时客户端会抛出 RedisTimeoutException。
- 关键点:客户端此时根本不知道这个 Lua 脚本在 Redis 服务端到底是“完全没执行”、“正在执行中”还是“已经执行完但响应包丢了”。
- 请求堆积与雪崩: 秒杀场景并发极高。如果大量的 Lua 请求因为超时卡在网络 I/O 等待上,会迅速耗尽应用服务器的线程池(Tomcat/Dubbo)和 Redis 客户端连接池,导致整个服务直接瘫痪。
2. 对 Redis 服务端的影响:单线程阻塞与死锁风险
- 阻塞其他请求: Redis 处理命令是单线程的(主要指执行层面)。Lua 脚本在执行期间,Redis 会阻塞其他所有的命令(包括其他秒杀请求、健康检查、主从同步等)。如果你的 Lua 脚本写得很烂,包含死循环或者极其耗时的操作导致超时,那么整个 Redis 实例就“卡死”了,所有请求都会排队甚至超时报错。
- 无法被普通命令打断: 当 Lua 脚本执行时间超过了 lua-time-limit 配置(默认 5 秒)时,Redis 不会自动杀掉脚本。它会开始接受其他请求,但只会对所有请求返回一个 BUSY 错误,除了 SCRIPT KILL(只能杀掉没有执行过写操作的脚本)或 SHUTDOWN NOSAVE 之外,别的命令都不好使。
追问,如果只是超时但最终还是执行了呢,库存是否会重复扣减?
(这是一个极其经典的分布式异常场景:客户端超时报错,但服务端其实执行成功了)
核心回答策略:坦诚承认如果不做特殊设计,必然会导致重复扣减。然后抛出你的解决方案——“幂等性设计”,并详细阐述如何在 Lua 脚本中实现幂等。
你可以这样回答:
第一部分:坦白指出问题所在 (Yes, it will duplicate without idempotency)
是的,面试官您说得非常对。如果客户端因为网络超时(比如等了 2 秒没收到回复)抛出了异常并返回了“秒杀失败”,但实际上那个 Lua 脚本在 Redis 端又花了几十毫秒成功执行完毕了。
此时,如果用户不甘心,再次点击“抢购”按钮(或者系统设置了自动重试),新的请求打过来,再次执行 Lua 脚本。如果不做任何特殊处理,Lua 脚本会再次扣减库存,这就导致了同一个人扣了两次库存,不仅超卖,也违背了“限购一件”的业务规则。
第二部分:给出解决方案 —— 必须实现 Lua 脚本的“幂等性” (How to solve it)
为了彻底解决这个问题,我们绝对不能依赖客户端的超时与否来判断执行结果,必须在 Redis 端通过 Lua 脚本实现强幂等性校验。
具体做法是:将“扣库存”和“记录用户已抢购凭证”这两个操作放在同一个 Lua 脚本中原子执行。
Lua脚本执行一半失败了重试能恢复吗(原子性定义不同 + 幂等性)
1. Lua 脚本在 Redis 中的“原子性”到底指什么?
Redis 执行 Lua 脚本的原子性,仅仅是指**“在执行这段 Lua 脚本的期间,Redis 服务器的单线程会被独占,不会有任何其他客户端的命令插队执行”**。它保证的是一种排他性,防止并发竞争。
2. 执行一半失败了会怎样?(核心区别:不支持自动回滚!)
如果在 Lua 脚本执行的过程中发生了异常(比如你在脚本执行了 3 条写命令:SET A, INCR B, 然后在第 3 条 SET C 时报错了):
- 如果是语法错误(编译期): 脚本根本不会执行。
- 如果是运行时错误(最可怕): 比如用 INCR 命令去操作了一个字符串类型(String)的 Value。
- 此时,报错的那条命令会立刻失败,并且脚本立即终止。
- 但是,在这条报错命令之前,已经在 Lua 脚本中成功执行的那些写操作(如 SET A, INCR B),Redis 绝对不会帮你自动回滚!它们永久生效了。
“在 Redis 中执行 Lua 脚本的‘原子性’,仅仅指其在执行期间独占单线程,防止并发竞争,而绝不代表它具备像 MySQL 事务那样的自动回滚(Rollback)能力。如果 Lua 脚本执行到一半因为运行时异常(如类型错误)崩溃,已经成功执行的写操作(例如扣减了库存)会永久生效。此时,如果客户端因为网络超时或收到异常而盲目发起重试,极易导致诸如‘库存被重复扣减’的数据混乱灾难。因此,能否通过重试恢复,完全取决于我们在编写 Lua 脚本时是否设计了强幂等性防线。正确的做法是:在脚本核心逻辑执行前,必须首先利用 EXISTS 等命令检查一个唯一业务标识(如 order_id)的状态;只有在确认该标识不存在时才放行执行后续扣减操作,并在成功后立即通过 SET 等命令记录该状态标识。这样,即使脚本后续报错导致客户端重试,前置的幂等校验也会将重复请求拦截,从而彻底隔绝因重试引发的脏数据风险。”
Redis 脚本在集群模式下会有一致性问题吗?如何解决?
如果单机redis迁移到集群架构,会出现什么问题,这个时候如何保证一致性?
在单机时代跑得好好的代码,上了集群可能会大面积报错(CROSSSLOT 错误)。这是因为集群把数据打散到了不同的节点上。
1. MGET / MSET / DEL 等多键(Multi-Key)操作失效
- 现象: 单机时,你可以愉快地 MGET key1 key2 key3。但在集群模式下,这三个 Key 经过 CRC16 计算后,极大概率会落入不同的哈希槽(Hash Slot),而这些槽分布在不同的物理节点上。
- 报错: Redis Cluster 严格禁止跨节点的原生多键操作,会直接抛出 CROSSSLOT Keys in request don’t hash to the same slot 错误。
- 解决方案:
- 业务侧改造(Hash Tag): 在设计 Key 时,使用 {} 将需要绑定在一起的 Key 强行路由到同一个槽。例如:user:{1001}:info 和 user:{1001}:orders。Redis 计算哈希时只会对大括号 {} 内的字符串(1001)进行 Hash 计算,确保它们永远落在同一个节点上,从而可以继续使用 MGET。
- 客户端层聚合: 很多高级客户端(如 Jedis Cluster, Redisson)在底层帮你把 MGET 拆分成了多个单键的 GET 请求,并发发送给不同节点,再在客户端把结果拼装起来返回给你。(注意:这会增加网络 RTT 开销,破坏了原本的原子性)。
2. Lua 脚本执行失败(最核心的痛点)
- 现象: 秒杀扣库存、分布式锁等依赖 Lua 脚本保证原子性的操作,如果脚本里操作了多个 Key(比如查库存 Key,写防重 Key)。
- 报错: 同样会报 CROSSSLOT 错误,因为集群模式下,执行 Lua 脚本的那个节点,可能根本没有你要操作的另外几个 Key 的数据。
- 解决方案: 必须且只能通过 Hash Tag ({}),强行把 Lua 脚本里涉及到的所有 Key 都分发到同一个哈希槽(同一个节点)上。这也是集群环境下使用 Lua 脚本的硬性前提。
了解 Redis 底层的存储逻辑吗?Redis 的性能单点能够有多少?集群能够有多少?
问题 1:了解 Redis 底层的存储逻辑吗?
面试核心策略:不要只停留在 5 大基本数据类型(String, List, Hash, Set, ZSet),要深入讲解 Redis 内存中的“全局哈希表(Dict)”和“对象系统(redisObject)”,以及底层数据结构的动态转换。
回答:
“Redis 之所以快,底层存储逻辑的精妙设计是关键。它的存储架构可以分为宏观和微观两个层面:
- 宏观层面:全局哈希表 (Dict)
- Redis 数据库的本质就是一个巨大的字典(Dict)。无论是 String 还是庞大的 Hash,所有的 Key 都是字符串,存储在这个全局哈希表中。
- 这个哈希表的查找时间复杂度是 O(1)。它通过链式哈希解决冲突,并在数据量增大时通过渐进式 Rehash(平摊开销,不阻塞主线程)来动态扩容。
- 微观层面:对象系统 (redisObject)
- 全局哈希表里的 Value,并不是直接存具体的数据,而是存了一个指针,指向一个 redisObject 结构体。
- 这个对象头包含了数据类型(type,如 String/List)、编码方式(encoding)、以及用于 LRU/LFU 淘汰策略的 24 位时钟字段。
- 底层数据结构的动态转换(核心亮点):
- 为了极致的压榨内存和提升性能,Redis 的每种基本类型都至少有两种底层的 C 语言数据结构实现,并会根据数据的大小和元素数量自动转换。
- String: 如果是数字,用 int 存;如果是短字符串,用 embstr(和 redisObject 连续分配,只分配一次内存);长字符串用 raw(动态字符串 SDS)。
- Hash/ZSet: 元素少时,用极其紧凑的压缩列表(ziplist)(Redis 7.0 以后换成了更优秀的紧凑列表 listpack),省去了指针开销;元素多时,平滑升级为**哈希表(hashtable)或跳表(skiplist)**以保证 O(1) 或 O(logN) 的查询效率。
总结: Redis 底层存储是一套以全局 O(1) 哈希表为骨架,内部通过 redisObject 封装,并极致运用紧凑数据结构(如 listpack/ziplist)来平衡内存和 CPU 性能的精密系统。”
问题 2:Redis 的性能单点能够有多少?集群能够有多少?
面试核心策略:给出具体的量级数据(QPS),并解释为什么能达到这个量级,以及集群线性扩展的原理。
回答:
“1. 单点性能(Standalone):
- 在普通服务器的千兆/万兆网卡环境下,处理简单的 KV 读写(如 GET/SET 小于 1KB 的数据),Redis 官方标称单节点可以达到 10 万 QPS(每秒查询率)。
- 在实际生产环境,如果配合 Pipeline(管道)批量操作,或者对内核和网卡做极致调优,甚至能突破 15 万到 20 万 QPS。
- 为什么这么快? 除了全内存操作和刚才说的高效数据结构外,最核心的是它采用了单线程的 Reactor 模式(基于 I/O 多路复用如 epoll)。单线程避免了多线程上下文切换和锁竞争的开销,这在纯内存操作且没有阻塞的情况下是最高效的。
- 集群性能(Cluster):
- 理论上,Redis Cluster 的性能是线性可扩展的。
- 集群最大支持 1000 个节点,官方推荐最大规模在 1000 个节点以内。
- 假设我们部署了一个 10 主 10 从的集群,每个主节点承担 1/10 的流量(通过 16384 个哈希槽 Slot 分片)。如果单节点能抗 10 万 QPS,那么这个 10 节点的集群理论上就能抗下 100 万 QPS。
- 性能损耗注意(亮点): 在集群模式下,如果客户端请求的 Key 不在当前连接的节点上,节点会返回 MOVED 重定向指令,这会增加一次网络 RTT 延迟。因此,我们通常要求使用智能客户端(如 Jedis Cluster),在本地缓存 Slot 映射表,实现直连目标节点,最大化集群性能。”
面试总结lua的原理和优势
Lua 的底层原理其实可以简单理解成:它本身不是一个独立的大型运行环境,而是一个非常轻量的小型脚本引擎,通常嵌入到别的程序里使用。比如 Redis 里执行 Lua 脚本,本质上就是 Redis 这个 C 程序内部集成了 Lua,然后把脚本交给 Lua 去执行。所以 Lua 的定位不是自己当主程序,而是给宿主程序提供一种“动态写逻辑”的能力。这样原本用 C 写死的逻辑,就可以通过脚本灵活调整,不需要重新编译整个系统。
执行时,Lua 也不是一行一行直接读源码,而是先把脚本转换成一套内部能识别的字节码,然后交给自己的虚拟机执行。你可以把这个虚拟机理解成一个小型解释器,只不过 Lua 的虚拟机效率比较高,因为它不像很多虚拟机那样大量依赖栈操作,而是更像 CPU 一样直接用“寄存器”存变量。这样做的好处就是同样一段逻辑,需要执行的指令更少,所以 Lua 的运行速度会比较快。
Lua 和宿主程序之间的数据交换,则是通过一块“中间缓冲区”来完成,这就是它的虚拟栈。可以理解成 Redis 想调用 Lua 时,会先把参数按顺序放到一个盒子里,Lua 从盒子里拿数据处理,处理完再把结果放回盒子顶端,Redis 再把结果取出来。整个过程中,宿主程序和 Lua 不直接碰对方内部内存,而是通过这层缓冲区传递数据,这样可以避免内存冲突,也更安全稳定。
- 绝对的“原子性” (Atomicity) —— (最核心优势)
- 场景: 比如你要做扣减库存的操作(先查询库存够不够,再扣减)。如果是两次独立的请求,在高并发下一定会出现超卖。
- Lua 解决: Redis 会把整个 Lua 脚本作为一个整体来执行。在执行脚本的过程中,Redis 不会去执行其他客户端发来的命令。 这天然就保证了多个操作的绝对原子性,甚至不需要加复杂的分布式锁。
- 减少网络开销 (Reduce Network Overhead)
- 场景: 如果你需要根据 A 的结果去查 B,再根据 B 查 C。如果不使用 Lua,你需要和 Redis 交互 3 次(3次网络往返时间 RTT)。
- Lua 解决: 把这段逻辑写在一个 Lua 脚本里一次性发给 Redis。在 Redis 服务端内部执行完毕后,直接返回最终结果。将 3 次网络传输变成了 1 次,极大地提升了吞吐量。