消息队列:知识点
以下笔记整理自个人学习,覆盖堆积、可靠性、重复消费、顺序消息等主题,便于检索与复习。
消息队列如果发生消息堆积怎么办?(字节面试:如何解决MQ消息积压问题?MQ(Message Queue)消息积压问题指的是在消息队列中累积了大量未处理的消 - 掘金)
1.消息堆积问题的危害
- 系统性能下降:当消息堆积量过大时,消息队列的处理能力可能受到影响,甚至导致系统的整体性能下降。
- 消息延迟:随着队列中消息的增多,新消息的消费速度变慢,导致消息的处理延迟增加,用户体验变差。
- 内存溢出和磁盘空间耗尽:如果消息堆积持续增长,队列可能会占用过多的内存或磁盘空间,最终导致内存溢出或磁盘空间耗尽。
- 消息丢失:某些消息队列系统可能在消息堆积到一定程度后丢弃旧消息,从而造成数据丢失。
2.消息堆积的类型
- 突发性消息堆积:生产者在短时间内产生大量的消息,导致消费者一时无法处理。通常是由于系统的流量激增或特殊事件(如促销活动)导致的。
- 持续性消息堆积:生产者产生消息的速度持续超过消费者的消费速度,导致消息逐渐积压。此类问题通常是系统设计或配置不合理的结果。
- 周期性消息堆积:消息堆积呈现周期性变化,可能与系统的负载峰谷相关,例如白天访问量大、夜间访问量低。
3.消息生产速度分析
消息堆积的一个常见原因是生产者发送消息的速度过快,超过了消费者的处理能力。在这种情况下,消费者无法及时消费所有的消息,导致消息不断积压。
排查思路:
- 检查生产者的消息发送速率。
- 确定生产者发送的消息是否异常,例如是否有某些业务逻辑导致短时间内发送大量重复或无效消息。
- 分析生产者的流量是否超出了系统的设计范围,是否有突然增加的流量高峰。
解决方案:
- 通过限流手段控制生产者的发送速率,防止短时间内发送过多消息。
- 使用流量整形(Traffic Shaping)手段,将消息发送的速度平滑化,避免突发流量。
- 如果是系统流量激增导致的堆积,考虑通过弹性扩展增加消费者实例,缓解堆积。
消息去重与有效性
某些情况下,生产者可能会因为代码问题或业务逻辑错误,产生大量重复或无效的消息。这些无效的消息占用了消息队列的资源,影响了消费者的正常工作。
排查思路:
检查消息的唯一性标识(如 messageId),确定是否有大量重复消息。
分析消息内容的有效性,确保没有生产空消息或无效消息。
解决方案:在生产者端增加去重机制,确保同一条消息不会被重复发送。
对消息内容进行校验,避免发送无效消息。
消息生产失败与重试机制
如果消息在发送过程中失败,生产者通常会自动进行重试。然而,如果重试机制设计不合理,可能会导致生产者发送大量重复消息,从而导致消息堆积。
排查思路:
- 分析生产者的重试机制,检查是否存在频繁重试的现象。
- 确定消息发送失败的原因,是否是由于网络问题、队列满等情况导致的。
解决方案:
- 优化生产者的重试机制,设置合理的重试间隔和重试次数,避免频繁重试。
- 使用幂等机制,确保消息发送的重复操作不会影响业务逻辑。
4.消费者处理能力不足
消费者的处理能力不足是导致消息堆积的主要原因之一。如果消费者处理消息的速度低于生产者的发送速度,消息就会不断堆积。
解决方案:
- 扩展消费者实例,增加消费线程或部署更多的消费者实例,提升消息的处理速度。
- 优化消费者的代码逻辑,减少不必要的计算或 I/O 操作,提高消费效率。
- 使用多线程或异步处理的方式,提升消费者的并发处理能力。
消费者重试机制问题
在某些情况下,消费者处理消息失败时会进行重试。如果重试机制设计不合理,可能会导致消费者反复处理失败的消息,进一步加剧消息堆积问题。
排查思路:
- 分析消费者的重试机制,确定是否存在频繁重试的现象。
- 检查消息处理失败的原因,是否由于网络问题、数据不一致等导致。
解决方案: - 设置合理的重试间隔和重试次数,避免频繁重试。
对于某些无法立即处理的消息,可以将其放入死信队列,避免影响其他正常消息的处理。
5.如何防止消息堆积问题
除了针对性的解决方案外,合理的系统设计和配置可以有效预防消息堆积问题的发生。以下是一些常见的防止消息堆积的策略:
5.1 使用限流机制
通过限流机制,可以控制生产者的消息发送速度,避免在高并发场景下生产者发送过多的消息,导致消息堆积。
5.2 动态扩容
在流量激增的情况下,可以通过动态扩容的方式增加消费者实例,提升系统的处理能力。
5.3 使用死信队列
对于无法正常处理的消息,可以将其放入死信队列(Dead Letter Queue,DLQ),避免影响其他消息的正常消费。
5.4 消息过期与优先级队列
对于一些时效性较强的消息,可以设置过期时间,确保消息在一定时间后自动失效,避免长期积压。此外,优先级队列可以确保高优先级的消息被优先处理。
5.5 合理设置消费者重试策略
对于消费者的重试机制,需要设置合理的重试次数和间隔,避免频繁重试导致系统性能下降。
MQ怎么保证消息的可靠性的(RabbitMQ进阶–保证消息的可靠性_rabbitmq 消息可靠性-CSDN博客)
1.保证MQ消息可靠性的三种方式
1.1发送者可靠性
生产者重试机制
1 | |
生产者确认机制
我个人认为,生产者确认机制对性能影响较大,无特殊需要不要开启
一般情况下,只要生产者与MQ之间的网路连接顺畅,基本不会出现发送消息丢失的情况,因此大多数情况下我们无需考虑这种问题。
不过,在少数情况下,也会出现消息发送到MQ之后丢失的现象,比如:
- MQ内部处理消息的进程发生了异常
- 生产者发送消息到达MQ后未找到Exchange
- 生产者发送消息到达MQ的Exchange后,未找到合适的Queue,因此无法路由
针对上述情况,RabbitMQ提供了生产者消息确认机制,包括Publisher Confirm和Publisher Return两种。在开启确认机制的情况下,当生产者发送消息给MQ后,MQ会根据消息处理的情况返回不同的回执。
- 当消息投递到MQ,但是路由失败时,通过Publisher Return返回异常信息,同时返回ack的确认信息,代表投递成功
- 临时消息投递到了MQ,并且入队成功,返回ACK,告知投递成功
- 持久消息投递到了MQ,并且入队完成持久化,返回ACK ,告知投递成功
- 其它情况都会返回NACK,告知投递失败
其中ack和nack属于Publisher Confirm机制,ack是投递成功;nack是投递失败。而return则属于Publisher Return机制。
默认两种机制都是关闭状态,需要通过配置文件来开启。
在生产者中添加配置
1 | |
这里publisher-confirm-type有三种模式可选:
- none:关闭confirm机制
- simple:同步阻塞等待MQ的回执
- correlated:MQ异步回调返回回执
添加之后需要去配置一个ReturnCallback,每个RabbitTemplate只能配置一个ReturnCallback,因此我们可以在配置类中统一设置。我们在publisher模块定义一个配置类(如果返回 nack则会调用这个方法:
1 | |
MQ可靠性
交换器的持久化,队列的持久化,消息的持久化
消费者可靠性
由于消息回执的处理代码比较统一,因此SpringAMQP帮我们实现了消息确认。并允许我们通过配置文件设置ACK处理方式,有三种模式:
- none:不处理。即消息投递给消费者后立刻ack,消息会立刻从MQ删除。非常不安全,不建议使用
- manual:手动模式。需要自己在业务代码中调用api,发送ack或reject,存在业务入侵,但更灵活
- auto:自动模式。SpringAMQP利用AOP对我们的消息处理逻辑做了环绕增强,当业务正常执行时则自动返回ack. 当业务出现异常时,根据异常判断返回不同结果:
- 如果是业务异常,会自动返回nack;
- 如果是消息处理或校验异常,自动返回reject;
消费者重连机制
当消费者出现异常后,消息会不断requeue(重入队)到队列,再重新发送给消费者。如果消费者再次执行依然出错,消息会再次requeue到队列,再次投递,直到消息处理成功为止。
极端情况就是消费者一直无法执行成功,那么消息requeue就会无限循环,导致mq的消息处理飙升,带来不必要的压力:当然,上述极端情况发生的概率还是非常低的,不过不怕一万就怕万一。为了应对上述情况Spring又提供了消费者失败重试机制:在消费者出现异常时利用本地重试,而不是无限制的requeue到mq队列。
修改consumer服务的application.yml文件,添加内容:
1 | |
重启consumer服务,重复之前的测试。可以发现:
- 消费者在失败后消息没有重新回到MQ无限重新投递,而是在本地重试了3次
- 本地重试3次以后,抛出了AmqpRejectAndDontRequeueException异常。查看RabbitMQ控制台,发现消息被删除了,说明最后SpringAMQP返回的是reject
结论:
- 开启本地重试时,消息处理过程中抛出异常,不会requeue到队列,而是在消费者本地重试
- 重试达到最大次数后,Spring会返回reject,消息会被丢弃
失败处理策略
在之前的测试中,本地测试达到最大重试次数后,消息会被丢弃。这在某些对于消息可靠性要求较高的业务场景下,显然不太合适了。
因此Spring允许我们自定义重试次数耗尽后的消息处理策略,这个策略是由MessageRecovery接口来定义的,它有3个不同实现:
- RejectAndDontRequeueRecoverer:重试耗尽后,直接reject,丢弃消息。默认就是这种方式
- ImmediateRequeueMessageRecoverer:重试耗尽后,返回nack,消息重新入队
- RepublishMessageRecoverer:重试耗尽后,将失败消息投递到指定的交换机
消息堆积问题(消息队列(MQ)消息堆积问题排查与解决思路_mq消息堆积问题排查-CSDN博客)(字节面试:如何解决MQ消息积压问题?MQ(Message Queue)消息积压问题指的是在消息队列中累积了大量未处理的消 - 掘金)
消息队列怎么保证有序,业务层面怎么保证订单到达的顺序(消息队列(五)如何保证消息的顺序性?_Java_奈何花开_InfoQ写作社区)
四种队列的对比(Kafka、RabbitMQ、RocketMQ与ActiveMQ:消息队列比较与选型指南-CSDN博客)
一、 核心设计定位 (The “Why”)
- RabbitMQ:
- 定位:传统的消息中间件。
- 核心:Erlang 语言编写,实现了 AMQP(高级消息队列协议)。
- 强项:复杂路由、低延迟、高可靠性。它像一个精密的“邮局”,非常擅长处理复杂的业务逻辑流转(如订单状态机、金融支付)。
- Kafka:
- 定位:分布式的流处理平台。
- 核心:Scala/Java 编写。
- 强项:超高吞吐、大数据存储、日志处理。它更像一个巨大的“日志管道”,甚至可以被视为一个分布式存储系统。
二、 架构模式与存储 (Architecture)
- 消息存储:
- RabbitMQ:内存为主,磁盘为辅。消息被消费后通常会立刻删除。它不适合存储大量积压的消息,积压会导致性能急剧下降。
- Kafka:基于磁盘的日志文件 (Log)。消息是追加写入(Append Only)的,并且会持久化保留(比如保留 7 天),无论是否被消费。这使得 Kafka 可以随时“回放”历史消息。
- 消费模型:
- RabbitMQ:推模式 (Push) 为主。Broker 主动把消息推送给消费者(需要做 QoS 限流)。
- Kafka:拉模式 (Pull)。消费者自己去 Broker 拉取消息,消费速度由消费者自己控制(配合 offset 记录消费进度)。
- 路由机制:
- RabbitMQ:非常强大。有 Exchange (交换机) 概念(Direct, Topic, Fanout),可以在 Broker 端实现极其复杂的路由规则。
- Kafka:非常简单。只有 Topic 和 Partition。生产者直接发给 Topic,没有复杂的路由逻辑。
三、 性能与吞吐量 (Performance)
- Kafka:吞吐量之王。
- 单机可以轻松达到 10万+ 甚至百万级 QPS。
- 秘诀:零拷贝 (Zero Copy)、磁盘顺序写 (Sequential Write)、批量发送 (Batching)。
- RabbitMQ:吞吐量一般。
- 单机通常在 万级 QPS。
- 虽然吞吐量不如 Kafka,但它的延迟极低(微秒级),适合对实时响应要求极高的在线业务。
四、 选型建议(面试总结)
“如果面试官问怎么选,我会这么说:
- 选 RabbitMQ 的场景:
- 需要处理复杂的路由逻辑(如根据 Header 分发)。
- 对延迟极度敏感(如金融交易)。
- 数据量不大,且需要极高的数据可靠性(不支持消息丢失)。
- 选 Kafka 的场景:
- 大数据日志采集(ELK)。
- 实时流计算(Flink/Spark Streaming)。
- 超高并发的削峰填谷。
- 需要回溯/重放历史消息的场景。”
1.kafka消息队列(【消息队列】——Kafka入门一篇就够了!_kafka消息队列-CSDN博客)(一文看懂-Kafka消息队列 - Flamings - 博客园)(https://blog.csdn.net/weixin_45366499/article/details/106943229)
- RabbitMq:基于AMQP协议,可靠性很强,支持ACK, 延迟消息,消息路由,适合对数据一致性和可靠性要求高的场景,比如订单系统、通知系统。我实际用它做过电商项目的下单异步处理。
- Kafka:吞吐量非常高,是一个分布式的日志系统,适合大数据、日志采集、流式计算场景。它支持分区、顺序性,偏向高性能批量处理,但不支持延迟消息。
- RocketMQ: 阿里开源,天然支持分布式部署,原生支持事务消息、延迟消息,在国内金融、电商领域用得很多,适合需要高吞吐+事务保障的场景。
如果面试官继续追问:“你们为什么选 RabbitMQ?
我们当时选用的是 RabbitMQ,主要基于两个考虑:
- 业务需要可靠性高,比如订单、支付链路需要保证消息不丢失、支持ACK机制, 以及支持延时队列功能,在消费失败能成功人工介入;
- RabbitMq管理控制台比较直观。
实际上,我觉得选 MQ 不是“谁好用谁上”,而是要看:
- 业务对可靠性 / 性能 / 延迟 / 顺序性的要求;
- 团队熟悉程度和社区活跃度;
- 是否需要事务 / 延迟 / 死信队列等功能。
你消息队列用哪种比较多?它在实现高性能方面做了哪些优化或者设计
- RabbitMQ 的核心是基于 Erlang 构建的 Actor 模型,天生支持高并发和异步消息传递。
- 利用 Exchange(交换机)+ Binding + RoutingKey 的灵活组合,支持多种路由策略(Direct, Topic, Fanout, Headers),实现精准高效路由。
- RabbitMQ 会优先将消息缓存在内存中(page cache),等到达到阈值才写磁盘,提升性能。磁盘顺序写优化(尤其对于持久化队列),保证即使重启也不会丢数据。
- 支持 手动/自动 ACK 确认机制,可以结合批量确认来减少网络交互、提高吞吐。
如果要提升mq的消费吞吐能力,要怎么做呢?
了解RabbitMQ的实现细节吗?RabbitMQ怎么实现持久化的?
设计短链系统,给了场景,需要压缩的链接百万级,提示不建议用算法,考虑好开始说(字节三面:如何设计一个高性能短链系统?-腾讯云开发者社区-腾讯云)
改一下:当用自增id时,用户访问短链时,系统解码短链字符串,还原出ID。
文件中有100亿个无序整数,内存100M,找中位数
【1】第一次扫描(分桶统计)
- 定义一个范围划分(比如按照数值大小区间分桶)。
- 比如整个数值可能落在[-2^31, 2^31-1]。
- 切成很多区间,比如1亿个区间,每个区间负责一小段值域。
- 扫描一遍数据,每个数丢到对应的区间里,只统计各个桶的数量(用一个小数组存每个桶里的数量,不存具体数字)。
➡️ 目的是为了快速定位中位数在哪个区间。
【2】确定中位数所在桶
- 扫描完后,加上每个桶的计数,累加到第50亿个数,看中位数落在哪个桶。
- 比如中位数落在第K个桶。
【3】第二次扫描(精确处理中位数桶)
- 重新扫一遍文件,只把落到第K个桶的数读出来(这部分数据量远小于全部)。
- 这部分数据量可能几百万、几千万,内存能放得下了(或者继续分批放)。
【4】排序+找中位数
- 把第K个桶的数据拿到内存里,进行快速排序(或者其他简单的排序算法)。
- 排好后取第k个数,就是全局中位数。
消息消费失败了怎么办?如果回过头来做? 怎么做到不丢消息?(可以用到项目中)
要做的:
消息不丢失:消费失败不能导致消息彻底消失。
可重复消费(重试):失败后可以重新消费。
幂等性:同一条消息消费多次,结果一致。
可追溯性:知道哪条消息失败了,能查、能修复。
手动 ACK(不要自动确认):如果你的消费逻辑失败了,不要确认(ack)消息,让消息队列重投。
死信队列:消费失败消息,超过最大重试次数,就会被送入 死信队列(DLQ)。死信队列可用于:后续分析 / 人工处理/补偿系统定时拉出再处理
1
消息消费失败 → 保存失败记录到 DLX → 定时任务补偿 → 再次投递消息 or 人工处理消息落库(失败消息存数据库):如果你的消息非常关键,比如支付扣款、订单发货,可以在消费失败时把消息保存到数据库。后台启动一个补偿程序(定时任务)去扫数据库,重新消费这些失败消息。
1
消息消费失败 → 保存失败记录到 MySQL → 定时任务补偿 → 再次投递消息 or 人工处理保持幂等性(防止重复消费出问题)
补偿机制:定时任务重试失败记录:写一个定时任务,定时从失败消息表中读取消息,重新投递或重新处理.
消息超过 N 次失败,标记为“毒消息”:毒消息(Poison Message) 是指:即使重试 10 次,还是失败的消息。如果定时任务扫描N次还是失败,标记为“待人工干预”,存入数据库,触发 告警(钉钉 / 微信 / 邮件)。
如果设计个web server你会怎么设计,tcp你如何处理呢,多路复用你如何来做,不是原理,TCP优化你能想到什么,除了多路复用
##生产者消费者模型你怎么实现,用什么数据结构,如果这个消息包非常大,你如何处理
集群如何保证一致性
讲一下如果让你设计一个jvm,如何管理内存的申请和释放,不要那么复杂的结构,申请,释放过程是怎样的,用的什么数据结构,复杂度是多少,有没有更简单的结构,不是OS内存是进程里面如何设计,如果一个大对象如何分配内存。
假如核心线程还没满,有几个空闲的核心线程,又来了一个新任务,此时会怎么做?(答错了 应该是新建核心线程)
如何实现一个无锁化的并发数据结构?
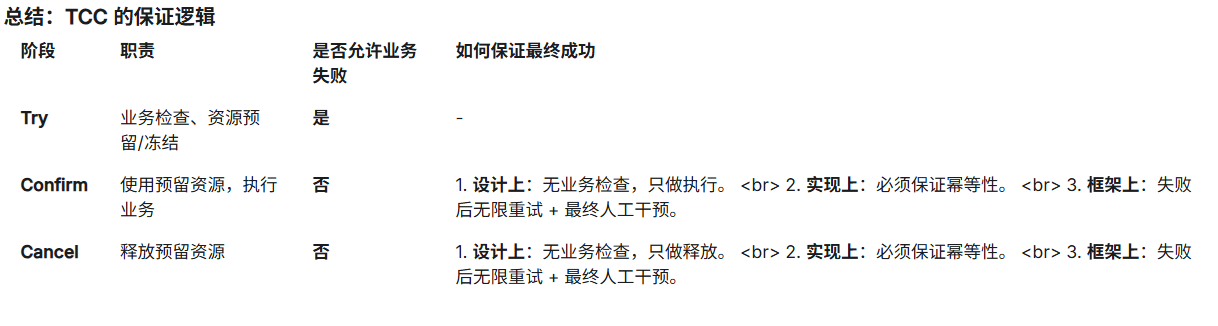
了解分布式事务吗?聊聊 2PC、3PC、Seata、TCC?(浅谈分布式事务及解决方案 | 京东物流技术团队1 背景 在讲述分布式事务的概念之前,我们先来回顾下事务相关的一些概念。 - 掘金)(终于有人把“TCC分布式事务”实现原理讲明白了! - JaJian - 博客园_)
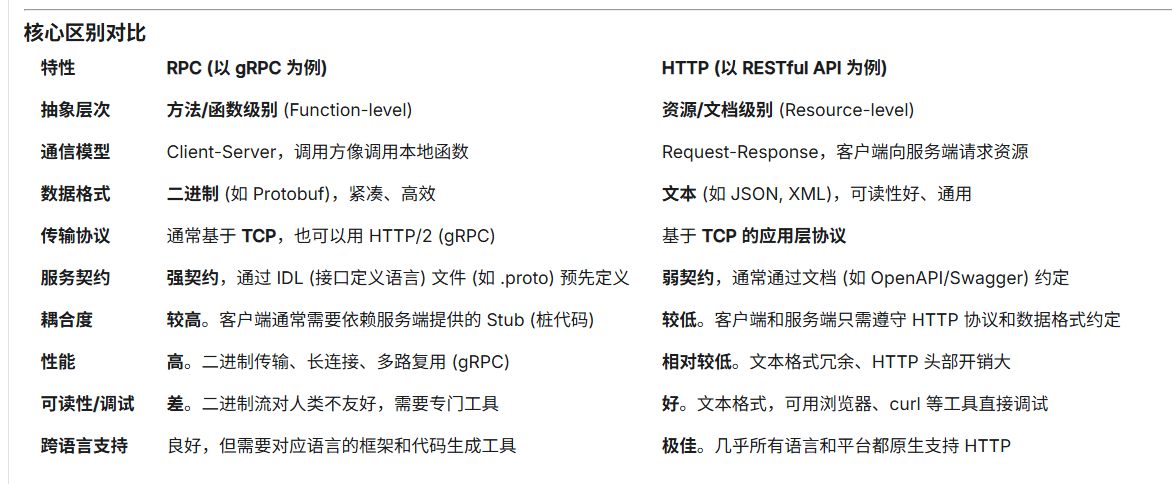
RPC和Http通信的区别,各自的优缺点(RPC 和 HTTP 理解,看完这一篇就够了 - 星火燎原智勇 - 博客园)
那现在有一个10g的大文件,里面存着不同的ip地址,你只有1g的内存,如何找出里面出现最多ip地址的top10?
ip地址的,可以先分批遍历一遍文件,按ip的哈希值取模分成100个文件,然后再维护每个文件的前10
TCP 连接复用,chrome 打开新的标签页会使用 TCP 连接复用吗
具体来说,Chrome 在处理新标签页的连接时,会根据不同的 HTTP 协议版本采取不同的策略:
- HTTP/1.1 环境下: Chrome 会为每个域名维护一个连接池,通常允许同时建立多个(例如 6-8 个)并行的 TCP 连接。当您打开一个新的标签页访问同一个域名时,Chrome 会从这个连接池中选取一个空闲的连接来发送请求,而不是重新创建一个新的连接。这大大提高了资源加载的并行度,缩短了页面整体加载时间。
- HTTP/2 环境下: HTTP/2 协议引入了“多路复用”(Multiplexing)这一关键特性,从根本上改变了连接管理的方式。在 HTTP/2 下,Chrome 只需要为每个域名建立一个单一的 TCP 连接,就可以在该连接上同时并发地处理多个请求和响应,而不会相互阻塞。当您打开一个新的标签页访问支持 HTTP/2 的网站时,新的请求会通过这个已经建立的连接以新的“流”(Stream)的形式发送,从而实现了更高效的连接利用和更低的延迟。
值得注意的是, 这种连接复用机制是针对同一域名(源)的。如果您在新标签页中访问的是一个完全不同的网站,那么 Chrome 还是需要为其建立一个新的 TCP 连接。此外,像 WebSocket 这样的特殊协议会独占一个连接,无法被其他 HTTP 请求复用。
总而言之,Chrome 浏览器通过先进的连接管理策略,包括在 HTTP/1.1下的连接池技术和在 HTTP/2 下的多路复用技术,有效地实现了 TCP 连接的复用。这使得在打开新的标签页访问相同网站时,能够获得更快的加载速度和更优的网络性能。
RabbitMq的实现原理
RabbitMQ 的底层基于 Erlang 语言和 AMQP 协议 实现。
它的核心架构非常灵活,引入了 Exchange(交换机) 这一层。生产者不直接对接队列,而是将消息发给交换机,由交换机根据路由规则分发到具体的队列。这实现了生产和消费的完全解耦。
在通信层面,它使用了 Channel(信道) 复用 TCP 连接,解决了频繁建连的开销。
在存储层面,它采用内存索引 + 磁盘日志的方式。对于持久化消息,会顺序写入磁盘;对于非持久化消息,优先存内存,内存不足时再换出到磁盘。这种设计保证了它在低延迟和高可靠性之间的平衡。
如何考虑一个消息队列的实现?有多少要注意的地方?
如果要设计一个消息队列(MQ),这是典型的系统设计题。你不能只说“收发消息”,必须从高可用、高性能、高可靠三个维度,全面考虑一个中间件该有的素养。
至少有 7 个核心注意点 需要考虑:
1. 通信协议 (Protocol)
- 问题:客户端和服务端怎么说话?
- 设计:
- TCP:必须要用长连接,避免频繁握手。
- 自定义协议:像 Kafka/RocketMQ 那样,设计一套紧凑的二进制协议(Header+Body),减少网络开销,支持多语言 SDK。
2. 消息存储 (Storage) —— 最核心
- 问题:消息存在哪?内存还是磁盘?
- 设计:
- 内存:快,但易丢(如 Redis Pub/Sub)。
- 磁盘:可靠,但慢。优化手段是 顺序写 (Sequential Write),像 Kafka 的 CommitLog 那样追加写入,速度接近内存。
- 索引:为了快速读,需要维护一个稀疏索引(如 ConsumeQueue),通过 Offset 快速定位文件位置。
如果要设计一个消息队列(MQ),这是典型的系统设计题。你不能只说“收发消息”,必须从高可用、高性能、高可靠三个维度,全面考虑一个中间件该有的素养。
至少有 7 个核心注意点 需要考虑:
1. 通信协议 (Protocol)
- 问题:客户端和服务端怎么说话?
- 设计:
- TCP:必须要用长连接,避免频繁握手。
- 自定义协议:像 Kafka/RocketMQ 那样,设计一套紧凑的二进制协议(Header+Body),减少网络开销,支持多语言 SDK。
2. 消息存储 (Storage) —— 最核心
- 问题:消息存在哪?内存还是磁盘?
- 设计:
- 内存:快,但易丢(如 Redis Pub/Sub)。
- 磁盘:可靠,但慢。优化手段是 顺序写 (Sequential Write),像 Kafka 的 CommitLog 那样追加写入,速度接近内存。
- 索引:为了快速读,需要维护一个稀疏索引(如 ConsumeQueue),通过 Offset 快速定位文件位置。
3. 高可用架构 (High Availability)
- 问题:机器挂了怎么办?
- 设计:
- 主从复制 (Replication):数据必须有多副本。
- 选主机制:Master 挂了,Slave 怎么上位?是用 Zookeeper/Raft 自动选主(Kafka),还是依赖 NameServer(RocketMQ)?
4. 消费模型 (Consumption Model)
- 问题:怎么给消费者?
- Push (推):实时性高,但容易压垮消费者。
- Pull (拉):消费者自己掌握节奏,适合批量拉取,但可能有延迟。
- 长轮询 (Long Polling):结合两者优点。消费者拉取,如果没消息,服务端挂起请求,等有消息了立马返回。
5. 可靠性保障 (Reliability)
- 问题:怎么保证不丢消息?
- 生产端:Ack 确认机制。
- 服务端:刷盘策略(同步刷盘 vs 异步刷盘)。
- 消费端:手动 Ack。
6. 高级特性 (Advanced Features)
- 延时队列:通过时间轮算法实现。
- 事务消息:支持分布式事务(两阶段提交 + 回查)。
- 死信队列:重试 N 次失败后隔离消息。
7. 零拷贝 (Zero-Copy) —— 性能杀手锏
设计:在读取消息发给消费者时,利用 sendfile 或 mmap 技术,直接把数据从磁盘文件拷贝到网卡,绕过 CPU 和用户态内存,极大提升吞吐量。
问题:机器挂了怎么办?
设计:
- 主从复制 (Replication):数据必须有多副本。
- 选主机制:Master 挂了,Slave 怎么上位?是用 Zookeeper/Raft 自动选主(Kafka),还是依赖 NameServer(RocketMQ)?
4. 消费模型 (Consumption Model)
- 问题:怎么给消费者?
- Push (推):实时性高,但容易压垮消费者。
- Pull (拉):消费者自己掌握节奏,适合批量拉取,但可能有延迟。
- 长轮询 (Long Polling):结合两者优点。消费者拉取,如果没消息,服务端挂起请求,等有消息了立马返回。
5. 可靠性保障 (Reliability)
- 问题:怎么保证不丢消息?
- 生产端:Ack 确认机制。
- 服务端:刷盘策略(同步刷盘 vs 异步刷盘)。
- 消费端:手动 Ack。
6. 高级特性 (Advanced Features)
- 延时队列:通过时间轮算法实现。
- 事务消息:支持分布式事务(两阶段提交 + 回查)。
- 死信队列:重试 N 次失败后隔离消息。
7. 零拷贝 (Zero-Copy) —— 性能杀手锏
- 设计:在读取消息发给消费者时,利用 sendfile 或 mmap 技术,直接把数据从磁盘文件拷贝到网卡,绕过 CPU 和用户态内存,极大提升吞吐量。
kafka怎么保证消息不丢失?同一消费组的三个消费者消费三个分区,如果有一个消费端挂了,其他消费者来消费,怎么保证不重复消费?这个时候消息id在哪
场景描述:一个 Topic 有 3 个 Partition(P0, P1, P2),消费组里有 3 个 Consumer(C0, C1, C2),正好一对一消费。突然,C2 挂了。
1. 发生了什么?(Rebalance 机制)
- 当 C2 挂掉(长时间未发送心跳)时,Kafka 集群的 Group Coordinator(组协调器) 会敏锐地察觉到。
- 它会触发一次 Rebalance(重平衡)。
- Rebalance 的结果是:原本由 C2 消费的 P2 分区,会被重新分配给存活的 C0 或 C1(比如分配给了 C0)。
2. 为什么会产生“重复消费”?
- 假设 C2 挂掉之前,已经从 P2 拉取了一批消息(Offset 100 到 150),并且业务逻辑已经处理到了 Offset 120。
- 但是!C2 还没来得及向 Broker 提交 Offset 120 就宕机了。
- Broker 那边记录的 P2 分区的最新消费位移依然是上一批提交的 Offset 100。
- 当 Rebalance 结束后,C0 接管了 P2 分区。C0 问 Broker:“我该从哪里开始消费 P2?” Broker 会告诉它:“从 Offset 100 开始”。
- 于是,C0 又把 100 到 120 的消息拉下来重新处理了一遍。这就是经典的、因 Consumer 宕机导致的重复消费场景。
3. 怎么保证不重复消费?(业务层面的幂等性设计)
敲黑板:Kafka 本身无法 100% 避免这种场景下的重复投递(它提供的是 At Least Once 语义)。解决重复消费的终极防线,必须落在业务代码的“幂等性(Idempotence)”设计上。
所谓幂等性,就是同一条消息,无论你处理 1 次还是 100 次,对业务系统的结果都是一样的。
敲黑板:Kafka 本身无法 100% 避免这种场景下的重复投递(它提供的是 At Least Once 语义)。解决重复消费的终极防线,必须落在业务代码的“幂等性(Idempotence)”设计上。
所谓幂等性,就是同一条消息,无论你处理 1 次还是 100 次,对业务系统的结果都是一样的。
面试真题
如果MQ因为网络等原因,发送消息延迟,如何优化?
“MQ 发送延迟是典型的生产问题,我的优化思路会遵循**‘端-架-网’(客户端-架构-网络)**三层递进的策略。
第一层,在客户端(Producer)层面做快速失败与容错。
我会强制要求设置一个严格的发送超时时间(比如 2 秒),并配置带指数退避的重试机制。对于非核心链路,坚决采用异步发送+回调的模式,让业务线程立即返回,不被网络 I/O 阻塞。
第二层,在业务架构层面做彻底解耦。
如果短暂的客户端优化扛不住持续的网络问题,我会引入**‘可靠事件模式’。即将消息先暂存到本地数据库的一张消息表里**,然后由一个独立的后台任务去异步轮询这张表,再慢慢地发送给远端的 MQ。这样,主业务流程的性能就和网络状况完全隔离了。同时,我会配合熔断器,在极端情况下对非核心的 MQ 发送逻辑进行降级。
MQ中的脏数据怎么处理?
在 MQ 的语境下,“脏数据”通常分为两类:
- 格式型脏数据(Poison Pill / 毒药消息): JSON 格式残缺、字段类型错乱(本来是 Long 传了 String),导致消费者在反序列化或解析时直接抛出异常。
- 业务型脏数据: 格式没问题,但违反业务规则(例如订单金额为负数、引用的 UserID 在数据库不存在),导致执行业务 SQL 时报错。
“处理 MQ 中的脏数据,我们的核心底线是绝对不能让脏数据引起无限重试,从而阻塞正常消息的消费(即防止毒药消息效应)。
我们的标准架构方案是建立死信队列(DLQ)机制。
- 在消费端,我们会使用全局 Try-Catch 捕获包括反序列化在内的所有异常。
- 当一条消息解析失败,或者业务处理重试达到上限(如 3 次)时,消费者会主动 ACK 这条消息使其脱离主队列,并将其原始 Payload 和异常堆栈一起投递到专门的死信队列中。
- 针对死信队列,我们会配置严格的监控告警。一旦出现死信,开发人员会收到钉钉告警。
- 我们内部有一个 MQ 死信排查控制台,开发人员可以在上面查看脏数据的原因。如果是数据个例,可以手工修改 Payload 后点击重发;如果是系统 Bug,我们会修复消费者代码兼容后,通过脚本将死信队列的数据批量重新投递回主队列完成补偿。
mq的消息持久化存储这个原理是啥
三、 消息持久化的核心原理是什么?(How)
虽然不同 MQ 的实现细节有差异,但其核心原理万变不离其宗,主要围绕着 “先落盘,再响应” 和 “高性能的磁盘 I/O 操作” 这两个关键点。
1. 核心流程:“先落盘,再响应”
这是一个保证消息不丢失的黄金法则。整个流程如下:
- 生产者(Producer)发送消息:生产者在发送消息时,通常会指定这条消息需要被持久化。
- MQ Broker 接收消息:Broker 收到消息后,并不会立即把它放到内存队列里就完事了。
- 写入持久化存储:Broker 会将消息写入到磁盘上的日志文件(Log File)或数据存储中。
- 返回确认(ACK):只有当消息成功写入磁盘后,Broker 才会向生产者发送一个确认(ACK),告诉生产者:“我已经收到并安全保存了你的消息”。
- 投递给消费者(Consumer):Broker 从持久化存储中读取消息(或直接从内存缓存),然后投递给消费者。
- 消费者确认消费:消费者处理完消息后,向 Broker 发送一个消费确认(ACK)。
- 更新状态:Broker 收到消费确认后,会将这条消息在存储中标记为“已消费”(具体是直接删除还是仅仅移动一个指针,取决于 MQ 的实现),从而释放存储空间。
关键点:如果在第 3 步写磁盘成功之前 Broker 宕机了,生产者因为没有收到 ACK,就会认为消息发送失败,从而进行重试。这样就保证了消息至少会被成功持久化一次。
2. 核心技术:如何实现高性能的磁盘写入?
你可能会问:每次都写磁盘,性能不会很差吗?毕竟磁盘 I/O 是出了名的慢。
优秀的 MQ 产品都采用了一系列优化技术来解决这个问题,主要有以下几种:
a. 顺序写(Sequential I/O)
- 原理:磁盘的性能瓶颈主要在于磁头的随机寻道(Random Access)。而顺序读写的速度非常快,甚至可以逼近内存的读写速度。
- 应用:像 Kafka 和 RocketMQ 这样的 MQ,它们的设计哲学就是将所有消息以 追加(Append-Only) 的方式写入一个或多个大的日志文件中。新消息总是写在文件的末尾,这是一个纯粹的顺序写操作,性能极高。它们不会去修改文件中间的某条消息。
b. 操作系统的页缓存(Page Cache)
- 原理:现代操作系统为了加速 I/O,并不会让应用程序的 write 操作直接写入物理磁盘。相反,数据会先被写入到内核空间的内存——页缓存(Page Cache) 中。这个过程非常快,几乎是纯内存操作。操作系统会后续通过一个后台线程(如 pdflush)将这些“脏页”异步地刷写(Flush)到物理磁盘上。
- 应用:MQ Broker 把消息写入文件,实际上是先写入了 Page Cache。对于 Broker 而言,写入操作瞬间完成,可以立即给生产者返回 ACK。这样既保证了高性能,又利用了操作系统的机制来保证数据最终会落盘。
c. 刷盘策略(Flush Strategy)
- 问题:只写入 Page Cache 还是有风险的。如果在数据从 Page Cache 刷到磁盘之前,整个服务器断电了,那么 Page Cache 中的数据就会丢失。
- 解决方案:MQ 提供了不同的刷盘策略,让用户在性能和可靠性之间做权衡。
- 同步刷盘(Synchronous Flush):每次消息写入 Page Cache后,立即强制调用 fsync 或 fdatasync 系统调用,强迫操作系统将数据从 Page Cache 写入物理磁盘。这种方式最可靠,但性能最差。适用于金融等对数据一致性要求极高的场景。
- 异步刷盘(Asynchronous Flush):写入 Page Cache 后就返回成功,由操作系统自行决定何时刷盘。这种方式性能最好,但断电时可能会丢失少量数据(Page Cache 中未刷盘的数据)。这是大多数场景下的默认选择。
- 定时或定量刷盘:比如“每写入 N 条消息后刷盘一次”或“每隔 T 秒刷盘一次”,是一种折中的方案。
Rabbit mq的队列是怎么实现的?
一、 宏观架构:队列在 RabbitMQ 中到底是个什么实体?
在 RabbitMQ 中,一个队列(Queue)并不是像 Java 里的 LinkedList 那样简单的一块内存,而是一个由 Erlang 语言实现的、独立的轻量级进程(Erlang Process)。
1. Actor 模型与 Erlang 进程
- 背景: RabbitMQ 是用 Erlang 语言写的。Erlang 采用了 Actor 并发模型,它的核心执行单元是“轻量级进程”(比操作系统的线程还要轻量级得多,一台机器上可以轻松跑几百万个 Erlang 进程)。
- 队列的本质: 每个 RabbitMQ 队列,本质上就是一个独立运行的 Erlang 进程(称为 Queue Process)**。
- 工作机制: 当有消息发送到这个队列时,实际上是给这个 Erlang 进程发了一条“异步消息”。这个进程拥有自己的状态(内存中的消息、元数据)和自己的邮箱(Mailbox),它按照单线程的模式串行处理收到的消息,以此保证队列内部消息的严格顺序性。
2. 队列的内部结构(职责拆分)
一个 Queue 进程为了高效运转,内部又分为几个核心组件(模块):
- Q1, Q2, Delta, Q3, Q4: 这是 RabbitMQ 为了平衡内存和磁盘而设计的 5 个内部状态区间。
- Q1, Q4: 完全在内存中的消息。
- Q2, Q3: 正在内存和磁盘之间换入换出的消息。
- Delta: 完全存放在磁盘上的消息。
- Backing Queue: 这是队列真正存放消息数据的底层数据结构,负责将消息在上述 5 个状态之间进行流转(比如当内存不足时,把 Q1 的消息降级存入磁盘变 Delta)。
二、 存储机制:消息是怎么存下来的?(内存 vs 磁盘)
队列的实现必须解决“持久化”和“内存溢出”的问题。RabbitMQ 针对这两点有精妙的设计。
1. 持久化机制 (Persistence)
如果队列声明为 durable=true,且消息标记为 delivery_mode=2(持久化),消息就会落盘。
- 存储引擎: RabbitMQ 并没有使用 MySQL 等关系型数据库,而是自己实现了一个极其高效的追加写入式(Append-Only)文件存储系统。
- 两个核心文件:
- Msg Store(消息存储): 所有队列共享。当消息比较大(默认 > 4096 字节)时,无论是否需要持久化,都会被写入这个统一的消息存储文件中。它分为 msg_store_persistent(持久化消息)和 msg_store_transient(非持久化但因内存不足被换出的消息)。
- Queue Index(队列索引): 每个队列独有。它记录了本队列中每一条消息在 Msg Store 中的物理偏移量(Offset)和状态。如果消息很小,为了极致性能,RabbitMQ 会直接把消息内容也塞进这个 Index 文件里。
2. 内存控制与 Paging (换页机制)
如果消费者罢工,队列里堆积了 1 亿条消息,RabbitMQ 会 OOM(内存溢出)吗?
- 答案:不会。 这得益于 RabbitMQ 优秀的 Paging(换页)机制。
- 当 Erlang 虚拟机的内存使用量达到配置的阈值(如物理内存的 40%)时,RabbitMQ 会触发内存告警。
- 此时,后台进程会疯狂地将内存中的消息(即便是非持久化的消息)换出(Page Out)到磁盘上,释放内存。只有当消费者真正需要消费时,才会把磁盘上的数据重新换入(Page In)内存。这个过程类似于操作系统的虚拟内存 Swap 机制。
Kafka如何保持高流量,高可用
1. 顺:顺序读写磁盘(Sequential I/O)
很多人有个误区,认为“写磁盘一定很慢,写内存才快”。其实不然。
- 磁盘的物理特性:磁盘慢是慢在“随机寻道”(磁头到处找地方写)。如果是顺序写(一直往文件末尾追加数据),普通的机械硬盘速度可以达到 600MB/s,甚至逼近内存的随机读写速度。
- Kafka 的做法:Kafka 的消息是以日志(Log)的形式存储的。生产者发来消息,Kafka 只做一件事:把消息追加(Append)到日志文件的末尾。它绝对不去修改之前的消息,也不去删除中间的消息。这种纯粹的顺序写,让它榨干了磁盘的性能。
- 比喻:就像写日记,你只在最后一页往下写,绝对不翻到前面去涂改,速度当然快。
2. 借:借用操作系统的页缓存(Page Cache)
Java 程序通常会把对象存在 JVM 堆内存里,但这会带来沉重的垃圾回收(GC)负担,而且内存有限。
- Kafka 的做法:Kafka 尽量不在 JVM 里缓存消息,而是直接把数据扔给操作系统的页缓存(Page Cache)。
- 操作系统的内核会接管这些内存,当你写入消息时,其实是写到了内存(Page Cache)里,内核会异步地把它们刷入磁盘。
- 当你读取消息时,如果正好在 Page Cache 里,就直接从内存读走,连磁盘都不用碰。
- 结果:Kafka 几乎是在享受纯内存级别的读写速度,同时又避免了 Java GC 带来的卡顿。
3. 零:零拷贝技术(Zero-Copy)
这正好呼应了你上一个问题!消费者来拉取消息时,Kafka 大量使用了零拷贝技术(sendfile 系统调用)。
- 传统方式:磁盘 -> 内核缓存 -> Kafka 应用程序 -> Socket 缓存 -> 网卡。中间经过多次 CPU 拷贝。
- Kafka 的做法:数据直接从操作系统的 Page Cache 发送到 网卡的 Socket 缓冲区。
- 结果:数据根本不经过 Kafka 这个 Java 应用程序的内部,极大地节省了 CPU 资源和内存带宽。CPU 只需要在一旁指挥,网络传输效率拉满。
4. 分:分区架构(Partition)—— 真正的水平扩展
- 如果一个 Topic(主题)所有的消息都挤在一台机器上,吞吐量必有上限。
- Kafka 将一个 Topic 拆分成多个 Partition(分区),分散在不同的机器(Broker)上。
- 结果:成百上千个生产者可以同时向不同的分区写数据,成百上千个消费者可以同时从不同的分区读数据。这是 Kafka 应对海量并发的架构基石。
零拷贝(Zero-Copy)
“面试官您好,所谓‘零拷贝’,其实是一个容易让人误解的词。它并不是指数据在计算机里完全不需要拷贝,而是指:在数据的传输过程中,彻底消除【CPU】参与的、在【内核空间】与【用户空间】之间不必要的数据搬运。它的核心目的是解放 CPU,并减少昂贵的上下文切换。”
一、 传统 I/O 的性能瓶颈
当应用程序通过网络发送磁盘文件时,传统方式调用 read() 和 write():
- DMA拷贝:磁盘 -> 内核页缓存(Page Cache)。
- CPU拷贝:内核页缓存 -> 用户缓冲区(User Buffer)。
- CPU拷贝:用户缓冲区 -> 内核 Socket 缓冲区。
- DMA拷贝:内核 Socket 缓冲区 -> 网卡(NIC)。
总开销:
- 4 次数据拷贝(2次 DMA 拷贝 + 2次 CPU 拷贝)。
- 4 次上下文切换(系统调用导致的 User-Kernel 状态切换)。
瓶颈:极大地浪费了 CPU 算力和内存带宽,特别是在高并发的文件分发场景下。
3. sendfile + SG-DMA (真正的零拷贝,Linux 2.4+)
- 原理:依赖支持 Scatter-Gather (分散-聚集) 功能的网卡 DMA 控制器。
- 流程:
- DMA 将数据从磁盘读到 Page Cache。
- CPU 不再搬运数据,仅将包含数据位置和长度的文件描述符追加到 Socket 缓冲区。
- SG-DMA 控制器根据描述符,直接从 Page Cache 读取数据发送到网卡。
- 性能提升:0 次 CPU 拷贝,2 次 DMA 拷贝,2 次上下文切换。达到性能理论极限。
RabbitMQ 的 Vhost 是做什么的?
如果打个比方,一个 RabbitMQ Server 就像是一台物理服务器,而 Vhost 就像是在这台服务器上划分出的一个个独立的虚拟机(或者像 MySQL 里的一个个 Database Schema)。
- 逻辑隔离 (Logical Isolation) - 绝对的核心作用**
kafka有啥特性相对于RabbitMq
1. 极致的吞吐量与性能 (Throughput) —— Kafka 的绝对统治区
这是 Kafka 最著名的标签,也是它在大数据领域不可替代的原因。
- RabbitMQ 的瓶颈: 它使用 Erlang 语言开发,为了保证消息的绝对可靠和复杂的路由计算,它的内存和 CPU 开销较大。单机吞吐量通常在万级/秒。
- Kafka 为什么快(百万级/秒)?
Kafka 放弃了复杂的路由逻辑,采用了极其硬核的底层优化:- 磁盘顺序写 (Sequential I/O): Kafka 不像传统数据库那样随机修改磁盘数据。所有的消息只会在文件末尾追加(Append-only)。在普通的机械硬盘上,顺序写的速度(可达 600MB/s)完全可以媲美甚至超越内存的随机写。
- 零拷贝技术 (Zero-Copy): 在消费者拉取数据时,Kafka 直接使用操作系统的 sendfile() 系统调用。数据直接从磁盘的 Page Cache 拷贝到网卡,全程不经过用户态的 JVM 内存,极大地节省了 CPU 资源和内存带宽。
- 批量发送 (Batching): 无论生产者还是消费者,Kafka 都是按批次(Batch)处理消息的,这极大地减少了网络 RPC 的开销。
2. 数据的持久化与可回溯性 (Retention & Replay) —— 截然不同的消费模型
- RabbitMQ(阅后即焚): 它采用的是**“推送模型 (Push)”。消息一旦被消费者成功消费(Ack),就会立即从队列中物理删除**。它就像一个水管,水流过去就没了。
- Kafka(持久化日志): 它采用的是**“拉取模型 (Pull)”**。Kafka 把所有的消息当成日志,持久化在磁盘上。
- 消息不删除: 消费者读取消息后,Kafka 绝对不会删除它。消息的生命周期只由配置的保留策略(如保留 7 天或保留 100GB)决定。
- 游标机制 (Offset): Kafka 只记录每个消费者组当前读到了哪个位置(Offset)。
- 核心优势(可回溯/Replay): 这意味着,如果你的下游消费者代码写出了 Bug,导致算错了昨天一整天的数据。在 Kafka 中,你只需要把消费者的 Offset 重置(Reset)到昨天零点,就可以把昨天的所有消息重新消费一遍。这在数据分析和排错时是无价之宝,而 RabbitMQ 根本做不到。
简单描述就是如果保证MQ在MQ层不丢失,不太会我只知道强行在生产者中写入硬盘,但是面试官说这是业务层,他想知道在MQ层的不丢失怎么,最后告诉我用Raft一致性算法(完全不了解)
“要保证 MQ 服务端不丢失消息,必须采用**高可用的集群架构,通过主从复制**模型实现数据冗余。
具体来说,当生产者将消息发送给 Leader 节点后,我们不能立即返回成功。而是需要 Leader 将消息同步复制给集群中的多个 Follower 节点。
为了确保这个复制过程的正确性和一致性,我们可以采用像 Raft 或 ZAB (ZooKeeper 使用的) 这样的共识协议。
在 Raft 协议的驱动下,只有当一条消息被成功复制到超过半数的节点,并被标记为‘已提交’状态后,MQ 服务端才会向生产者确认消息发送成功。
这样做的好处是,只要集群中还有超过一半的节点存活,即使原先的 Leader 节点宕机,系统也能通过选举机制,从拥有最新数据的 Follower 中选出一个新的 Leader,从而保证了已经确认成功的消息一条都不会丢失。”
#PDD
RabbitMQ是否会出现重复消息的投递的现象,就是消费完了
1. 最常见的场景:ACK 确认丢失 (The Lost ACK)
- 流程:
- 消费者从 RabbitMQ 成功拉取到消息。
- 消费者成功地处理完了业务逻辑(比如数据库操作成功了)。
- 消费者向 RabbitMQ 发送 basic.ack 确认信号。
- 致命时刻: 这个 ACK 信号在网络传输过程中丢失了,或者 RabbitMQ Broker 刚好在收到 ACK 的那一瞬间重启了。
- 后果: RabbitMQ 没有收到 ACK,它会单方面地认为:“这个消费者是不是处理失败了或者挂了?” 出于高可靠性的设计,它会在一段时间后,将这条已经被成功处理过的消息,重新投递给消费组里的另一个(或者同一个)消费者。重复消费就此产生。
2. 消费者“假死”与 Rebalance (The “Zombie” Consumer)
- 流程:
- 消费者拉取到消息,正在处理一个耗时较长的业务。
- 致命时刻: 在处理过程中,消费者所在的机器发生了严重的 Full GC 卡顿,或者网络连接暂时中断,导致它无法在心跳周期内向 RabbitMQ 发送心跳。
- 后果: RabbitMQ 会误以为这个消费者已经“死亡”。它会立刻将这条正在被“假死”消费者处理的消息,重新标记为可投递(Requeue),并将其分发给另一个健康的消费者。
- 结果: 过了一会儿,“假死”的消费者从 GC 中苏醒过来,继续处理完手里的任务并发送了 ACK。而另一边,新的消费者也处理完了同样的消息。重复消费再次发生。
3. 生产者端的重试机制 (Producer Retries)
- 流程:
- 生产者向 RabbitMQ 发送消息。
- RabbitMQ 成功接收并持久化了消息。
- 致命时刻: RabbitMQ 向生产者返回确认(Publisher Confirms)的途中,网络超时了。
- 后果: 生产者没有收到确认,它无法判断消息到底是没发出去,还是仅仅确认丢了。出于“宁可重发,不可丢失”的原则,生产者的重试机制会被触发,重新发送一模一样的消息。这就从源头上产生了重复。